[CloudNeta] Hands-On LLM Serving 3주차 part 1 - LLM 서빙의 최적화
이 글은 3주차 연재의 첫 번째 편입니다.
- part 1 - LLM 서빙의 최적화 (이 글)
- part 2 - LLM 핵심 최적화 기법
들어가며
5장에서는 LLM 추론의 핵심 병목지점을 살펴보고, 서비스마다 LLM 서빙이 "느린" 현상에 대해 리뷰합니다.
핵심 병목지점은 아래와 같습니다:
- 사용자 경험 병목: TTFT, 응답 지연이 커질수록 만족도가 떨어집니다
- 비용 병목: 추론 GPU 비용이 커지고, 모델 크기와 트래픽의 피크지점이 비용을 결정합니다
- 하드웨어 병목: GPU 연산, 메모리 대역폭, KV 캐시 메모리, 모델 로딩 등의 시간이 서빙 성능을 제한합니다
LLM 서빙이 "느린" 이유는 다음과 같이 분석할 수 있습니다:
- GPU VRAM 용량과 모델 간 상관관계
- 사용자 입력에 대한 Compute-bound 와 prefill 간 상관관계
- 모델 구동 시 decode 와 Memory Bandwidth-bound 간 상관관계
- 긴 Context/동시 사용자 증가 시 KV Cache 메모리 운용과의 상관관계
- Multi-GPU 활용 시 NVLink/NVSwitch/RDMA 같은 Interconnect 과의 상관관계
아래와 같이 도식으로 정리하였습니다.
flowchart TD
    A["LLM Serving"] --> L["① Model Loading"]
    A --> E["② Model Execution"]

    L --> L1["Model Weight"]
    L --> L2["KV Cache"]
    L --> L3["Activation / Workspace"]
    L1 --> LV["GPU VRAM 용량 문제"]
    L2 --> LV
    L3 --> LV

    E --> P["Prefill"]
    E --> D["Decode"]

    P --> P1["긴 Prompt
Matrix 연산 큼"]
    P1 --> P2["Compute-bound 가능"]

    D --> D1["Token 1개씩 생성"]
    D1 --> D2["Weight / KV Cache 반복 읽기"]
    D2 --> D3["Memory Bandwidth-bound"]

    P2 --> O["최적화 방향 결정"]
    D3 --> O
워크로드에는 항상 "TFLOPS 높은 GPU = 좋은 GPU"가 성립되지 않습니다.
적합한 워크로드인지 판단하여 비용효율적인 지점을 찾아봅시다.
LLM 서비스 최적화를 수행해야 하는 이유
ML 모델이 실제 운영 환경에서 빠르고 효율적으로 작동하도록 하는 것입니다. 이는 특히 하드웨어의 막대한 연산 능력과 메모리를 필요로 하는 LLM을 서비스하는 데 매우 중요합니다.
이들의 영향을 더 잘 이해하기 위해 주요 요인들을 세 가지 측면으로 분류합니다:
- 고객 체험 (Customer experience)
- 비용 효율성 (Cost efficiency)
- 확장성, 최대 부하 처리 능력, 그리고 실현 가능성 (Scalability, peak load handling, and feasibility)
고객 체험
느린 응답과 빠른 응답
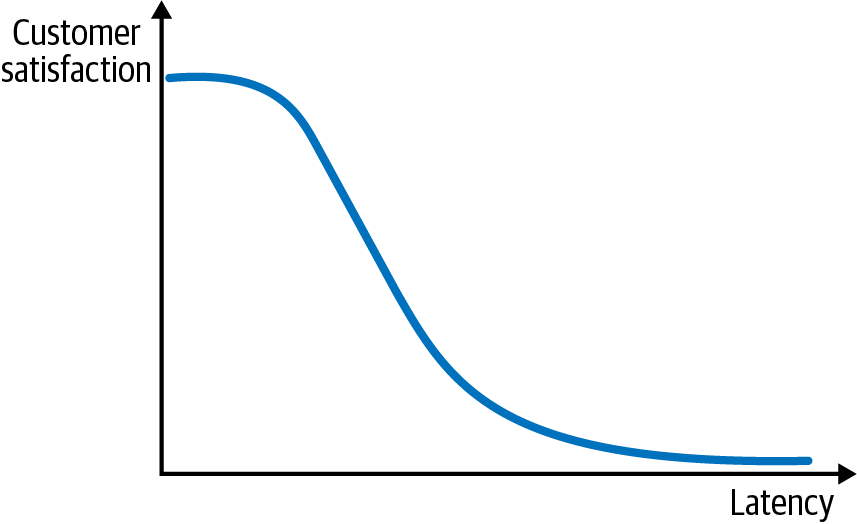
너무 느리면 고객이 싫어하고, 용납할 만한 지점에서는 고객이 좋아합니다.
하지만, 용납-충분을 넘어서는 지점 이상에서는 그 체감이 거의 없습니다. 아래 그래프는 지연시간과 고객 만족도 간의 관계를 살펴볼 수 있습니다. 그래프에 의거하면 어느 시점부터는 극적으로 감소되지만, 그 이후의 효용은 크게 늘어나지 않습니다.
생성 품질
같은 계열 또는 유사한 계열의 모델들 중에서, 일반적으로 더 큰 모델이 더 높은 품질의 응답을 생성합니다. 아래 그림은 Llama-3-70B와 Llama-3-8B의 model quality score 비교입니다(OpenLLM 리더보드 모델 비교 도구를 수정하여 작성). 큰 모델은 품질이 좋지만 지연과 비용이 커집니다. 반면 작은 모델은 빠르고 저렴하지만 품질이 낮을 수 있죠. 서빙 설계는 모델 품질과 지연/비용 간의 균형을 잘 찾아야 합니다.
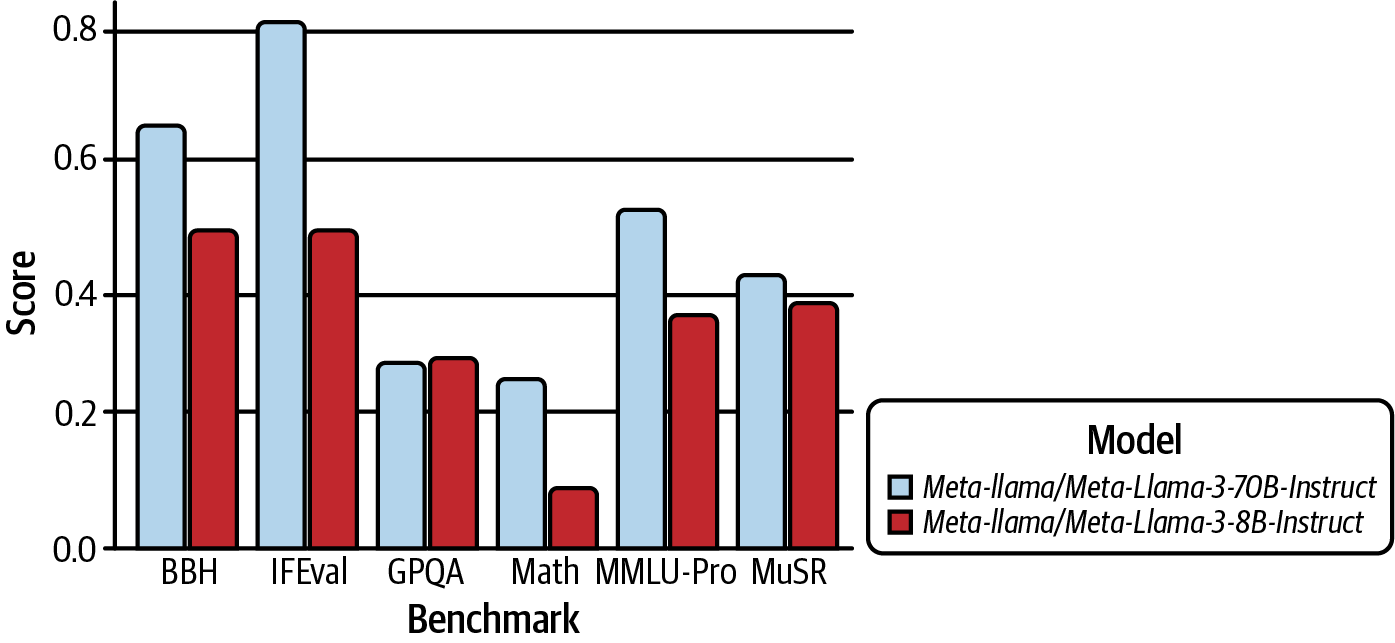
또한 최적화도 고려대상일 수 있습니다. 최적화가 없으면 지연 시간 요구사항을 맞추기 위해 80억 개 파라미터 모델로 제한될 수도 있습니다. 하지만 전체 모델 서빙 시스템을 대대적으로 최적화한 후에는, 320억 또는 700억 개의 파라미터를 가진 모델을 활용하면서도 동일한 하드웨어 환경에서 같은 지연 시간과 처리량을 달성할 수 있었습니다. 이는 응답 품질을 크게 향상시킬 수 있습니다.
비용 효율성
결국 비용효율을 생각하지 않을 수 없습니다. 우선 AI 모델 운용은 아시다시피 크게 두 분류로 갈립니다. 바로 훈련과 추론인데요. 훈련은 일회성 선투자 후에는 이따금씩 재훈련, 파인튜닝을 수행하지만 추론 배포이후 모든 쿼리와 상호작용마다 계속 발생하며, 사용량이 늘 수록 누적됩니다. 또한 AI 에이전트와 복잡한 워크플로우가 함께 엮이게 되면 여러 LLM, 임베딩 모델을 호출하게되어 추론비용이 더욱 올라갑니다.
따라서 지속적으로 발생하는 추론 비용을 제어할 수 있어야 하며, 효율적인 모델 서빙을 통해 AI 비즈니스의 재무적 생존을 꾀해야 합니다. 동일한 하드웨어를 사용하고 비슷한 지연 시간을 달성하면서도 LLM 서비스를 최적화하면, 기업은 더 많은 처리량을 확보해 동시에 더 많은 고객을 서비스할 수 있습니다. 이로 인해 서빙 시스템을 수평 확장할 때 하드웨어 사용량이 줄어들어 상당한 비용절감 효과를 얻을 수 있게 됩니다.
서빙 성능제한 요소
현재 GPU 공급이 제한된 환경에서는 고객 경험과 비용뿐 아니라, 트래픽 증가에 맞춰 시스템을 확장할 수 있는지도 함께 고려해야 합니다. 추론 최적화는 GPU당 처리량을 높이고 선택 가능한 하드웨어의 범위를 넓혀, 서비스의 확장성과 사업적 실현 가능성을 좌우합니다.
확장성
모델이 프로덕션에 배포된 이후에는 고객과 요청량이 늘어날수록 필요한 GPU도 증가합니다. 이때 GPU당 처리량이 낮으면 고객 증가에 맞춰 많은 장비를 추가해야 하므로 비용과 인프라 확보 부담이 빠르게 커집니다.
추론을 최적화하면 동일한 하드웨어에서 더 많은 요청을 처리할 수 있어, 더 적은 GPU로 서비스 규모를 확장할 수 있습니다. 반면 모델이 단일 GPU에 올라가지 않을 정도로 크다면 텐서 병렬화나 다중 노드 서빙이 필요하며, 이 경우 GPU 간 통신과 인터커넥트 성능이 새로운 병목이 될 수 있습니다.
최대 부하처리
LLM 서빙의 한계는 평균 트래픽보다 피크 트래픽에서 뚜렷하게 드러납니다. 예를 들어 평소에는 안정적으로 운영되던 영업 에이전트도 블랙프라이데이에는 요청량이 400% 이상 증가할 수 있습니다. 최적화가 부족한 시스템은 이러한 급증을 따라가지 못해 큐가 길어지고, 응답 지연과 요청 실패가 발생할 수 있습니다.
피크 부하에 안정적으로 대응하려면 모델 레플리카 수, GPU 메모리 사용량, 요청 큐, 오토스케일링 정책, 신규 인스턴스의 콜드 스타트 시간을 함께 고려해야 합니다. 충분한 여유 용량을 확보하는 것뿐 아니라 실제 트래픽 패턴을 반영한 부하 테스트와 반복적인 튜닝도 필요합니다.
실현성(Feasibility)
고성능 GPU는 클라우드를 이용하더라도 모든 리전에서 항상 확보할 수 있는 것은 아닙니다. 특정 GPU에서만 실행할 수 있는 시스템은 장비 수급이나 리전 제약으로 인해 새로운 시장에 배포하기 어려울 수 있습니다.
양자화와 메모리 최적화 등을 적용해 모델을 저사양 GPU에서도 실행할 수 있게 만들면 선택 가능한 하드웨어와 배포 지역이 늘어납니다. 따라서 추론 최적화는 단순한 성능 개선을 넘어, 실제로 확보할 수 있는 하드웨어에서 요구 처리량과 지연시간을 만족할 수 있는지를 결정합니다. 이는 글로벌 서비스 확장과 AI 비즈니스의 실현 가능성에 직접적인 영향을 미칩니다.
LLM 서빙에서 가속기 칩의 역할
LLM 최적화의 중요성을 이해했다면, 다음 단계는 LLM을 구동하는 하드웨어(가속기 칩)를 이해하는 것입니다. 적절한 가속기(GPU) 구성 선택은 LLM 서빙에서 가장 중요한 결정 중 하나인데, 하드웨어 제약이 메모리 용량·연산 성능·효율성을 결정하기 때문입니다.
이번 내용은 NVIDIA GPU를 주로 살펴보며, NVIDIA의 GPGPU(범용 GPU 컴퓨팅) 솔루션에 대해 살펴보고 LLM과 연관있는 속성을 살펴보겠습니다. 이는 각각 GPU 연산 성능(compute power), 메모리 용량(memory capacity), 메모리 대역폭(memory bandwidth), 인터커넥트(interconnects) 입니다.
해당 개념들을 살펴보고난 후그 외 AI 가속기와 동향에서 다른 AI 칩에 대해 살펴봅시다.
GPU 스펙 분석법
GPU 스펙은 다음 네 그룹으로 나누어 살펴볼 수 있습니다.
- 연산 성능(Compute)
- FLOPS·TOPS, Tensor Core 성능, 지원 정밀도를 확인합니다. 이 수치들은 행렬 곱셈과 Attention·MLP 연산의 최대 처리량을 보여줍니다.
- prefill과 훈련은 연산 성능의 영향을 많이 받습니다. 배치가 작은 디코드는 메모리 대역폭의 영향을 더 많이 받을 수 있습니다.
- 메모리(Memory)
- VRAM 용량은 모델 가중치, KV 캐시, 활성화 값과 임시 작업 공간을 얼마나 저장할 수 있는지를 결정합니다.
- 메모리 대역폭은 저장된 데이터를 연산 장치로 읽어오는 속도입니다. LLM 서빙에서는 용량과 대역폭을 함께 확인해야 합니다.
- 인터커넥트(Interconnect)
- PCIe, NVLink, NVSwitch는 한 노드 안의 GPU 사이에서 활성화 값, 부분 연산 결과와 동기화 데이터를 전달합니다.
- 여러 노드에 모델을 분산하면 InfiniBand, RoCE와 GPUDirect RDMA의 성능도 중요해집니다. 노드 간 구성은 통신 지연과 운영 복잡성이 더 큽니다.
- 전력 소비(Power Consumption)
- TDP는 GPU 한 장에 필요한 전력 공급과 냉각 설계의 기준입니다. 서버와 랙의 전력·냉각 용량은 설치 가능한 GPU 수를 제한합니다.
- 용량 계획에서는 GPU 가격, 전력, 랙 밀도, 냉각, 사용률과 와트당 처리량을 함께 계산합니다.

피자가게에 비유하면?
이해하기 쉽게 GPU 한 장을 피자 가게의 주방이라고 생각해봅시다. 목표는 최대한 많은 손님에게 빨리 피자를 내주는 것입니다.
이를 달성하기 위해선 반죽을 넉넉히 보관할 냉장고가 있어야 하고, 그 반죽을 오븐까지 빠르게 날라야 하고, 오븐 자체도 화력이 좋아야 합니다. 주방을 여러 개 두려면 주방 사이를 오갈 통로가 필요하고, 애초에 건물의 전기 계약 용량이 주방을 몇 개까지 놓을 수 있는지를 정합니다.

위의 그림으로 나타낸 내용을 표로 다시 보시죠.
| GPU 요소 | 피자 가게 비유 | 의미 |
|---|---|---|
| 서버 한 대(노드) | 가게 건물 | 여러 GPU를 설치하는 물리적 단위입니다. H100 기반 시스템은 주로 한 노드에 최대 8개 GPU를 구성합니다. |
| GPU 한 장 | 주방 | 모델의 연산과 데이터 처리를 담당합니다. 여러 GPU가 작업을 나누어 처리할 수 있습니다. |
| GPU 메모리(VRAM) | 냉장고 | 모델 가중치와 KV 캐시를 저장합니다. 용량이 부족하면 OOM이 발생합니다. |
| 메모리 대역폭 | 재료 운반 라인 | GPU 메모리의 데이터를 연산 장치로 전달합니다. 디코드 성능에 큰 영향을 줍니다. |
| 연산 성능(TFLOPS·TOPS) | 오븐 | 행렬 곱셈을 처리하는 속도입니다. prefill과 훈련 성능에 큰 영향을 줍니다. |
| 인터커넥트 | 주방 사이 통로 | PCIe, NVLink, NVSwitch를 통해 GPU 사이의 데이터를 전달합니다. |
| 전력·냉각 예산 | 전기 계약 용량 | GPU의 TDP와 서버·랙의 전력 용량이 설치 가능한 GPU 수를 제한합니다. |
| 동시 요청 | 손님 줄 | 요청이 처리 속도보다 빠르게 들어오면 대기열과 응답 지연이 증가합니다. |
| 처리량 | 픽업 카운터 | 일정 시간에 생성하는 토큰 수이며, 주로 초당 토큰 수(tokens/s)로 측정합니다. |
H100 SXM과 H100 NVL의 비교분석
이번 문단에서는 NVIDIA H100 SXM과 H100 NVL의 사양을 비교하며 GPU 스펙을 읽는 방법을 살펴봅니다. GPU 사양을 이해하면 LLM 추론과 훈련에 필요한 하드웨어를 선택하고 성능 병목을 예상할 수 있습니다.
H100 NVL의 메모리 용량은 GPU 1개 기준입니다. NVLink Bridge로 GPU 2개를 연결하면 총 188GB의 HBM3 메모리를 사용할 수 있습니다. 각 GPU의 메모리는 독립되어 있으므로 모델을 두 GPU에 분산하는 소프트웨어 구성이 필요합니다.
| 항목 | H100 SXM | H100 NVL |
|---|---|---|
| FP64 | 34 TFLOPS | 30 TFLOPS |
| FP64 Tensor Core | 67 TFLOPS | 60 TFLOPS |
| FP32 | 67 TFLOPS | 60 TFLOPS |
| TF32 Tensor Core* | 989 TFLOPS | 835 TFLOPS |
| BFLOAT16 Tensor Core* | 1,979 TFLOPS | 1,671 TFLOPS |
| FP16 Tensor Core* | 1,979 TFLOPS | 1,671 TFLOPS |
| FP8 Tensor Core* | 3,958 TFLOPS | 3,341 TFLOPS |
| INT8 Tensor Core* | 3,958 TOPS | 3,341 TOPS |
| GPU 메모리 | 80GB | 94GB |
| GPU 메모리 대역폭 | 3.35TB/s | 3.9TB/s |
| 최대 TDP | 최대 700W | 350~400W |
| 폼팩터 | SXM | PCIe 듀얼 슬롯, 공랭 |
| 인터커넥트 | NVLink 900GB/s, PCIe Gen5 128GB/s | NVLink 600GB/s, PCIe Gen5 128GB/s |
* 별표가 붙은 Tensor Core 수치는 희소성을 적용한 이론적 최대 성능입니다. INT8 정수 연산 성능의 단위는 TOPS입니다.
출처: NVIDIA H100 공식 사양, NVIDIA H100 NVL Product Brief
그렇다면, 두 장비가 각각 어떤 부분에서 이점을 지니는지를 살펴보죠.
Compute 측면
FLOPS(Floating-point Operations Per Second)는 GPU가 1초 동안 수행할 수 있는 부동소수점 연산 횟수입니다. Tera는
FP64, FP32, TF32, BF16, FP16, FP8은 각각 데이터 정밀도를 나타냅니다. LLM 훈련과 추론에서는 BF16, FP16, FP8 같은 저정밀도(low precision) 포맷을 주로 사용합니다. 데이터 크기가 작을수록 메모리 사용량과 전송량이 줄고 Tensor Core[1]의 처리량도 높아집니다.
다음 그림은 H100 SXM과 H100 NVL의 정밀도별 이론적 최대 처리량을 비교합니다.

연산 성능은 H100 SXM이 높습니다. 큰 행렬 연산이 많은 prefill과 훈련 작업에서 유리합니다. 디코드 단계는 토큰을 순차적으로 생성하면서 모델 가중치와 KV 캐시를 반복해서 읽기 때문에, 배치가 작을수록 메모리 대역폭의 영향을 많이 받습니다.
예시로 살펴봅시다. H100 SXM의 FP16 Tensor Core 성능은 희소성을 적용했을 때 최대 TFLOPS 이기 때문이죠. 같은 조건에서 FP8의 최대 처리량은 TFLOPS입니다.
단, 실제 성능은 모델의 정밀도 지원 여부, Tensor Core 활용률, 배치 크기, 메모리와 통신 병목에 따라 달라지기 때문에 비즈니스에 알맞은 테스트는 필수입니다.
메모리 측면
GPU 메모리는 용량과 대역폭으로 구분해 살펴봅니다.
- 메모리 용량은 모델 가중치, KV 캐시, 활성화 값과 임시 작업 공간을 저장할 수 있는 크기입니다.
- 메모리 대역폭은 저장된 데이터를 GPU 연산 장치로 전달하는 속도입니다.
반면 H100 NVL은 메모리와 대역폭에서 이점을 가집니다. 큰 모델과 긴 컨텍스트를 처리하거나 메모리 사용량이 많은 디코드 작업에서는 H100 NVL의 메모리 사양이 유리할 수 있습니다. H100 NVL은 GPU당 94GB의 메모리와 3.9TB/s의 대역폭을 제공합니다. H100 SXM은 80GB와 3.35TB/s를 제공합니다.
아래 그림은 Llama-3-70B를 FP8로 배치한다고 가정해 두 GPU의 메모리 여유 공간과 대역폭을 비교한 단순화된 예시입니다. 실제 필요 용량은 양자화 메타데이터, 엔진 작업 공간, 배치와 KV 캐시 형식에 따라 달라집니다.

디코드 단계에서는 새로 생성한 K와 V를 캐시에 추가하고, 저장된 K와 V를 다음 토큰 생성에 사용합니다.

이 과정은 컨텍스트가 길어질수록 더 많은 KV 캐시 공간을 사용합니다. 저장된 가중치와 KV 캐시를 빠르게 읽어야 하므로 메모리 대역폭도 토큰 생성 속도에 영향을 줍니다.
앞의 피자 가게 비유에서 냉장고, 재료 운반 라인, 오븐의 관계를 다시한 번 살펴봅시다.
| GPU 요소 | 피자 가게 비유 | LLM에서의 역할 |
|---|---|---|
| 메모리 용량 | 냉장고 크기 | 모델 가중치와 KV 캐시 저장 |
| 메모리 대역폭 | 재료 운반 속도 | 저장된 데이터를 연산 장치로 전달 |
| 연산 성능 | 오븐의 조리 속도 | 행렬 곱셈과 Attention 연산 처리 |
앞서 말씀드렸듯 어느 한 요소라도 부족하면 다른 자원은 대기합니다. 디코드는 메모리 대역폭의 영향을 자주 받고, 긴 프롬프트의 prefill은 연산 성능의 영향을 많이 받습니다.

따라서 워크로드에 맞는 연산 성능, 메모리 용량, 메모리 대역폭의 조합을 선택해야 합니다.
인터커넥트 측면
GPU 인터커넥트는 여러 GPU가 데이터를 교환하는 통신 경로입니다. 하나의 서버 안에서 GPU를 연결하는 인트라 노드(intra-node) 인터커넥트와 서로 다른 서버를 연결하는 인터 노드(inter-node) 인터커넥트로 구분합니다.
모델이 한 GPU에 들어가지 않거나 여러 GPU가 하나의 요청을 함께 처리할 때 인터커넥트 성능이 중요해집니다. GPU 사이에서 활성화 값과 부분 연산 결과, 동기화 데이터를 계속 교환하기 때문입니다.
Intra-node 인터커넥트
폼팩터는 GPU가 서버에 장착되는 방식을 결정합니다.
- SXM은 전용 베이스보드에 장착됩니다. 높은 전력 공급과 고성능 냉각, NVLink·NVSwitch 구성을 지원합니다.
- PCIe GPU는 일반 PCIe 슬롯에 장착할 수 있어 서버 호환성이 좋습니다.
- NVLink는 GPU 사이의 고속 데이터 전송 경로입니다.
- NVSwitch는 여러 NVLink GPU를 하나의 통신 패브릭으로 연결합니다.
| 구성 | GPU 간 연결 | 연결 범위 | 최대 표기 대역폭 |
|---|---|---|---|
| H100 PCIe 기본 구성 | PCIe Gen5 | 서버의 PCIe 토폴로지 | 128GB/s |
| H100 NVL | NVLink Bridge | 인접한 GPU 2개 | 600GB/s |
| H100 SXM 기반 HGX·DGX | NVLink + NVSwitch | 최대 8개 GPU | GPU당 900GB/s |

H100 PCIe 기본 구성은 GPU 간 통신에 PCIe를 사용합니다. 각 GPU가 독립적인 모델 복제본을 실행하는 구성에 적합합니다. H100 PCIe는 인접한 두 GPU를 연결하는 NVLink Bridge도 지원할 수 있으며, 실제 지원 여부는 서버 구성에 따라 달라집니다.
H100 NVL은 두 PCIe GPU를 NVLink Bridge로 연결해 최대 600GB/s의 GPU 간 대역폭을 제공합니다. 두 GPU에 모델을 분산하는 구성에서 PCIe 통신보다 높은 성능을 제공합니다. 하나의 브리지는 GPU 2개를 연결하므로, 4-GPU 서버에서도 네 GPU가 하나의 NVLink 패브릭으로 묶이지는 않습니다.
H100 SXM은 HGX H100과 DGX H100에서 NVSwitch와 함께 구성할 수 있습니다. DGX H100은 H100 GPU 8개와 NVSwitch 4개를 사용하며 각 GPU에 최대 900GB/s의 양방향 NVLink 대역폭을 제공합니다. NVSwitch는 모든 GPU가 같은 패브릭을 통해 통신할 수 있게 합니다.
900GB/s는 GPU 하나가 NVLink 패브릭을 통해 송수신할 수 있는 전체 양방향 대역폭입니다. GPU 쌍(pair) 별 전용 대역폭을 나타내는 값은 아닙니다. 따라서 900÷7로 GPU 쌍마다 고정 대역폭을 할당하는 계산은 실제 NVSwitch 구조와 맞지 않습니다.
NVSwitch는 텐서 병렬화와 대규모 집합 통신처럼 GPU 간 데이터 이동이 많은 작업에 적합합니다. 각 GPU가 독립적인 모델을 실행하는 서비스에서는 PCIe 구성이 더 경제적일 수 있습니다.
Inter-node 인터커넥트
H100 기반 서버는 주로 한 노드에 최대 8개의 GPU를 구성합니다. LLM 서빙에서는 모델 인스턴스를 단일 노드의 1~8개 GPU에 배치하고, 트래픽 증가에 맞춰 같은 구성의 모델 복제본을 추가하는 방식이 일반적입니다.
모델이 한 노드의 메모리에도 들어가지 않으면 여러 노드에 걸쳐 모델을 샤딩해야 합니다. 이때 InfiniBand나 RoCEv2 같은 고속 네트워크와 GPUDirect RDMA를 사용합니다. GPUDirect RDMA는 네트워크 장치와 GPU 메모리 사이에 직접 데이터 경로를 제공해 CPU를 거치는 복사 작업을 줄입니다.
| 통신 구성 | 최대 표기 대역폭 |
|---|---|
| 노드 내부 H100 SXM NVLink·NVSwitch | GPU당 900GB/s |
| 노드 내부 H100 NVL NVLink Bridge | 600GB/s |
| 노드 내부 PCIe Gen5 | 128GB/s |
| 노드 간 NDR 400Gb/s InfiniBand 단일 포트 | 약 50GB/s |

NDR 400Gb/s를 바이트 단위로 환산하면 약 50GB/s입니다. 이 값은 단일 포트의 이론상 속도일 뿐, 실제 처리량에는 프로토콜 오버헤드와 네트워크 토폴로지, NIC 수가 영향을 줍니다.
노드 간 통신은 텐서 병렬화, 파이프라인 병렬화, MoE의 전문가 병렬화, prefill·디코드 분리형 서빙에 사용됩니다. 노드 수가 늘면 통신 지연과 운영 복잡성도 커지므로 단일 노드 구성을 먼저 최적화하는 것이 좋습니다.
전력소비 측면
GPU 전력은 보통 와트(
H100 SXM의 최대 TDP는 700W입니다. H100 NVL은 GPU당 350~400W이며, 2-GPU 구성에는 GPU 기준 약 700~800W가 필요합니다. 전력 효율은 실제 워크로드의 처리량과 소비 전력을 함께 측정해 비교합니다.
배포 환경에 따라 전력 제약의 영향이 달라집니다.
- 일반 클라우드 사용자는 인스턴스 타입과 사용 시간에 따라 비용을 지불합니다. 전력 비용은 인스턴스 가격과 가용성에 반영됩니다.
- 클라우드 제공업체와 프라이빗 데이터센터는 랙의 전력과 냉각 용량에 맞춰 GPU 수를 결정합니다. 이 환경에서는 와트당 처리량이 중요합니다.
- 엣지와 온디바이스 시스템은 배터리, 발열, 소음과 폼팩터의 제약을 받습니다. 모델 크기와 정밀도, 실행 방식도 전력 효율을 중심으로 결정됩니다.
전력 사양은 GPU의 배치 밀도와 냉각 요구사항, 지속 가능한 처리량을 결정합니다.
GPU 선택은 결국 "서빙하려는 모델이 그 GPU의 향상된 성능이나 특정 기능(예: FP8 지원, NVLink)으로부터 실제로 이득을 보는가?"에 달려 있습니다.
LLM 모델 로딩의 병목
이어서 모델 로딩의 병목현상에 대해 살펴보겠습니다. 모델이 왜 GPU 메모리에 상주(host)해야하는지, GPU 메모리를 소모하는 요인은 무엇인지, 그리고 주어진 모델과 워크로드에 대해 GPU 메모리 요구량을 추정하는 방법에 대해 살펴봅니다.
모델 로딩 프로세스
효율적인 LLM 서빙은 모델 가중치를 스토리지에서 읽어 GPU 메모리에 배치하는 작업부터 시작합니다. 일반적인 로딩 경로에서는 가중치가 원격 또는 로컬 스토리지에서 CPU 메모리로 이동한 뒤 GPU 메모리로 복사됩니다.

모델 로딩 시간에는 여러 구간이 영향을 줍니다.
- 원격 스토리지 다운로드: 네트워크를 통해 모델 체크포인트를 가져옵니다.
- 스토리지 I/O: SSD에서 가중치 파일을 읽습니다.
- CPU 메모리 복사: 읽은 데이터를 시스템 메모리의 버퍼에 배치합니다.
- CPU와 GPU 사이의 전송: PCIe와 같은 인터커넥트를 통해 가중치를 GPU 메모리로 복사합니다.
- GPU 메모리 할당: 가중치, 런타임 버퍼와 KV 캐시에 필요한 공간을 확보합니다.
- 초기화와 워밍업: 모델 구조를 준비하고 필요한 커널을 컴파일하거나 워밍업합니다.
각 구간의 처리 속도와 모델 파일의 크기가 전체 로딩 시간을 결정합니다. 원격 스토리지와 네트워크, SSD, CPU 메모리, PCIe 중 가장 느린 구간이 병목이 되기 쉽습니다.
일반적인 경로는 CPU 메모리를 중간 버퍼로 사용합니다. GPUDirect Storage를 지원하는 구성에서는 스토리지와 GPU 메모리 사이에 직접 데이터 경로를 만들 수 있습니다. 이 방식은 CPU 메모리를 거치는 추가 복사를 줄여 로딩 대역폭과 CPU 사용량을 개선합니다.
가중치를 GPU 메모리에 유지하는 이유
로딩이 끝나면 가중치는 GPU 메모리에 상주하며 들어오는 요청을 처리합니다. CPU 메모리는 주로 범용 DRAM을 사용하며, 큰 용량과 일반적인 데이터 접근에 적합합니다. GPU 메모리는 높은 대역폭을 제공하는 HBM을 사용해 대규모 병렬 연산에 필요한 데이터를 빠르게 공급합니다.
추론을 실행할 때 각 Transformer 계층은 자신이 사용하는 가중치를 HBM에서 읽어 행렬 연산을 수행합니다. 디코드 단계에서는 새 토큰을 생성할 때마다 전체 계층을 다시 통과하므로 가중치 읽기도 반복됩니다. 배치를 키우면 한 번 읽은 가중치로 여러 요청의 토큰을 함께 처리할 수 있어 GPU 메모리 대역폭을 더 효율적으로 사용할 수 있습니다.
CPU 오프로딩을 사용하면 일부 가중치를 시스템 메모리에 보관할 수 있습니다. 이 구성은 실행에 필요한 계층을 GPU 메모리로 계속 옮겨야 하므로 전송 지연이 발생합니다. 저지연 프로덕션 서빙에서는 실행에 필요한 가중치를 GPU 메모리에 상주시켜 이 전송을 줄입니다.
단일 GPU로 모델을 서빙하려면 모델 가중치와 런타임 메모리가 해당 GPU에 들어가야 합니다. 멀티 GPU 구성에서는 가중치를 여러 GPU에 나누지만, 각 가중치 조각은 실행을 담당하는 GPU의 메모리에 상주합니다.
데이터 계층별 대역폭 비교
다음 그림은 각 계층의 성능 차이를 보여주는 대표 사양입니다. SSD는 순차 읽기 속도, CPU 메모리는 소켓당 이론적 대역폭, GPU 메모리는 HBM 사양을 사용했습니다. 막대 길이는 4TB/s를 기준으로 한 선형 스케일입니다.

출처: Samsung 870 EVO 데이터시트, Samsung 9100 PRO 브로슈어, AMD EPYC 9004 데이터시트, NVIDIA H100 사양
실제 모델 로딩 속도는 파일 형식, 스토리지 구성, 네트워크, NUMA 토폴로지, PCIe 경로와 로딩 소프트웨어에 따라 달라집니다. 표의 수치는 계층별 규모를 비교하기 위한 하드웨어 사양입니다.
GPU 연산 장치가 가중치를 빠르게 사용하려면 높은 HBM 대역폭과 충분한 GPU 메모리 용량이 필요합니다. 다음 절에서는 모델 가중치와 KV 캐시가 GPU 메모리를 얼마나 사용하는지 살펴봅니다.
모델 크기 추정하기
모델 가중치의 크기를 추정할 때 필요한 값은 파라미터 개수와 가중치 정밀도입니다. 파라미터 개수는 모델 이름이나 모델 카드에서, 기본 정밀도는 Hugging Face 저장소의 config.json에 있는 torch_dtype에서 확인할 수 있습니다. 양자화하거나 다른 형식으로 변환한 모델은 실제 체크포인트의 정밀도를 확인해야 합니다.
| 정밀도 | 파라미터당 크기 |
|---|---|
| FP32 | 4바이트 |
| FP16·BF16 | 2바이트 |
| FP8·INT8 | 1바이트 |
가중치 메모리는 다음과 같이 계산합니다.
파라미터 개수 × 파라미터당 바이트 수 = 가중치 메모리
예를 들어 Llama 2 7B의 가중치를 FP16이나 BF16으로 저장하면 약 70억 × 2바이트 = 140억 바이트, 즉 14GB가 필요합니다. 실제 Llama 2 7B 모델 저장소의 가중치 파일도 약 13.5GB로 이 추정치와 비슷합니다.
이 계산은 모델 가중치만 포함합니다. 실제 서빙에 필요한 GPU 메모리를 구하려면 KV 캐시, 활성화 값과 런타임 작업 공간도 더해야 합니다.
KV 캐시 추정하기
모델이 GPU에 들어가더라도 남은 메모리가 적으면 긴 컨텍스트와 여러 요청을 동시에 처리하기 어렵습니다. 디코드 과정에서 이전 토큰의 K와 V를 재사용하기 위해[2] KV 캐시를 GPU 메모리에 저장하기 때문입니다.
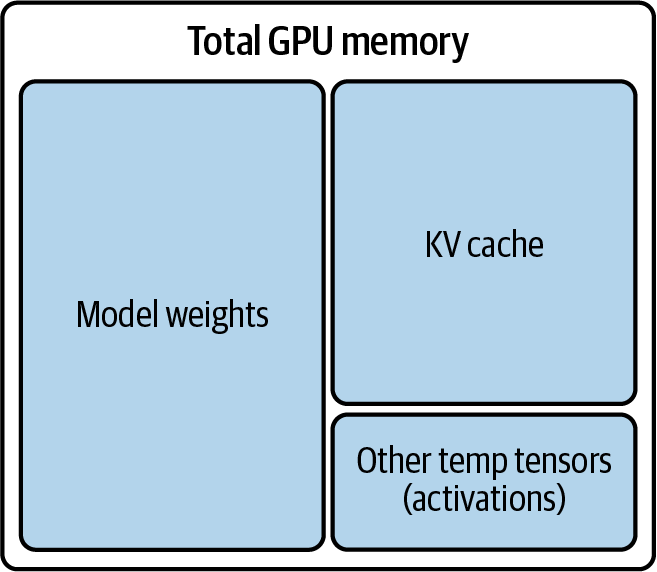
모델 가중치와 KV 캐시가 GPU 메모리 안에서 함께 자리 잡는(co-locate) 모습
토큰 하나에 필요한 KV 캐시는 다음과 같이 추정합니다.
토큰당 KV 캐시 = 2 × 레이어 수 × KV 헤드 수 × 헤드 차원 × 데이터 타입 크기
앞의 2는 K와 V를 의미합니다. MHA 모델의 KV 헤드 수는 어텐션 헤드 수와 같고, GQA·MQA 모델은 num_key_value_heads를 사용합니다.
Llama 2 7B는 MHA 구조이며 레이어 32개, KV 헤드 32개, 헤드 차원 128을 사용합니다. KV 캐시를 FP16이나 BF16으로 저장하면 토큰당 크기는 다음과 같습니다.
2 × 32 × 32 × 128 × 2바이트 = 524,288바이트 = 0.5MiB
전체 KV 캐시는 동시에 캐시하는 토큰 수에 비례합니다.
전체 KV 캐시 = 토큰당 KV 캐시 × 동시에 캐시하는 전체 토큰 수
고정된 배치 크기로 최대 사용량을 단순 계산하면 전체 토큰 수는 배치 크기 × 최대 시퀀스 길이입니다. Llama 2 7B에서 배치 크기 16, 시퀀스 길이 4,096을 가정하면 약 0.5MiB × 16 × 4,096 = 32GiB가 필요합니다. 이는 모델 가중치 약 14GB보다 큰 용량입니다.
모델 가중치는 로딩 후 일정한 공간을 차지하지만 KV 캐시는 활성 요청 수와 시퀀스 길이에 따라 사용량이 증가합니다. 활성화 값과 런타임 작업 공간도 필요하므로 계산 결과를 GPU 메모리 전체에 할당하면 OOM이 발생할 수 있습니다. 실제 용량 계획에서는 최대 컨텍스트 길이, 동시 요청 수, 배치 토큰 수와 런타임의 메모리 예약 공간을 함께 조정해야 합니다.
KV 캐시 용량 추정 예시: A10(24GB)과 L40S(48GB)
앞서 계산한 Llama 2 7B를 최대 시퀀스 길이 4,096 으로 서빙하면 요청 하나의 KV 캐시에 약 2GB가 필요합니다. 모델 가중치 14GB와 활성화 값·런타임 작업 공간 2GB를 먼저 확보한다고 가정해 두 GPU의 동시 요청 수를 비교해보겠습니다.

A10은 KV 캐시에 8GB를 사용할 수 있어 요청 4건을, L40S는 32GB를 사용할 수 있어 요청 16건을 처리할 수 있습니다. 메모리 용량은 두 배지만 이 조건에서 KV 캐시 공간과 동시 요청 수는 네 배가 됩니다.
이 계산은 메모리 용량만 비교한 단순 예시입니다. 실제 최대 동시 요청 수와 비용 효율은 서빙 엔진의 메모리 할당 방식, 활성화 값, 메모리 단편화, 요청 길이 분포와 실제 처리량을 함께 측정해 판단해야 합니다.
LLM 모델 수행의 병목
LLM이 입력을 처리하고 출력을 생성할 때는 두 가지 뚜렷한 단계, 즉 prefill과 디코딩을 거칩니다. 이 단계들은 GPU 활용 패턴에서 현저한 차이를 보입니다.
이를 분석하기 위해 계산 효율성을 측정하는 산술 강도(arithmetic intensity) 라는 개념과 하드웨어 한계 및 성능 제약을 보여주는 루프라인 모델(roofline model)이란 개념을 살펴봅니다.
GPU 연산 및 메모리 대역폭의 경계
모델이 GPU에 로드된 후 서빙준비가 끝났다면 연산/대역폭의 문제를 살펴봐야하죠. 위에서 살펴본 피자 주방 비유로 살펴보자면 아래와 같겠죠:
- 더 빨리 굽는 큰 오븐이 필요(연산)한지, 재료와 반죽을 더 빨리 준비하는게 필요(대역폭)한지 살펴봐야하며
- 워크로드에서 어느쪽이 병목인지 살펴봐야한다
산술 강도
산술 강도(arithmetic intensity)는 데이터를 옮긴 양에 비해 얼마나 많은 연산을 수행하는지를 나타냅니다. 같은 데이터를 여러 연산에 재사용할수록 산술 강도가 높아집니다.
산술 강도 = 수행한 부동소수점 연산 수 ÷ 이동한 데이터양
단위는 FLOP/byte입니다.
- 낮은 산술 강도: 데이터 읽기와 쓰기에 비해 수행하는 연산이 적습니다.
- 높은 산술 강도: 적은 데이터를 여러 번 재사용해 많은 연산을 수행합니다.
앞의 피자 가게에 대입하면 산술 강도는 재료를 한 번 운반한 뒤 얼마나 많은 피자를 만드는지를 나타냅니다.
- 낮은 산술 강도: 재료를 한 번 가져와 피자 한 판만 만듭니다. 재료를 나르는 시간이 길고 오븐은 재료를 기다립니다.
- 높은 산술 강도: 재료를 한 번 가져와 여러 판의 피자를 만듭니다. 같은 재료를 여러 연산에 사용하므로 오븐을 계속 가동할 수 있습니다.
| 표기 | 의미 | Roofline에서의 위치 |
|---|---|---|
FLOP |
부동소수점 연산량 | 산술 강도의 분자 |
FLOP/s |
초당 부동소수점 연산 처리량 | y축 |
FLOP/byte |
데이터 1바이트당 연산량 | x축 |
정수 연산까지 포함할 때는 OP, OP/s, OP/byte를 사용할 수 있습니다. 이 글에서는 부동소수점 연산량을 FLOP, 처리량을 FLOP/s로 표기합니다.
데이터 이동
이 절에서는 모델 로딩이 끝난 뒤, 모델을 실행하면서 발생하는 GPU 내부의 데이터 이동을 다룹니다.
모델 가중치는 GPU의 외부 메모리인 HBM이나 GDDR6에 저장됩니다. 연산에 사용할 데이터는 GPU 메모리에서 L2 캐시, L1 캐시와 공유 메모리를 거쳐 레지스터로 이동합니다.
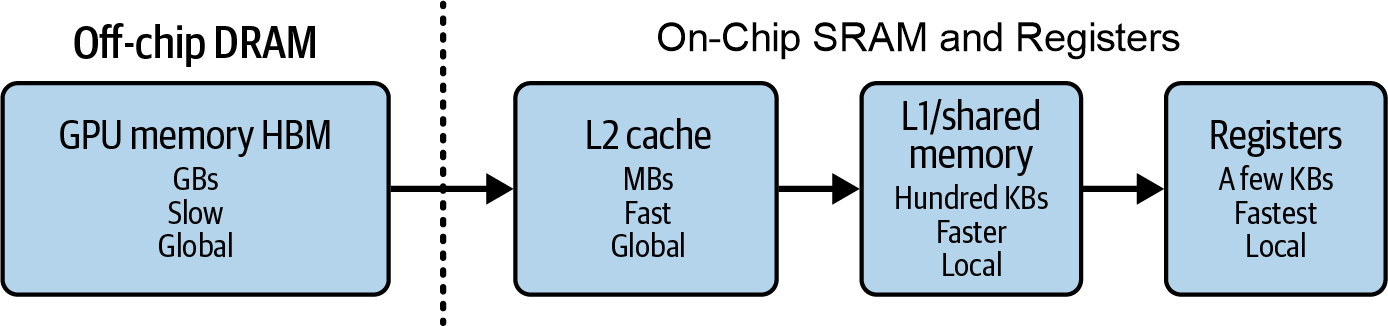
여기서 chip은 GPU 연산 다이(die)를 의미합니다. L2 캐시와 L1 캐시·공유 메모리는 GPU 다이 내부의 SRAM이며, 레지스터도 GPU 다이 내부에 있습니다.
HBM과 GDDR6은 별도의 DRAM 다이로 구성되어 GPU 다이 외부에 있으므로 off-chip 메모리로 분류합니다. HBM은 GPU와 같은 패키지에 배치될 수 있지만 GPU 연산 다이에는 포함되지 않습니다.
따라서 그림에서는 GPU 다이 내부의 메모리 계층을 On-Chip SRAM and Registers로 표기합니다.
산술 강도를 GPU 메모리 대역폭과 비교할 때는 GPU 메모리 인터페이스를 통과한 바이트를 기준으로 계산합니다. GPU 메모리에서 데이터를 가져오는 속도가 연산 장치의 소비 속도를 따라가지 못하면 메모리 대역폭 병목이 발생합니다.
FlashAttention과 커널 융합은 데이터를 작은 타일로 나누어 온칩 메모리에서 재사용합니다. 이 방식은 중간 결과를 GPU 메모리에 반복해서 쓰고 읽는 작업을 줄여 실질적인 산술 강도를 높입니다.
다시말해, 느린 GPU 외부 메모리에서 가져온 데이터를 온칩 메모리에서 최대한 많이 재사용하면 HBM·GDDR6을 오가는 데이터양이 줄고 산술 강도가 높아집니다.
루프라인 모델
루프라인 모델(Roofline model)은 워크로드의 산술 강도와 하드웨어의 연산 성능·메모리 대역폭을 함께 비교하는 성능 모델입니다.
- x축: 산술 강도
- y축: 달성 가능한 연산 성능
- 기울어진 구간: 메모리 대역폭에 의해 성능이 결정되는 영역
- 수평 구간: GPU의 최대 연산 성능에 도달한 영역
- 두 구간의 경계: ridge point 또는 하드웨어 균형점
달성 가능한 성능은 다음과 같이 단순화할 수 있습니다.
이 식은 두 상한 중 낮은 값을 선택합니다. 산술 강도가 낮을 때는
Roofline은 이상적인 조건에서 달성할 수 있는 성능 상한입니다. 실제 측정 성능은 커널 효율, 병렬성, 캐시 적중률과 실행 오버헤드의 영향으로 Roofline보다 낮을 수 있습니다.
산술 강도가 균형점보다 낮으면 데이터를 공급하는 속도가 성능을 제한합니다. 균형점보다 높으면 GPU의 연산 성능이 한계가 됩니다[3].
L40S의 하드웨어 균형점
L40S의 dense FP16 Tensor Core 성능과 메모리 대역폭은 다음과 같습니다.
| 항목 | 사양 |
|---|---|
| Dense FP16 Tensor Core 성능 | |
| GDDR6 메모리 대역폭 |
두 값을 나누면 L40S의 FP16 하드웨어 균형점을 구할 수 있습니다.
따라서 단순화된 FP16 Roofline에서는 다음과 같이 판단합니다.
- 산술 강도가
보다 낮으면 메모리 대역폭의 영향을 받습니다. - 산술 강도가
보다 높으면 최대 연산 성능의 영향을 받습니다.
공식 사양에는 희소성을 적용한 FP16 성능

워크로드의 병목 판정
산술 강도가
메모리 대역폭으로 달성할 수 있는 성능이 GPU의 최대 연산 성능인
산술 강도가
계산 결과는 GPU의 최대 연산 성능을 초과합니다. 실제 성능은
데이터 재사용이 늘어나면 GPU 외부 메모리에서 이동하는 데이터양이 줄고 산술 강도가 높아집니다. 이에 따라 워크로드는 루프라인의 x축에서 오른쪽으로 이동합니다.
- ridge point 왼쪽에서는 데이터 공급 속도가 성능을 제한합니다. GPU 외부 메모리 접근을 줄이거나 메모리 대역폭을 높이면 성능을 개선할 수 있습니다.
- ridge point 오른쪽에서는 GPU 연산 성능이 상한을 결정합니다. 연산 성능과 Tensor Core 활용률, 커널 효율을 높이는 최적화가 중요합니다.
따라서 Roofline은 워크로드의 현재 병목을 확인하고, 데이터 이동과 연산 성능 중 어느 부분을 먼저 최적화할지 판단하는 기준이 됩니다.
이 계산은 최대 사양을 이용한 1차 추정입니다. 실제 경계는 커널 구현, 행렬 크기, 캐시 적중률, 병렬성, 메모리 접근 패턴과 실제 클럭에 따라 달라집니다. 정확한 병목은 프로파일링으로 확인해야 합니다.
이제 남은 질문은 LLM 서빙의 행렬 곱셈과 prefill·decode 단계가 각각 어느 정도의 산술 강도를 가지는가입니다. 다음 절에서는 행렬 곱셈의 산술 강도를 계산한 뒤 이를 prefill과 decode에 적용합니다.
행렬곱에서의 산술 강도
LLM의 트랜스포머 블록은 셀프 어텐션과 피드포워드 레이어로 구성되며, 두 레이어의 연산량 대부분은 행렬곱(matrix multiplication, matmul)에서 발생합니다. 정규화, 활성화 함수와 같은 원소별 연산과 reduction도 실행되지만 산술 강도가 낮은 편입니다. 연산량에서 차지하는 비중이 작아도 데이터 이동과 커널 실행 비용 때문에 실제 수행 시간에는 영향을 줄 수 있습니다.
행렬곱은 입력 행렬의 각 행과 가중치 행렬의 각 열을 내적해 출력 행렬을 만듭니다. 입력 행렬

출력 원소 하나를 계산할 때 길이
입력, 가중치와 출력이 모두 FP16이고 각 행렬이 GPU 메모리에서 한 번씩만 읽히거나 쓰인다고 가정하면 데이터 이동량은 다음과 같습니다.
따라서 FP16 행렬곱의 이론적 산술 강도는 다음과 같습니다.
이 식은 행렬 타일을 온칩 메모리에서 이상적으로 재사용해 각 데이터를 GPU 메모리에서 한 번만 가져오는 경우의 상한입니다. 실제 커널이 같은 데이터를 반복해서 읽으면 데이터 이동량이 늘어 산술 강도가 낮아집니다. 행렬곱의 FLOP과 데이터 이동량은 NVIDIA Matrix Multiplication Background에서도 같은 방식으로 분석합니다.
| 행렬 크기 |
FP16 산술 강도 | L40S의 |
|---|---|---|
| 약 |
메모리 대역폭의 영향이 큼 | |
| 약 |
메모리 대역폭의 영향이 큼 | |
| 약 |
연산 성능의 영향이 큼 |
행렬의 각 차원이 충분히 커지면 같은 데이터를 더 많은 연산에 재사용할 수 있어 산술 강도도 높아집니다. 다만 LLM의 모델 크기가 크다는 사실만으로 모든 행렬곱의 산술 강도가 높아지는 것은 아닙니다. 실제 산술 강도는 각 행렬의
LLM의 Prefill 단계와 디코드 단계의 산술 강도 분석
LLM에 전달되는 입력 텐서의 기본 형태는 [배치 크기, 시퀀스 길이, 히든 차원]입니다.
- 배치 크기
: 동시에 처리하는 요청 수 - 시퀀스 길이
: 요청마다 처리하는 토큰 수 - 히든 차원
: 토큰 하나를 표현하는 벡터의 크기
선형 레이어의 행렬곱에서는 배치와 토큰 축을 합쳐 입력을
Prefill 단계와 Decode 관계에 대해 먼저 아래 그림으로 살펴보시겠습니다.

Prefill 단계
Prefill은 입력 프롬프트의 토큰을 함께 처리해 각 레이어의 출력을 계산하고 KV 캐시를 생성합니다. 선형 레이어에서는 입력 토큰 수만큼 행이 있는 큰 행렬을 가중치 행렬과 곱합니다.
- 입력 행렬:
- 가중치 행렬:
- 행렬곱의 토큰 축:
프롬프트가 길면 한 번 불러온 가중치를 많은 토큰의 연산에 재사용할 수 있습니다. 이 때문에 큰 행렬곱이 만들어지고 산술 강도도 높아지는 경향이 있습니다.
Decode 단계
Decode는 각 활성 요청에서 새로운 토큰 하나씩을 생성합니다. 시퀀스 길이가 길어져도 한 번의 decode 스텝에서 선형 레이어에 새로 입력되는 토큰은 요청당 하나입니다.
- 입력 행렬:
- 가중치 행렬:
- 행렬곱의 토큰 축:
배치 크기가 1이면
정사각 선형 레이어로 단순 비교
가중치 행렬이
| 단계와 조건 | 근사 산술 강도 | L40S 기준 예상 | |
|---|---|---|---|
| Prefill, |
약 |
연산 성능의 영향이 큼 | |
| Decode, |
약 |
메모리 대역폭의 영향이 큼 | |
| Decode, |
약 |
메모리 대역폭의 영향이 큼 |
Prefill은 여러 프롬프트 토큰이 가중치를 함께 사용해 산술 강도가 높아지는 경향이 있습니다. Decode는 한 스텝에서 요청당 토큰 하나만 처리하므로 작은 배치에서는 가중치 재사용이 적고 메모리 대역폭의 영향을 크게 받습니다.
배치를 키우면 산술 강도와 전체 처리량을 높일 수 있지만 KV 캐시 사용량과 요청 지연도 함께 증가합니다.
이 계산은 선형 레이어와 GPU 메모리 트래픽을 중심으로 한 근사치입니다.
실제 prefill과 decode에는 Attention, KV 캐시 접근, 정규화, 커널 실행과 GPU 간 통신도 포함되므로 최종 병목은 프로파일링으로 확인해야 합니다.
그 외 AI 가속기와 동향
경쟁칩들의 근황
- 범용 가속기: AMD MI300X와 Intel Gaudi2는 NVIDIA H100·A100을 대체할 수 있는 선택지입니다.
- 클라우드 전용 가속기: Google TPU와 Amazon Inferentia는 각 사업자의 클라우드 환경을 중심으로 제공됩니다.
- 지역별 대안: Huawei Ascend NPU는 NVIDIA 제품 공급에 제약이 있는 시장에서 주목받고 있습니다.
- 가속기 스타트업: Groq, Cerebras, Untether AI, SambaNova와 d-Matrix도 서로 다른 아키텍처로 추론 시장에 진입하고 있습니다.
NVIDIA의 독점 이유
- 범용성과 특화: 일부 경쟁 칩은 딥러닝 추론이나 행렬곱, 트랜스포머 워크로드에 집중해 단순한 구조와 높은 비용·에너지 효율을 제공합니다. 다만 모델 아키텍처가 빠르게 바뀌면 지원 범위가 제약될 수 있습니다.
- 소프트웨어 생태계: NVIDIA의 CUDA 생태계는 학습과 추론 전반에서 성숙한 도구와 폭넓은 커뮤니티 지원을 제공합니다. AMD ROCm, Google JAX, AWS Neuron처럼 가속기마다 별도의 소프트웨어 스택을 사용하면 기존 시스템을 이전하는 비용도 커집니다.
- 온칩 SRAM 활용: 온칩 SRAM을 적극적으로 활용하는 가속기는 짧고 예측 가능한 지연시간을 제공할 수 있습니다. 그러나 SRAM은 단가가 높고, 대형 모델 하나에 여러 칩이 필요하면 전체 비용 효율이 낮아질 수 있습니다.
- 하드웨어 유연성: NVIDIA GPU는 FP8·FP4를 비롯한 여러 정밀도와 높은 메모리 대역폭, 고속 GPU 인터커넥트를 지원합니다. 덕분에 다양한 학습·추론 구성에 대응하기 쉽습니다.
메모리 벽[4]과 완화 트렌드
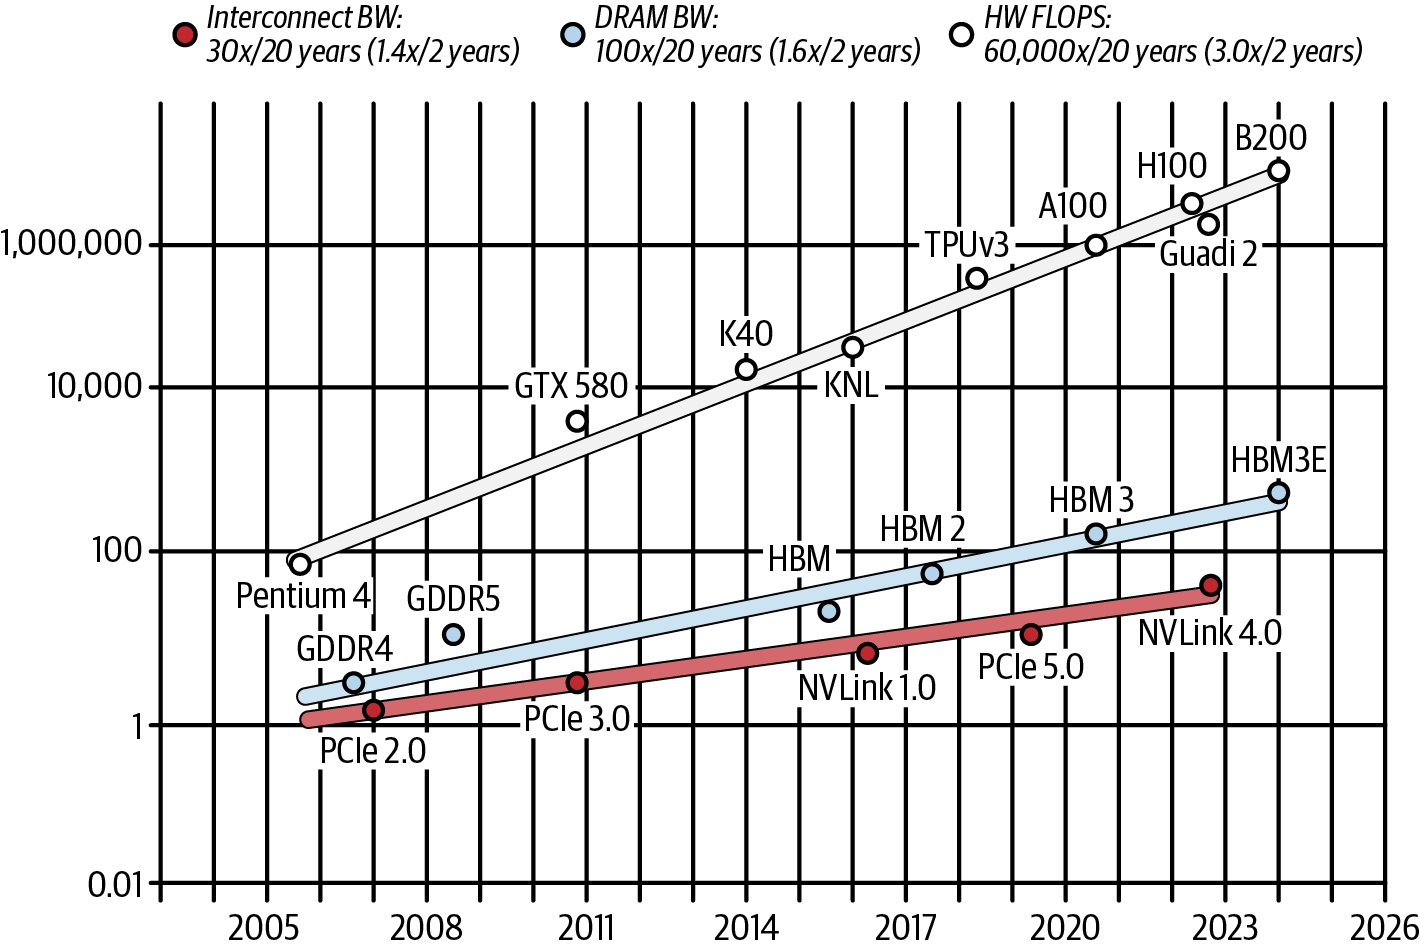
- 지난 20년 동안 연산 성능은 빠르게 향상되었지만, 메모리 대역폭과 GPU 간 대역폭 같은 데이터 이동 성능은 상대적으로 느리게 발전했습니다.
- 이 격차 때문에 연산 장치가 데이터를 기다리면서 최대 성능을 활용하지 못하는 현상을 메모리 벽(memory wall)이라고 합니다[4:1].
- 가속기 제조사들은 온칩 메모리 확대와 고속 인터커넥트, 랙 규모의 시스템 설계로 메모리 벽을 완화하고 있습니다.
On-chip SRAM으로 연산을 더 빨리 끌어오기
- 대용량 온칩 SRAM을 사용하면 모델 파라미터와 중간 데이터를 연산 장치 가까이에 유지할 수 있어 메모리 접근 지연이 줄어듭니다.
- SRAM은 비용과 면적 부담이 크지만, 짧고 예측 가능한 지연시간이 중요한 추론 워크로드에는 유용합니다.
- Groq와 NVIDIA의 기술 라이선스 협력은 저지연 추론 기술에 대한 업계의 관심을 보여주는 사례입니다. 실리콘 비용이 늘고 모델을 여러 칩에 나누어야 하더라도, 일부 워크로드에서는 짧은 지연시간이 높은 피크 처리량보다 중요할 수 있습니다.
멀티 GPU 시스템 전체로 성능 확장
- 메모리와 통신 최적화는 CPU와 GPU를 결합한 시스템 전체로 확장되고 있습니다. NVIDIA Grace CPU는 고대역폭 인터커넥트로 GPU와 연결되어 대규모 멀티 GPU 시스템의 CPU·GPU 간 전송 부담을 줄입니다.
- 대표적인 랙 스케일 시스템인 GB200 NVL72는 다음 요소로 구성됩니다.
- B200: Blackwell 아키텍처를 사용한 GPU입니다.
- GB200: Grace CPU와 Blackwell GPU를 NVLink-C2C로 연결한 빌딩 블록입니다. CPU와 GPU 사이에 높은 대역폭과 짧은 지연시간을 제공합니다.
- NVL72: NVLink Switch System으로 Blackwell GPU 72개를 하나의 NVLink 도메인으로 연결합니다.
- GB200 NVL72는 랙 하나에 Grace CPU 36개와 Blackwell GPU 72개를 통합합니다. 이 구조는 대형 MoE 모델의 분리형 서빙(disaggregated serving)처럼 많은 가속기 사이의 통신이 필요한 구성에 활용할 수 있습니다. 분리형 서빙은 7장에서 자세히 다룹니다.
- 이러한 시스템은 소프트웨어와 하드웨어를 함께 최적화하는 공동 설계가 필요합니다. 현재는 일부 프런티어 AI 연구소와 대형 클라우드 사업자가 먼저 도입하고 있으며, 랙 스케일 추론 시스템 분석에서 구체적인 사례를 확인할 수 있습니다.
끝으로
이 장에서 다룬 내용을 세 가지 흐름으로 정리할 수 있습니다.
- LLM 서빙의 중요성
- 효율적인 LLM 서빙은 사용자 경험과 GPU 비용뿐 아니라 피크 트래픽 대응력과 서비스의 확장 가능성에도 영향을 줍니다.
- AI 가속기 이해
- GPU를 비교할 때는 연산 성능과 메모리 용량, 메모리 대역폭을 함께 살펴봐야 합니다.
- 대형 모델을 여러 GPU에 나누면 노드 내부와 노드 간 인터커넥트가 새로운 병목이 될 수 있습니다.
- NVIDIA 이외의 가속기와 메모리 벽을 완화하려는 하드웨어 설계도 함께 살펴봤습니다.
- 하드웨어에서 실행되는 LLM 이해
- 모델 로딩 과정과 실제 추론 과정에서 발생하는 데이터 이동을 구분했습니다.
- 산술 강도와 Roofline 모델을 사용하면 워크로드가 연산 성능과 메모리 대역폭 중 어디에 더 큰 영향을 받는지 근사할 수 있습니다.
- Prefill은 여러 토큰이 가중치를 함께 사용해 산술 강도가 높아지는 경향이 있습니다. Decode는 한 번에 처리하는 토큰이 적어 메모리 대역폭의 영향을 크게 받으며, 배치 크기에 따라 그 정도가 달라집니다.
LLM 추론 기술은 빠르게 발전하고 있지만, 하드웨어 사양과 데이터 이동을 이해하는 기본 원리는 계속 활용할 수 있습니다. 이 장에서 정리한 흐름은 이후 장에서 다룰 최적화 기법을 평가하고, 현재 워크로드에 적합한 방법을 선택하는 기준이 됩니다.
NVIDIA GPU 내부에서 딥러닝에 필요한 행렬 곱셈과 누산을 빠르게 수행하도록 만든 전용 연산 장치입니다. 참고: NVIDIA GPU Performance Background User's Guide ↩︎
GPU 메모리 일부를 사용해 이전 토큰에서 계산한 K/V를 저장하는 최적화 기법입니다. 다음 토큰을 생성할 때 이전 K/V를 다시 계산하지 않고 재사용할 수 있어 서빙속도가 빨라집니다. ↩︎
이는 NVIDIA가 설명하는 Roofline 분석 방식과 같습니다. ↩︎
메모리 벽의 추세는 LLM Inference Unveiled: Survey and Roofline Model Insights를 참고했습니다. ↩︎ ↩︎