[CloudNeta] Hands-On LLM Serving 5주차 part 1 - 실전 LLM 최적화
이 글은 5주차 연재의 첫 번째 편입니다.
- part 1 - 실전 LLM 최적화 (이 글)
- part 2 - LLM 서빙의 발전
들어가며
9장 요약과 핵심 내용
앞선 장들에서는 LLM 서빙의 병목과 최적화 기법, 이를 구현하는 서빙 프레임워크를 살펴보았습니다. 9장에서는 이 지식을 실제 최적화 절차로 연결합니다. Qwen3-14B와 vLLM을 사례로 하드웨어를 분석하고, 벤치마크 트래픽과 평가 지표를 정의한 뒤, 기본 모델과 양자화 모델의 성능을 비교합니다.
최적화는 설정을 바꾼 뒤 측정과 검증을 반복하는 과정입니다. 이 글에서는 단일 A40에서 BF16과 AWQ 모델의 성능을 비교하고, AWQ의 배칭·메모리 설정을 조정한 결과까지 다룹니다. LMCache, 추측 디코딩과 분산 서빙은 후속 실험으로 남겼습니다. 이어서 한국어 모델을 API와 Gradio UI에 연결하며 구축 과정의 호환성 문제도 살펴봅니다.
LLM 서빙 최적화 계획
실습 대상과 최적화 목표
| 항목 | 설정 |
|---|---|
| 모델 | Qwen/Qwen3-14B |
| 모델·토크나이저 소스 | Hugging Face |
| 서빙 엔진 | vLLM |
| 서빙 형태 | 온라인 서빙 |
| 핵심 목표 | 단일 모델 인스턴스의 토큰 처리량 최대화 |
이 실습에서는 Hugging Face에 배포된 Qwen/Qwen3-14B 모델을 vLLM으로 온라인 서빙하고, 한 모델 인스턴스가 단위 시간에 처리할 수 있는 토큰 수를 최대화합니다. 즉, 주어진 시간 안에 가능한 한 많은 토큰을 처리하는 토큰 처리량(token throughput) 최적화에 집중합니다.
사용자 경험을 해치지 않는 지연시간 범위 안에서 단일 모델 인스턴스의 토큰 처리량을 최대화합니다.
처리량이 중요한 이유
자체 호스팅이나 GPU 임대 환경에서는 GPU 사용 시간이 곧 비용입니다. 같은 GPU를 같은 시간 동안 사용하면서 더 많은 토큰을 처리하면 토큰당 인프라 비용이 낮아집니다.
예를 들어 같은 GPU 한 장에서 서버 A가 초당 500개, 서버 B가 초당 1,500개의 토큰을 처리한다면 서버 B는 같은 GPU 비용으로 세 배 많은 토큰을 처리합니다. 다른 조건과 GPU 사용료가 같다면 토큰당 인프라 비용은 약 3분의 1이 됩니다.
이는 실제 LLM 서빙에서 중요하게 보는 단위 시간당 토큰 처리 효율과 연결됩니다. 다만 외부 LLM API처럼 공급자가 토큰당 요금을 고정한 서비스에서는 처리량이 높아진다고 API의 토큰당 단가가 직접 낮아지는 것은 아닙니다. 여기서는 직접 운영하거나 임대한 GPU의 인프라 비용을 기준으로 합니다.
처리량과 지연시간의 트레이드오프
불필요한 연산 제거와 효율적인 커널 사용처럼 처리량과 지연시간을 함께 개선하는 최적화도 있습니다. 그러나 특정 트래픽 패턴에서는 최대 처리량과 최소 지연시간이 본질적으로 충돌합니다.
flowchart LR
    A[요청을 모아 큐잉] --> B[배치 크기와 병렬성 증가]
    B --> C[GPU 활용률 증가]
    C --> D[토큰 처리량 증가]
    A --> E[큐 대기시간 증가]
    E --> F[요청 지연시간 증가]

    G[요청을 즉시 처리] --> H[배치 크기와 병렬성 감소]
    H --> I[요청 지연시간 감소]
    H --> J[GPU 활용률 감소]
    J --> K[토큰 처리량 감소]
높은 처리량을 얻으려면 일반적으로 여러 요청을 모아 배칭하거나 큐잉해 하드웨어 활용도를 높여야 합니다. 이 과정에서 요청의 대기시간이 늘어나면 요청당 지연시간도 증가합니다. 반대로 요청이 도착하는 즉시 낮은 병렬성으로 처리하면 지연시간은 줄어들지만 자원 활용도가 낮아져 전체 처리량이 감소할 수 있습니다.
실무에서는 대개 지연시간을 허용 가능한 범위 내로 유지하면서 처리량 개선을 우선합니다. 이 장도 처리량 최적화에 초점을 맞추되, 응답성이 효율보다 중요한 상황을 위해 분산 서빙과 같은 저지연 지향 기법도 함께 살펴봅니다.
8단계 실행 계획
8단계에서 동종 GPU는 텐서 병렬화나 파이프라인 병렬화처럼 하나의 모델 실행을 여러 GPU로 확장하는 데 사용합니다. 이종 GPU는 같은 병렬 그룹에 단순히 섞기보다 프리필과 디코드 역할을 분리하거나 서로 다른 복제본에 워크로드를 배치하는 방식으로 비교합니다. GPU별 처리 속도와 메모리 용량이 다르면 느린 GPU가 전체 실행의 병목이 될 수 있기 때문입니다.
요약
이 계획은 처리량 우선, 지연시간은 허용 범위 내 유지라는 목표 아래 다음 순서로 실험을 쌓아갑니다.
하드웨어 이해 → 벤치마크 설계 → 지표 정의 → 서빙 구성 → 베이스라인 측정 → 양자화 비교 → 추가 기법 적용 → 분산 서빙
각 단계에서는 앞선 단계의 조건을 고정한 채 한 가지 요인만 바꾸고, 실행 명령과 설정, 원시 측정값을 함께 남깁니다. 이를 통해 단순히 가장 높은 수치를 찾는 데서 끝나지 않고 어떤 변경이 성능 차이를 만들었는지 재현하고 설명할 수 있습니다.
RunPod 실습 환경 준비
GPU Pod 생성 시행착오
이번 실습은 PyTorch 2.8.0 + Jupyter 8888 환경과 48GB VRAM의 NVIDIA A40을 기준으로 진행합니다. 처음에는 Community Cloud의 A40을 시간당 약 $0.35에 생성하려고 했지만, 생성 시점에 해당 GPU의 재고가 없어 Pod 생성에 실패했습니다.
대안으로 Secure Cloud의 A40을 선택해 다시 생성했고, 이 구성에서는 Pod가 정상적으로 실행되었습니다. 생성 시점에 확인된 GPU 사용료는 시간당 $0.49였으며, 실제 비용은 세금과 스토리지 사용량에 따라 달라질 수 있습니다.
Pod 생성 시 JUPYTER_PASSWORD 환경변수를 설정했습니다. 이 값은 JupyterLab 접속 인증에 사용되며, 설정되어야 8888/http 포트에서 JupyterLab이 정상적으로 시작됩니다. 비밀번호 값 자체는 문서에 기록하지 않습니다.
Pod와 JupyterLab 확인
Pod가 RUNNING 상태가 된 뒤 JupyterLab의 8888 포트로 접속했습니다. 브라우저에서 새 Python Notebook을 열고 다음 코드로 PyTorch, CUDA, GPU 모델과 메모리를 확인했습니다.
import torch

print(torch.__version__)
print(torch.cuda.is_available())
print(torch.cuda.get_device_name(0))
print(torch.cuda.get_device_properties(0).total_memory / 1024**3)
실행 결과는 다음과 같습니다.
2.8.0+cu128
True
NVIDIA A40
44.42193603515625
여기서 2.8.0+cu128은 CUDA 12.8용으로 빌드된 PyTorch 2.8.0을 뜻합니다. total_memory는 PyTorch가 인식한 장치의 총 메모리로, 이 환경에서는 약 44.42 GiB였습니다. 현재 비어 있는 메모리는 torch.cuda.mem_get_info()의 free 값으로 별도 확인해야 합니다. PyTorch 2.8 문서
/workspace 작업 디렉터리 준비
Pod의 영속 작업공간인 /workspace 아래에 실습용 디렉터리를 만들었습니다. 모델과 노트북, 실행 스크립트, 로그를 분리해 저장하기 위한 기본 구조입니다.
from pathlib import Path

base = Path("/workspace/llmso")
for name in ("models", "notebooks", "scripts", "logs"):
    (base / name).mkdir(parents=True, exist_ok=True)

print(base)
print([p.name for p in base.iterdir()])
/workspace/llmso
['logs', 'scripts', 'notebooks', 'models']
uv와 가상환경 준비
컨테이너에 이미 설치된 Python과 uv의 경로를 확인했습니다.
import shutil
import sys

print("python:", sys.executable)
print("uv:", shutil.which("uv"))
python: /usr/local/bin/python
uv: /usr/bin/uv
기존 컨테이너의 PyTorch 설치를 재사용할 수 있도록 시스템 패키지를 참조하는 가상환경을 만들었습니다.
!uv venv --system-site-packages /workspace/llmso/.venv
Using CPython 3.12.3 interpreter at: /usr/local/bin/python
Creating virtual environment at: llmso/.venv
Activate with: source llmso/.venv/bin/activate
Jupyter Notebook에서 이 가상환경을 커널로 사용하기 위해 ipykernel을 설치했습니다.
!uv pip install --python /workspace/llmso/.venv/bin/python ipykernel
Python 3.12.3 환경에 ipykernel 7.3.0을 포함한 29개 패키지를 설치했습니다.
이어서 가상환경을 Jupyter 커널로 등록했습니다.
! /workspace/llmso/.venv/bin/python -m ipykernel install --user --name llmso --display-name "Python (llmso)"
Installed kernelspec llmso in /root/.local/share/jupyter/kernels/llmso
Jupyter Notebook의 커널을 Python (llmso)로 전환한 뒤 Python과 PyTorch 경로를 확인했습니다.
import sys
import torch

print("python:", sys.executable)
print("torch:", torch.__version__)
print("cuda:", torch.cuda.is_available())
print("gpu:", torch.cuda.get_device_name(0))
python: /workspace/llmso/.venv/bin/python
torch: 2.8.0+cu128
cuda: True
gpu: NVIDIA A40
이 결과로 Jupyter가 llmso 가상환경의 Python을 사용하고, PyTorch가 CUDA와 NVIDIA A40을 정상적으로 인식하는 것을 확인했습니다.
GPU 상세 점검
nvidia-smi를 실행해 GPU의 실제 상태를 확인했습니다.
!nvidia-smi
확인한 주요 값은 다음과 같습니다.
GPU: NVIDIA A40
GPU Memory: 46068 MiB
Driver Version: 580.159.04
Performance State: P8
Memory Usage: 3 MiB
Pod가 유휴 상태일 때 A40의 사용 메모리는 3MiB로 매우 낮았고, 성능 상태는 P8로 확인되었습니다. 모델을 로드하고 추론을 실행하면 메모리 사용량과 성능 상태가 달라지므로, 이후 벤치마크에서도 같은 명령으로 상태 변화를 확인합니다.
Jupyter와 nvidia-smi로 기본 하드웨어 상태를 확인했습니다. 이 결과는 뒤의 1단계에서 요약합니다.
vLLM 전용 환경 준비
기본 PyTorch 환경과 서빙 엔진 환경을 분리해 관리하기 위해 vLLM 전용 가상환경을 추가로 만들었습니다.
!uv venv /workspace/llmso/vllm-venv
Using CPython 3.12.3 interpreter at: /usr/local/bin/python
Creating virtual environment at: /workspace/llmso/vllm-venv
Activate with: source /workspace/llmso/vllm-venv/bin/activate
가상환경 생성 후 vllm과 호환되는 PyTorch를 자동으로 선택해 설치했습니다.
!uv pip install --python /workspace/llmso/vllm-venv/bin/python vllm --torch-backend=auto
Python 3.12.3 환경에 총 197개 패키지를 설치했습니다. 주요 패키지 버전은 다음과 같습니다.
vllm==0.28.0- vLLM 전용 PyTorch:
torch==2.13.0+cu126 transformers==5.16.1flashinfer-python==0.6.16.post3
패키지 설치에는 준비 단계 5분 12초, 실제 설치 34.96초가 걸렸습니다. 이 환경의 PyTorch는 앞에서 만든 기본 .venv의 torch==2.8.0+cu128과 분리되어 있습니다.
설치가 끝난 뒤 vllm-venv에서 PyTorch와 vLLM을 함께 import해 GPU 인식을 확인하려 했습니다.
!/workspace/llmso/vllm-venv/bin/python -c "import torch, vllm; print(torch.__version__); print(vllm.__version__)"
하지만 다음 오류가 발생했습니다.
ImportError: libcudart.so.13: cannot open shared object file: No such file or directory
vLLM과 관련 패키지 설치 자체는 성공했지만, vLLM을 import하는 단계에서 필요한 CUDA 런타임 동적 라이브러리 libcudart.so.13을 찾지 못한 상태입니다. 이어서 vllm-venv의 site-packages에서 해당 라이브러리의 설치 여부와 위치를 확인했습니다.
vllm-venv의 site-packages를 확인한 결과 CUDA 런타임 라이브러리 파일은 설치되어 있었습니다.
nvidia/cuda_runtime/lib/libcudart.so.12nvidia/cu13/lib/libcudart.so.13
따라서 문제는 라이브러리 미설치가 아니라, vLLM import 시 CUDA 13 라이브러리가 있는 경로가 LD_LIBRARY_PATH에 포함되지 않은 환경 설정으로 좁혀졌습니다. cu13, cuda_runtime, torch/lib 경로를 임시 LD_LIBRARY_PATH에 추가한 뒤 import를 다시 검증했습니다.
# 임시 경로를 지정해 import를 검증한 명령
VENV=/workspace/llmso/vllm-venv
LD_LIBRARY_PATH="$VENV/lib/python3.12/site-packages/nvidia/cu13/lib:$VENV/lib/python3.12/site-packages/nvidia/cuda_runtime/lib:$VENV/lib/python3.12/site-packages/torch/lib:${LD_LIBRARY_PATH}" \
  "$VENV/bin/python" -c "import torch, vllm; print(torch.__version__); print(vllm.__version__)"
임시로 세 경로를 추가한 뒤 import를 다시 검증한 결과는 다음과 같습니다.
torch 2.13.0+cu126
vllm 0.28.0
cuda True
NVIDIA A40
경로를 지정한 별도 프로세스에서 PyTorch와 vLLM을 불러오고 A40을 인식하는 데 성공했습니다.
이후 현재 Jupyter 세션의 LD_LIBRARY_PATH에 다음 경로를 등록했습니다.
/workspace/llmso/vllm-venv/lib/python3.12/site-packages/nvidia/cu13/lib/workspace/llmso/vllm-venv/lib/python3.12/site-packages/nvidia/cuda_runtime/lib/workspace/llmso/vllm-venv/lib/python3.12/site-packages/torch/lib/usr/local/cuda/lib64
이제 같은 Notebook 세션에서 실행하는 vLLM 명령이 필요한 CUDA 런타임 라이브러리를 찾을 수 있습니다.
ch09 저장소 준비
벤치마크와 실행 코드를 가져오기 위해 llm-model-inference 저장소를 전체 파일 대신 sparse clone으로 준비했습니다.
!git clone --depth 1 --filter=blob:none --sparse https://github.com/orca3/llm-model-inference.git /workspace/llmso/llm-model-inference
저장소 복제를 완료했으며, 전송 결과는 다음과 같습니다.
27 objects, 4.44 KiB
5 objects, 710.45 KiB
이어서 sparse-checkout 대상으로 ch09 디렉터리를 지정했습니다.
!git -C /workspace/llmso/llm-model-inference sparse-checkout set ch09
8 objects, 1.96 MiB
8개 파일 업데이트 성공
작업 디렉터리에 ch09 파일을 체크아웃했습니다. 파일 목록은 다음과 같습니다.
README.mdinspect_dataset.pymodel_optimization_in_practice.htmlmodel_optimization_in_practice.ipynbmodel_optimization_in_practice.pdfprefix_repetition_samples.jsonsharegpt_samples.jsontest_serve_results.txt
저장소에서 가져온 파일은 용도별 작업 디렉터리에 배치했습니다. 두 샘플 파일은 /workspace/llmso/models, 점검 스크립트는 /workspace/llmso/scripts에 두었습니다. 아래 코드는 이 배치를 마친 상태에서 파일 크기와 스크립트 사용법을 확인한 예입니다.
from pathlib import Path
import subprocess

for path in (
    Path("/workspace/llmso/models/prefix_repetition_samples.json"),
    Path("/workspace/llmso/models/sharegpt_samples.json"),
):
    print(path, path.stat().st_size, "bytes")

subprocess.run([
    "/workspace/llmso/vllm-venv/bin/python",
    "/workspace/llmso/scripts/inspect_dataset.py",
    "--help",
], check=True)
파일 위치와 크기 확인, inspect_dataset.py --help 실행을 완료했습니다.
파일 배치를 확인한 결과는 다음과 같습니다.
prefix_repetition_samples.json: 226KBsharegpt_samples.json: 113KBmodel_optimization_in_practice.ipynb: 1452KBinspect_dataset.py: 10KB
두 데이터셋과 실행 노트북, 점검 스크립트가 작업공간의 의도한 위치에 배치된 것을 확인했습니다. 데이터셋 구조와 요청 길이 분석은 `## 2단계 벤치마크 트래픽 설계
워크로드는 입력·출력 길이, 요청 도착률과 동시 요청 수로 정해지는 작업 부하를 뜻합니다. 프리필은 입력 토큰을 처리하는 단계이고, 디코드는 후속 출력 토큰을 순차적으로 생성하는 단계입니다. KV 캐시는 이전 토큰의 키·값 텐서를 저장해 이후 생성에서 재사용합니다.`에서 수행합니다.
Qwen3-14B를 vLLM으로 서빙 최적화하기
앞에서 준비한 RunPod 환경을 바탕으로 Qwen/Qwen3-14B를 vLLM으로 서빙하면서 8단계 최적화 계획을 실행합니다. 각 단계는 앞선 조건을 가능한 한 고정하고, 변경 사항과 측정 결과를 함께 기록하는 방식으로 진행합니다.
하드웨어 점검, 벤치마크 설계와 vLLM 서버 구성을 마친 뒤 BF16과 AWQ 모델의 성능을 비교했습니다. 이어서 AWQ의 배칭·GPU 메모리 설정 네 가지를 소규모 벤치마크로 비교했습니다. 7단계의 추가 기법과 8단계 분산 서빙은 후속 실험으로 남겼습니다. 저장공간 부족으로 중단됐던 서버 구성은 볼륨을 200GB로 확장한 뒤 완료했습니다.
1단계 하드웨어 점검
환경 준비 과정에서 확인한 하드웨어와 실행 환경을 이후 비교의 기준으로 사용했습니다.
| 항목 | 확인 결과 |
|---|---|
| GPU | NVIDIA A40 1장 |
| 기본 노트북 환경 | PyTorch 2.8.0+cu128, CUDA 사용 가능 |
| vLLM 환경 | 별도 가상환경의 vLLM 0.28.0 |
| 드라이버 | 580.159.04 |
| 유휴 상태 | 메모리 사용량 3 MiB, 성능 상태 P8 |
메모리의 총량과 사용량은 조회 도구와 시점에 따라 구분해 기록했습니다. 모델을 올린 뒤의 가중치·KV 캐시 메모리는 4단계에서 비교합니다.
2단계 벤치마크 트래픽 설계
워크로드는 입력·출력 길이, 요청 도착률과 동시 요청 수로 정해지는 작업 부하를 뜻합니다. 프리필은 입력 토큰을 처리하는 단계이고, 디코드는 후속 출력 토큰을 순차적으로 생성하는 단계입니다. KV 캐시는 이전 토큰의 키·값 텐서를 저장해 이후 생성에서 재사용합니다.
이 단계에서는 이후 최적화 방향을 결정할 벤치마크 입력과 실행 조건을 정합니다. 프롬프트 길이, 출력 길이, 반복되는 입력 앞부분과 멀티모달 입력 여부에 따라 메모리 사용량, 프리필·디코드 비중, 배치 처리와 프리픽스 캐시의 효과가 달라집니다.
데이터셋별 역할
이번 실습에서는 목적이 다른 두 샘플을 분리해 사용합니다.
- ShareGPT 샘플: 다양한 대화형 요청을 근사합니다. 실제 온라인 요청에 가까운 길이 분포를 사용해 처리량을 측정하고, TTFT·ITL로 대화형 서비스의 응답성을 평가합니다.
- Prefix Repetition 샘플: 요청들이 공유하는 앞부분(공통 프리픽스)과 요청마다 달라지는 뒷부분(고유 서픽스)으로 구성한 합성 트래픽입니다. 반복 입력에서 프리픽스 캐시 적중률과 메모리 사용량·처리량의 변화를 평가합니다.
두 데이터셋은 하나의 점수로 섞지 않고 별도 벤치마크로 실행합니다. ShareGPT는 일반 대화형 서빙의 기준선이고, Prefix Repetition은 캐시 동작을 확인하는 스트레스 테스트이기 때문입니다.
ch09 도구와 샘플링 흐름
클론한 ch09의 README.md, inspect_dataset.py, model_optimization_in_practice.ipynb를 기준으로 데이터셋과 벤치마크 흐름을 구성합니다. inspect_dataset.py는 실제 추론을 실행하지 않고, 데이터셋 이름·경로·샘플 수를 받아 토크나이저로 입력을 샘플링하고 길이 분포를 점검합니다. 실제 요청을 보내 성능을 측정하는 작업은 vllm bench serve가 담당합니다.
원본 ShareGPT는 conversations 구조를 가진 94,145개 레코드로 확인됐습니다. 이 데이터에서 샘플을 추출하고 Qwen3 토크나이저로 자연어 대화 요청의 입력·출력 길이 분포를 점검한 뒤, 결과를 벤치마크용 샘플 파일로 저장합니다.
데이터셋 확인 명령과 결과
원본 레코드의 대화 구조를 확인한 뒤, vLLM 전용 Python 환경에서 Qwen3 토크나이저를 사용해 100개 샘플의 입력 길이와 예상 출력 길이를 계산하고 /workspace/llmso/models/sharegpt_samples.json에 저장했습니다.
/workspace/llmso/vllm-venv/bin/python \
  /workspace/llmso/scripts/inspect_dataset.py \
  --dataset-name sharegpt \
  --dataset-path /workspace/llmso/models/ShareGPT_V3_unfiltered_cleaned_split.json \
  --num-prompts 100 \
  --tokenizer Qwen/Qwen3-14B \
  --output-path /workspace/llmso/models/sharegpt_samples.json
records: 94145
structure: conversations
tokenizer: Qwen3
samples: 100
prompt_len: min 5 / max 817 / mean 232.60 / median 141.50 / std 241.42
output_len: min 4 / max 771 / mean 220.61 / median 164.50 / std 210.23
saved: /workspace/llmso/models/sharegpt_samples.json
대표 프롬프트는 원본 대화의 사용자 발화가 이어지는 자연어 형식입니다. 첫 문장과 후속 질문의 일부를 확인했으며, 긴 샘플 전문은 생략했습니다.
Prefix Repetition 샘플 확인
Prefix Repetition은 공통 프리픽스와 길이가 고정된 서픽스를 사용하는 합성 트래픽입니다. 노트북이나 subprocess에서 같은 방식으로 실행할 수 있도록 vLLM 전용 Python과 절대 경로를 사용했습니다.
/workspace/llmso/vllm-venv/bin/python \
  /workspace/llmso/scripts/inspect_dataset.py \
  --dataset-name prefix_repetition \
  --dataset-path /workspace/llmso/models/prefix_repetition_samples.json \
  --num-prompts 50 \
  --tokenizer Qwen/Qwen3-14B \
  --output-path /workspace/llmso/models/prefix_repetition_samples.json
returncode: 0
samples: 50
prompt_len: min 512 / max 512 / mean 512 / median 512 / std 0
output_len: min 128 / max 128 / mean 128 / median 128 / std 0
has_multimodal: False for all samples
saved: /workspace/llmso/models/prefix_repetition_samples.json
위 결과는 샘플 50개를 다시 생성해 확인한 결과입니다. 공통 프리픽스 5개를 사용한 예비 벤치마크와, 10개를 사용한 본 벤치마크는 구분했습니다. 본 벤치마크는 프리픽스와 서픽스 길이 각각 256토큰, 출력 길이 128토큰으로 실행했습니다. 샘플은 자연어 품질 평가에 사용하지 않고, 고정 길이와 반복 패턴을 이용한 메모리·처리량·프리픽스 캐시 스트레스 테스트에 사용합니다. 실제 캐시 효과를 판단할 때는 요청 사이의 공통 프리픽스와 중복률을 별도로 확인합니다.
재현 가능한 트래픽 조건
request-rate는 벤치마크가 설정한 목표 요청 도착률이고, max-concurrency는 동시에 응답을 기다릴 수 있는 요청 수의 상한입니다. 동시 요청 제한과 응답 시간 때문에 실제 완료 요청률은 목표 도착률보다 낮아질 수 있습니다. 다음 표의 요청률과 결과의 요청 처리량을 구분해 읽습니다.
ch09 노트북의 vllm bench serve 설정을 기준으로 다음 조건을 사용합니다.
| 벤치마크 | 요청 수 | 요청률 | 입력·출력 설정 | 동시성 | 결과 |
|---|---|---|---|---|---|
| ShareGPT | 2,000 | 10 req/s, burstiness=1.0 |
원본 ShareGPT 샘플 기반 | 10 | 5단계 기준선 결과로 기록 |
| Prefix Repetition | 1,000 | 5 req/s | prefix_len=256, suffix_len=256, num_prefixes=10, output_len=128 |
10 | 5단계 기준선 결과로 기록 |
ShareGPT는 대화형 트래픽의 처리 성능과 응답성을 평가하고, Prefix Repetition은 프리픽스 캐시와 반복 입력의 처리 특성을 평가합니다. 같은 데이터셋, 요청 수, 입력·출력 길이와 동시성 설정을 반복해 최적화 단계별 결과를 비교합니다. ch09의 과거 test_serve_results.txt는 명령과 결과 형식을 확인하기 위한 참고값이며, 이번 RunPod 측정값과 혼동하지 않습니다.
3단계 평가 지표 정의
최적화 전후의 변화를 같은 기준으로 비교하려면 측정 지표를 먼저 확정해야 합니다. 단계마다 다른 지표를 보면 어떤 변경이 성능 차이를 만들었는지 설명할 수 없기 때문입니다.
지표 체계와 이번 실습의 범위
LLM 서빙 성능 평가에 흔히 쓰이는 지표는 처리량, 지연시간, 자원 활용도, 워크로드 특성, 신뢰성과 비용의 다섯 범주로 나뉩니다. 이번 실습에서는 이 가운데 처리량 두 개와 지연시간 두 개, 모두 네 개를 비교의 중심에 둡니다.

비교의 중심 지표는 총 토큰 처리량, 출력 토큰 처리량, 평균 TTFT와 평균 ITL입니다. 벤치마크 결과에 포함된 요청 처리량, TPOT(Time Per Output Token), 중앙값과 P99도 함께 기록하고, 평균값만으로 드러나지 않는 차이를 해석할 때 보조 지표로 사용합니다.
이 네 지표는 2단계에서 정한 vllm bench serve 명령이 --save-result로 자동 수집하는 값과 직접 대응합니다. 별도 계측을 붙이지 않아도 되고, 이후의 베이스라인 측정과 양자화 비교, 분산 서빙 비교를 모두 같은 네 지표로 일관되게 비교할 수 있습니다.
네 지표가 재는 것

처리량의 단위는 초당 토큰 수이며, 아래에서는 TPS 대신 tok/s로 표기합니다. TPS는 초당 토큰 수와 초당 트랜잭션 수 어느 쪽으로도 읽힐 수 있어, 두 처리량 지표는 단위가 아니라 이름으로 구분합니다.
| 지표 | 재는 값 | 무엇을 말해주는가 |
|---|---|---|
| 총 토큰 처리량(total token throughput, tok/s) | 초당 처리되는 입력 토큰과 출력 토큰의 합 | 입력·출력 토큰을 합산한 처리 속도 |
| 출력 토큰 처리량(output token throughput, tok/s) | 초당 생성되는 출력 토큰의 평균 개수 | 출력 생성과 디코드 처리 효율 |
| 평균 TTFT(Time To First Token, ms) | 요청 전송부터 첫 스트리밍 출력 수신까지의 평균 시간 | 초기 응답성 |
| 평균 ITL(Inter-Token Latency, ms) | 연속된 스트리밍 출력의 평균 수신 간격 | 스트리밍 품질과 지속적인 체감 속도 |
처리량 지표를 둘로 나누어 보는 이유
총 토큰 처리량은 성공한 요청의 입력·출력 토큰 수를 합산해 벤치마크 전체 시간으로 나눈 값입니다. 초당 입력 700토큰과 출력 300토큰을 처리했다면 1,000 tok/s입니다. 입력 토큰과 출력 토큰의 처리 비용은 서로 다르므로 이 값을 연산량이나 GPU 효율 자체로 해석하지는 않습니다.
출력 토큰 처리량은 생성된 출력 토큰 수를 벤치마크 전체 시간으로 나눈 값으로, 앞의 예에서는 300 tok/s입니다. 두 처리량을 함께 보면 입력·출력 비중에 따른 차이를 살펴볼 수 있습니다. 다만 출력 토큰 처리량에도 프리필과 대기시간의 영향이 반영되므로, 병목의 위치나 순수 디코드 속도를 확인하려면 추가 측정이 필요합니다.
출력 토큰 처리량이 GPU 시간당 생산량과 이어지는 것은 사실이지만, 이 값 자체를 비용으로 읽지는 않습니다. 토큰당 인프라 비용은 GPU 단가와 사용 시간을 함께 놓고 별도로 계산합니다.
지연시간 지표가 담당하는 구간
평균 TTFT는 벤치마크 클라이언트가 요청을 전송한 시점부터 첫 스트리밍 출력을 수신할 때까지의 평균 시간입니다. 초기 응답성을 나타내며, 서버의 큐 대기·스케줄링·프리필뿐 아니라 네트워크와 클라이언트 처리 시간도 포함될 수 있습니다. TTFT가 늘었다면 어느 구간이 영향을 줬는지 추가로 확인해야 합니다.
평균 ITL은 클라이언트가 연속된 스트리밍 출력을 수신하는 간격을 성공한 요청 전체에서 집계한 값입니다. 한 번의 스트리밍 출력에 여러 토큰이 포함될 수 있으므로 개별 토큰의 생성 간격과 항상 일치하지는 않습니다. 사용자가 느끼는 스트리밍의 연속성과 속도를 파악하는 지표로 봅니다.
TTFT는 첫 응답까지 얼마나 빠른지를, ITL은 스트리밍이 얼마나 매끄러운지를 나타냅니다. 하나는 초기 응답성, 다른 하나는 지속적인 체감 속도를 담당하는 상호보완적 지표입니다.
ITL은 연속된 스트리밍 출력의 수신 간격을 모아 집계합니다. TPOT는 요청별로 (전체 지연시간 − TTFT) / (출력 토큰 수 − 1)을 계산한 뒤 집계합니다. 출력이 한 토큰씩 전달되더라도 두 지표의 집계 단위가 달라 평균값이 다를 수 있습니다. 여러 토큰이 한 번에 전달될 때는 그 차이가 더 커질 수 있습니다. vLLM 벤치마크 문서
결과 해석과 서비스 적용의 한계
실제 서비스에 적용할 때는 처리량뿐 아니라 사전에 정한 TTFT·ITL 목표도 충족하는지 확인해야 합니다. 이번 실습에서는 구체적인 지연시간 임계값을 정하지 않았으므로 설정 간 상대 비교에 집중하고, 원시 측정값과 설정을 함께 남깁니다.
평균값은 일부 요청에서 발생하는 긴 지연을 드러내지 못할 수 있습니다. 이번 결과에는 중앙값과 P99도 포함했지만, 허용 지연시간과 목표 충족 비율을 정하지 않았으므로 서비스 요구사항의 충족 여부까지 판정하지는 않습니다. 실제 적용 전에는 서비스 수준 목표(SLO)를 정하고 해당 백분위수와 오류율을 함께 확인해야 합니다.
4단계 vLLM 서빙 구성
앞에서 정한 트래픽과 지표로 성능을 측정하기 위해 vLLM 서버를 구성했습니다.
Qwen/Qwen3-14B를 단일 A40에서 실행했습니다. 모델의 정밀도, 최대 컨텍스트 길이와 GPU 메모리 할당 비율을 고정하고, 저장공간과 의존성 문제를 해결한 뒤 모델 로딩과 초기화를 확인했습니다.
이번 실습에서 제외한 관측 도구
Pod에 Docker·Docker Compose, nsys, dcgmi가 없어 Prometheus/Grafana 기반 모니터링, NVML PCIe 모니터링, Nsight Systems·Nsight Compute 구성은 이번 실습에서 제외합니다. ncu는 설치되어 있었지만 이번 단계에서는 사용하지 않습니다. 이번 실습은 vLLM 로그와 nvidia-smi, 벤치마크 결과를 중심으로 진행합니다.
vLLM CLI 확인
서빙 명령의 옵션 구조를 확인하기 위해 도움말을 실행했습니다.
!/workspace/llmso/vllm-venv/bin/python -m vllm serve --help
기본 도움말은 개별 옵션보다 설정 그룹을 보여주는 형태였습니다. vLLM import에 46.3초, 도움말 실행에 157.9초가 걸렸고 return code 0으로 정상 종료했습니다. 전체 옵션은 --help=all 또는 설정 그룹별 도움말로 확인할 수 있습니다.
캐시 경로 고정
모델과 데이터셋이 컨테이너의 임시 디스크를 사용하지 않도록 다음 캐시 환경변수를 /workspace/llmso/models 아래로 고정했습니다.
HF_HOMEHF_HUB_CACHEHF_DATASETS_CACHETRANSFORMERS_CACHEVLLM_CACHE_ROOT
이 설정은 모델 다운로드와 캐시가 컨테이너 디스크 부족으로 중단되는 상황을 줄이기 위한 것입니다. 환경변수 값에는 인증 정보가 포함되지 않도록 했습니다.
vLLM 서버 시작
노트북에 서버 실행을 돕는 start_vllm_serve 함수를 정의해 서버를 백그라운드로 실행하고, 출력을 별도 로그 파일에 저장했습니다.
start_vllm_serve(
    model="Qwen/Qwen3-14B",
    host="0.0.0.0",
    port=8000,
    dtype="auto",
    max_model_len=4096,
    gpu_memory_utilization=0.9,
    log_path="/workspace/llmso/logs/vllm-qwen3-14b.log",
)
실행에 사용한 초기 설정은 다음과 같습니다.
| 항목 | 설정 |
|---|---|
| 모델 | Qwen/Qwen3-14B |
| Host | 0.0.0.0 |
| Port | 8000 |
| 데이터 타입 | auto |
| 최대 모델 길이 | 4096 |
| GPU 메모리 할당 비율 | 0.9 |
| 로그 파일 | /workspace/llmso/logs/vllm-qwen3-14b.log |
서버 시작 후 모델 가중치를 다운로드하는 과정에서 다음 오류가 발생했습니다.
OSError: [Errno 122] Disk quota exceeded
기존 50GB 영속 저장공간의 저장공간 부족으로 발생한 오류이며, GPU OOM은 아니었습니다.
이후 저장공간을 200GB로 늘려 해결했습니다. 변경 후 모델 파일을 내려받고 서버를 다시 기동한 과정은 아래에 기록했습니다.
영속 저장공간 확장과 모델 스냅샷 다운로드
저장공간 문제를 해결하기 위해 RunPod 영속 저장공간을 MCP로 200GB로 확장하고 Pod를 재시작했습니다. 새 노트북에서 기존 llmso 커널을 선택한 뒤, 모델 캐시 환경변수를 다시 설정하고 Hugging Face 스냅샷을 먼저 내려받았습니다. vLLM이 실행 중에 가중치를 내려받도록 두지 않고, 로컬 스냅샷 경로를 사용해 서버를 시작하기 위한 준비입니다.
from huggingface_hub import snapshot_download

snapshot_path = snapshot_download(
    repo_id="Qwen/Qwen3-14B",
    cache_dir="/workspace/llmso/models/huggingface/hub",
    max_workers=1,
)
print(snapshot_path)
모델 캐시는 약 28GB였으며, 분할 저장된 가중치 파일 8개와 config.json, 토크나이저 파일을 확인했습니다. 이후 이 로컬 스냅샷 경로를 사용해 서버를 시작했습니다.
로컬 스냅샷으로 vLLM 서버 재기동
start_vllm_serve(
    model=snapshot_path,
    served_model_name="Qwen/Qwen3-14B",
    host="0.0.0.0",
    port=8000,
    dtype="auto",
    max_model_len=4096,
    gpu_memory_utilization=0.9,
    log_path="/workspace/llmso/logs/vllm-qwen3-14b.log",
)
첫 실행에서는 FlashInfer 커널을 빌드하는 과정에서 ninja가 없어 중단됐습니다. vLLM 전용 환경에 ninja를 설치하고 해당 환경의 bin 경로를 PATH에 추가한 뒤 서버를 재기동했습니다.
/usr/bin/uv pip install --python /workspace/llmso/vllm-venv/bin/python --reinstall ninja
export PATH="/workspace/llmso/vllm-venv/bin:$PATH"
재기동 로그에서 Qwen3ForCausalLM, FlashAttention 2, 27.51GiB 체크포인트, safetensors 8/8을 확인했습니다. 모델 로딩에는 약 128초가 걸렸고 27.52GiB를 사용했으며, CUDA Graphs의 PIECEWISE와 FULL 캡처 및 약 11.95GiB의 KV 캐시 확보도 완료됐습니다.
Starting vLLM server on http://0.0.0.0:8000
Application startup complete
health: 200
process status: None
GPU memory: about 42.1 GiB / 46.1 GiB [원기록, 단위 재확인 필요]
로컬 health 요청이 200을 반환하고 프로세스 상태가 None으로 서버가 유지 중임을 확인했습니다. generation_config.json이 temperature, top_k, top_p 값을 덮어쓴다는 경고는 설정 확인 사항으로 남겼습니다.
BF16 서버 재기동 최종 확인
새 노트북에서 독립 셀로 BF16 서버를 다시 기동해 RunPod 환경과 서버 상태를 확인했습니다. 모델 로딩과 KV 캐시 관측값은 앞서 확인한 결과를 유지하고, 이번에는 프로세스와 health 상태를 추가로 점검했습니다.
template: PyTorch 2.8.0 + Jupyter 8888
GPU: NVIDIA A40 (46,068 MiB displayed / about 44.42 GiB usable)
price: $0.44/h
vLLM: 0.28.0
served model: Qwen/Qwen3-14B
PID: 35187
health: 200
elapsed: 14:32
nvidia-smi: 42,139 / 46,068 MiB
프로세스 경과시간이 14분 32초인 시점에 서버가 실행 중이고 /health가 응답하는 것을 확인했습니다. 이 값만으로 서버가 요청을 받을 준비를 마친 정확한 시점이나 순수 모델 초기화 시간을 알 수는 없습니다.
42,139 / 46,068 MiB를 환산하면 약 41.15 / 44.99 GiB입니다. 앞의 42.1 / 46.1 GiB 요약과는 단위가 맞지 않습니다. PyTorch가 보고한 총 메모리 44.42 GiB와의 차이도 원시 로그의 측정 시점과 장치를 다시 확인해야 합니다. 초기 생성 기록의 시간당 $0.49와 재기동 기록의 $0.44는 해당 시점의 기록으로 보존했습니다.
간단한 추론 요청으로 동작 확인
서버가 초기화만 완료된 상태가 아니라 실제 추론 요청까지 처리할 수 있는지 확인하기 위해 간단한 chat completion 요청을 보냈습니다.
import requests

response = requests.post(
    "http://127.0.0.1:8000/v1/chat/completions",
    json={
        "model": "Qwen/Qwen3-14B",
        "messages": [{"role": "user", "content": "Reply with exactly: OK"}],
        "max_tokens": 8,
        "temperature": 0.0,
    },
)
print(response.status_code)
print(response.json())
HTTP 200
elapsed: about 1.52s
usage: prompt_tokens=13, completion_tokens=8
assistant response: received
finish_reason: length
서버가 실제 추론 요청을 처리하는 것을 확인했습니다. 응답에는 <think>가 포함됐고, 출력은 max_tokens=8 제한에 도달해 finish_reason=length로 끝났습니다. 이어지는 본 벤치마크에서는 /v1/completions 경로를 사용했습니다. 위 /v1/chat/completions 동작 확인과 요청 구성이 다르며, 본문에 제시된 벤치마크 명령만으로는 thinking 비활성화 여부를 확인할 수 없습니다.
GPU 메모리와 KV 캐시 관측
모델이 GPU 메모리를 얼마나 사용하고, 남은 공간으로 KV 캐시와 동시 요청을 얼마나 확보하는지 확인했습니다. 이 값은 이후 배치 크기와 max_model_len을 설정하는 기준이 됩니다.
from pathlib import Path

log_path = Path("/workspace/llmso/logs/vllm-qwen3-14b.log")
keywords = (
    "Loading weights took",
    "Model loading took",
    "Available KV cache memory",
    "GPU KV cache size",
    "Maximum concurrency",
    "iteration",
)

for line in log_path.read_text().splitlines():
    if any(keyword in line for keyword in keywords):
        print(line)
Loading weights took 106.29s
Model loading took 27.52 GiB memory and 123.387923s
Available KV cache memory: 11.95 GiB
GPU KV cache size: 78,336 tokens
Maximum concurrency for 4,096 tokens/request: 19.12x
같은 노트북에서 서버가 Prometheus 형식으로 제공하는 지표도 조회했습니다.
import requests

metrics = requests.get("http://127.0.0.1:8000/metrics").text
for line in metrics.splitlines():
    if any(
        name in line
        for name in (
            "num_requests_running",
            "num_requests_waiting",
            "kv_cache_usage_perc",
            "prompt_tokens_total",
            "generation_tokens_total",
            "iteration",
        )
    ):
        print(line)
num_requests_running: 0
num_requests_waiting: 0
kv_cache_usage_perc: 0
prompt_tokens_total: 25616
generation_tokens_total: 6416
iteration histogram: observed
유휴 상태에서 실행했기 때문에 실행 중인 요청과 대기 요청, 현재 KV 캐시 점유율이 0으로 나타났습니다. kv_cache_usage_perc는 현재 점유율이지 누적 cache hit rate가 아니므로, 이 값을 캐시 적중률로 해석하지 않습니다. iteration histogram은 관측값만 기록하고 이번 단계에서는 별도로 해석하지 않습니다.
vLLM의 캐시 설정도 확인했습니다.
block_size: 16
num_gpu_blocks: 4896
kv_cache_size_tokens: 78336
enable_prefix_caching: True
maximum_concurrency: 19.125
cache_config_info에는 위 설정과 함께 설정을 식별하기 위한 SHA-256 해시도 포함되어 있었습니다. 여기서는 메모리와 토큰 수에 직접 영향을 주는 값만 기록합니다.
num_gpu_blocks=4,896과 block_size=16을 곱하면 4,896 x 16 = 78,336 토큰이 됩니다. 시작 시점의 메모리 정보는 다음과 같습니다.
| 항목 | 관측값 |
|---|---|
| 초기 free memory | 44.16 / 44.42 GiB |
목표 사용률 0.9 |
39.98 GiB |
| 가중치 + non-Torch 메모리 | 27.77 GiB |
| Peak activation | 0.26 GiB |
| CUDA Graph | 0.65 GiB |
| 현재 KV 캐시 | 11.95 GiB |
nvidia-smi 사용량 |
42,139 / 46,068 MiB |
모델 가중치가 차지하는 공간은 KV 캐시에 남길 수 있는 용량에 영향을 줍니다. 78,336 / 4,096 = 19.125이므로, 로그의 maximum_concurrency는 요청당 4,096토큰을 가정했을 때 KV 캐시 용량으로 계산한 수용량입니다. 이 값만으로 해당 수의 요청을 목표 지연시간 안에 처리할 수 있다고 판단할 수는 없습니다.
5단계 베이스라인 측정
추가 최적화를 적용하기 전, 같은 BF16 서버에서 ShareGPT와 Prefix Repetition을 각각 측정해 기준선을 확보했습니다. 이후 양자화와 배칭 설정을 비교할 때도 워크로드별 요청 조건과 지표를 유지했습니다.
- 동일한 모델과 정밀도, 동일한 벤치마크 트래픽을 사용합니다.
- 이번 기록에는 워크로드별 본 측정 결과를 남겼습니다. 워밍업 이후 반복 측정으로 결과의 변동 폭을 확인하는 작업은 후속 과제입니다.
- 요청 부하와 컨텍스트 길이를 높여 최대 처리량과 OOM 발생 한계를 찾는 실험은 후속 과제로 남겼습니다.
이 결과를 이후 양자화, 배칭, 캐시 설정 변경의 비교 기준으로 사용합니다.
두 BF16 기준선 한눈에 보기
2단계에서 목적을 나눈 두 데이터셋을 같은 BF16 서버에서 각각 측정해 기준선 두 개를 확보했습니다. 공통 환경과 워크로드별 실행 조건, 그리고 지표 비교는 다음과 같습니다.
| 지표 | 뜻 |
|---|---|
| 요청 처리량 | 초당 완료한 요청 수(req/s) |
| 총 토큰 처리량 | 초당 처리한 입력 토큰과 출력 토큰의 합(tok/s) |
| 출력 토큰 처리량 | 초당 생성한 출력 토큰 수(tok/s) |
| 평균 TTFT | 요청 전송부터 첫 스트리밍 출력 수신까지의 평균 시간(ms). 초기 응답성을 나타냅니다 |
| 평균 ITL | 연속된 스트리밍 출력의 평균 수신 간격(ms). 스트리밍 품질을 나타냅니다 |
각 지표가 요청의 어느 구간을 재는지와 두 처리량 지표를 나누어 보는 이유는 앞의 3단계 평가 지표 정의에서 다뤘습니다. TTFT는 프리필 시간만이 아니라 큐 대기와 스케줄링, 네트워크 처리까지 포함할 수 있고, ITL은 TPOT와 정의가 다를 수 있다는 점도 함께 확인해 두면 아래 수치를 읽기 쉽습니다.

Prefix Repetition의 총 토큰 처리량은 838.55 tok/s로 ShareGPT의 365.03 tok/s보다 약 2.30배 높고, 요청 처리량도 1.31 req/s 대 0.85 req/s입니다. 다만 출력 토큰 처리량은 166.80 tok/s로 ShareGPT의 175.24 tok/s보다 낮으며, 평균 TTFT는 256.23ms 대 214.45ms, 평균 ITL은 58.00ms 대 55.78ms로 Prefix Repetition이 개선되지 않았습니다.
두 워크로드는 입력·출력 길이와 요청률이 다르므로 총 토큰 처리량만으로 캐시 효과나 디코드 성능의 우열을 판단하기 어렵습니다. 총 토큰 처리량은 캐시에서 재사용한 입력도 요청의 입력 토큰 수에 포함해 집계하므로 실제로 수행한 연산량과도 구분해야 합니다. 캐시 재사용의 기여도는 같은 워크로드에서 프리픽스 캐시를 켜고 끈 결과와 캐시 적중률을 비교해야 확인할 수 있습니다.
아래에서는 이 두 기준선을 얻기까지의 사전 측정과 실제 실행 명령, 원시 결과를 순서대로 남깁니다.
소규모 벤치마크로 실행 경로 확인
먼저 요청 50개로 서버와 벤치마크의 실행 경로를 확인했습니다. 이 결과는 본 측정에 앞선 동작 확인 기록으로 남깁니다.
50 successful / 0 failed
duration: 95.61s
request throughput: 0.52 req/s
output throughput: 66.94 tok/s
mean TTFT: 212.68 ms
mean TPOT: 53.85 ms
비표준 예비 측정: Prefix Repetition 1,000개
표준 조건을 정하기 전에 request-rate 1, max-concurrency 4, 공통 프리픽스 5개로 1,000개 요청을 측정했습니다. 이 결과는 시행착오로만 남기며, 표준 기준선과 직접 비교하지 않습니다.
1000 successful / 0 failed
request throughput: 0.57 req/s
output token throughput: 72.44 tok/s
mean TTFT: 208.48 ms
mean ITL: 53.87 ms
본 기준선: Prefix Repetition 1,000개
단일 NVIDIA A40, BF16, vLLM 0.28.0, 로컬 Qwen3-14B 스냅샷, max_model_len=4096, gpu_memory_utilization=0.9 환경에서 표준 Prefix Repetition 조건을 측정했습니다. 프리픽스 길이 256, 서픽스 길이 256, 공통 프리픽스 10개, 출력 길이 128, request-rate 5, max-concurrency 10, temperature=0, seed=0을 사용했으며 프리픽스 캐싱과 청크 단위 프리필은 기본 활성 상태였습니다.
/workspace/llmso/vllm-venv/bin/vllm bench serve \
  --backend vllm \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --dataset-name prefix_repetition \
  --num-prompts 1000 \
  --request-rate 5 \
  --burstiness 1.0 \
  --max-concurrency 10 \
  --prefix-repetition-prefix-len 256 \
  --prefix-repetition-suffix-len 256 \
  --prefix-repetition-num-prefixes 10 \
  --prefix-repetition-output-len 128 \
  --model "$snapshot_path" \
  --served-model-name Qwen/Qwen3-14B \
  --temperature 0 \
  --seed 0 \
  --save-result \
  --result-filename /workspace/llmso/logs/baseline-prefix-1000-bf16.json
Successful requests: 1000
Failed requests: 0
Duration: 762.22s (about 12m42s)
Total input tokens: 512028
Total generated tokens: 127136
Request throughput: 1.31 req/s
Output token throughput: 166.80 tok/s
Peak output token throughput: 190.00 tok/s
Total token throughput: 838.55 tok/s
Mean TTFT: 256.23 ms
Median TTFT: 216.13 ms
P99 TTFT: 405.32 ms
Mean TPOT: 58.01 ms
Median TPOT: 58.14 ms
P99 TPOT: 59.13 ms
Mean ITL: 58.00 ms
Median ITL: 54.39 ms
P99 ITL: 110.69 ms
이 표준 결과를 Prefix Repetition의 BF16 기준선으로 사용합니다.
본 기준선: ShareGPT 2,000개
일반적인 대화형 서빙의 기준선을 확보하기 위해 원본 ShareGPT 트래픽을 같은 BF16 서버에서 측정했습니다. RunPod NVIDIA A40에서 Qwen/Qwen3-14B를 사용하고, 요청 2,000개에 목표 요청 도착률 10 req/s, 최대 동시 요청 수 10, temperature=0, seed=0 조건으로 실행했습니다.
/workspace/llmso/vllm-venv/bin/vllm bench serve \
  --backend vllm \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --dataset-name sharegpt \
  --dataset-path /workspace/llmso/models/ShareGPT_V3_unfiltered_cleaned_split.json \
  --num-prompts 2000 \
  --request-rate 10 \
  --burstiness 1.0 \
  --max-concurrency 10 \
  --model "$snapshot_path" \
  --served-model-name Qwen/Qwen3-14B \
  --temperature 0 \
  --seed 0 \
  --save-result \
  --result-filename /workspace/llmso/logs/baseline-sharegpt-2000-bf16.json
Successful requests: 2000
Failed requests: 0
Duration: 2353.23s (about 39m13s)
Total input tokens: 446619
Total generated tokens: 412381
Request throughput: 0.85 req/s
Output token throughput: 175.24 tok/s
Peak output token throughput: 190.00 tok/s
Total token throughput: 365.03 tok/s
Mean TTFT: 214.45 ms
Median TTFT: 179.96 ms
P99 TTFT: 435.45 ms
Mean TPOT: 55.78 ms
Median TPOT: 55.25 ms
P99 TPOT: 67.07 ms
Mean ITL: 55.78 ms
Median ITL: 53.91 ms
P99 ITL: 135.20 ms
이 결과를 자연어 대화 트래픽에 대한 BF16 기준선으로 사용합니다. 원본 노트북의 예시 결과는 L40S와 다른 버전·환경에서 측정됐고, 이번 결과는 A40에서 얻은 실측값이므로 동일한 수치를 기대하지 않습니다. 다음 양자화 비교에서는 BF16과 AWQ가 각각 같은 두 워크로드와 같은 요청 조건을 사용하도록 구성합니다.
6단계 양자화 비교
BF16은 16비트 부동소수점 형식입니다. 이번 AWQ 모델은 가중치를 4비트로 양자화하고 활성화 값을 16비트로 처리하는 W4A16 구성입니다. 가중치 양자화와 KV 캐시의 정밀도 변경은 별개의 설정입니다.
BF16과 AWQ 모델의 메모리 사용량과 서빙 성능을 비교했습니다. 먼저 모델 로딩과 KV 캐시 수용량을 확인한 뒤, Prefix Repetition과 ShareGPT를 워크로드별로 같은 요청 조건에서 측정했습니다.
- 원본 정밀도와 양자화 모델의 모델 크기, 가용 KV 캐시 공간을 비교합니다.
- 이번 실험에서는 AWQ W4A16 모델의 처리량과 지연시간을 측정했습니다.
- 양자화 전후의 응답 품질과 정확도 평가는 수행하지 않았으므로, 결과는 메모리와 서빙 성능 비교로 한정합니다.
A40에서 실제로 사용할 수 있는 양자화 포맷과 커널 지원 여부를 먼저 확인하고, 한 번에 하나의 정밀도만 변경해 효과를 분리합니다. 두 모델의 서버 이름과 로컬 모델 경로는 다음처럼 구분합니다.
| 모델 | --model |
--served-model-name |
정밀도 |
|---|---|---|---|
| BF16 | $snapshot_path |
Qwen/Qwen3-14B |
BF16 |
| AWQ | $awq_snapshot_path |
Qwen/Qwen3-14B-AWQ |
AWQ W4A16 |
각 모델에서 표준 Prefix Repetition은 1,000 prompts, 프리픽스/서픽스 256, 공통 프리픽스 10개, output 128, request-rate 5, max-concurrency 10 조건을 사용합니다. ShareGPT는 2,000 prompts, request-rate 10, max-concurrency 10 조건을 사용합니다. 모델별로 --model에는 해당 로컬 스냅샷을 지정하고, 요청의 모델 이름은 실행 중인 서버의 --served-model-name과 일치시킵니다.
AWQ 서버 로딩과 메모리 비교
AWQ 모델의 기동을 확인하고 BF16 모델과 GPU 메모리 및 KV 캐시 수용량을 비교했습니다. 이어지는 절에서는 두 워크로드의 처리량과 지연시간 측정 결과를 살펴봅니다.
start_vllm_serve(
    model=awq_snapshot_path,
    served_model_name="Qwen/Qwen3-14B-AWQ",
    host="0.0.0.0",
    port=8000,
    dtype="auto",
    max_model_len=4096,
    gpu_memory_utilization=0.9,
    log_path="/workspace/llmso/logs/vllm-qwen3-14b-awq.log",
)
served model: Qwen/Qwen3-14B-AWQ
health: 200
Loading weights took 61.25s
Model loading took 9.44 GiB memory and 93.062972s
Available KV cache memory: 28.79 GiB
GPU KV cache size: 188,688 tokens
Maximum concurrency for 4,096 tokens/request: 46.07x
Startup consumed: 9.71 GiB
Peak activation: 1.48 GiB
CUDA graph: 0.71 GiB
nvidia-smi: 40,989 / 46,068 MiB
BF16과 AWQ의 로딩 및 캐시 수용량은 다음과 같습니다.
도식에 수치를 넣지 않은 나머지 항목은 다음과 같습니다. Startup consumed는 BF16 27.77 GiB와 AWQ 9.71 GiB, Peak activation은 0.26 GiB와 1.48 GiB, CUDA graph는 0.65 GiB와 0.71 GiB입니다.
AWQ 서버는 health 200으로 정상 기동했습니다. 모델 로딩에 사용된 GPU 메모리는 BF16의 27.52 GiB에서 AWQ의 9.44 GiB로 줄었고, KV 캐시에 할당할 수 있는 공간은 11.95 GiB에서 28.79 GiB로 늘었습니다. 가중치가 차지하는 공간이 줄어 더 긴 요청이나 더 많은 동시 요청을 수용할 여유가 생긴 것입니다. 실제 처리량과 지연시간 변화는 다음 벤치마크에서 확인합니다.
AWQ ShareGPT 요청 2,000개 벤치마크
BF16 기준선과 같은 원본 ShareGPT 데이터셋과 샘플링 설정으로 AWQ 서버의 성능을 측정했습니다. 두 실험은 max_model_len=4096, 요청률 10 req/s, 최대 동시 요청 수 10, temperature=0, seed=0을 유지했습니다. AWQ에서는 모델 체크포인트 경로와 서빙 모델 이름을 바꿨습니다.
/workspace/llmso/vllm-venv/bin/vllm bench serve \
  --backend vllm \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --dataset-name sharegpt \
  --dataset-path /workspace/llmso/models/ShareGPT_V3_unfiltered_cleaned_split.json \
  --num-prompts 2000 \
  --request-rate 10 \
  --burstiness 1.0 \
  --max-concurrency 10 \
  --model "$awq_snapshot_path" \
  --served-model-name Qwen/Qwen3-14B-AWQ \
  --temperature 0 \
  --seed 0 \
  --save-result
Successful requests: 2000
Failed requests: 0
Duration: 885.26s
Total input tokens: 446619
Total generated tokens: 412219
Request throughput: 2.26 req/s
Output token throughput: 465.65 tok/s
Peak output token throughput: 570.00 tok/s
Total token throughput: 970.16 tok/s
Mean TTFT: 134.01 ms
Median TTFT: 94.96 ms
P99 TTFT: 421.05 ms
Mean TPOT: 20.90 ms
Median TPOT: 20.11 ms
P99 TPOT: 37.20 ms
Mean ITL: 20.79 ms
Median ITL: 18.08 ms
P99 ITL: 115.16 ms
입력 토큰 수는 BF16과 AWQ가 모두 446,619개로 같았고, 생성 토큰 수는 BF16 412,381개, AWQ 412,219개로 162개, 약 0.04% 차이였습니다. 같은 데이터셋과 샘플링 설정을 사용한 비교이며, 샘플이 완전히 동일한지는 입력 토큰의 합계만이 아니라 요청별 입력 기록으로 확인할 수 있습니다.
| 지표 | BF16 | AWQ | 변화 |
|---|---|---|---|
| Duration | 2,353.23s | 885.26s | 약 62.4% 감소 |
| 요청 처리량 | 0.85 req/s | 2.26 req/s | 약 2.66배, 약 166% 증가 |
| 출력 토큰 처리량 | 175.24 tok/s | 465.65 tok/s | 약 2.66배, 약 166% 증가 |
| 총 토큰 처리량 | 365.03 tok/s | 970.16 tok/s | 약 2.66배, 약 166% 증가 |
| 평균 TTFT | 214.45 ms | 134.01 ms | 약 37.5% 감소 |
| Median TTFT | 179.96 ms | 94.96 ms | 약 47.2% 감소 |
| P99 TTFT | 435.45 ms | 421.05 ms | 약 3.3% 감소 |
| Mean TPOT | 55.78 ms | 20.90 ms | 약 62.5% 감소 |
| 평균 ITL | 55.78 ms | 20.79 ms | 약 62.7% 감소 |
AWQ에서 처리량과 평균 지연시간이 개선됐지만, 이를 KV 캐시 용량 증가 하나로 설명할 수는 없습니다. BF16의 KV 캐시 수용량을 요청당 4,096토큰으로 나누면 약 19.12건에 해당합니다. 이는 메모리 용량을 바탕으로 계산한 값이며, 실제 동시 처리 성능의 측정값은 아닙니다. 이번 벤치마크의 최대 동시 요청 수는 10이므로, 가중치 용량과 메모리 접근량 감소, 양자화 커널의 영향도 원인 후보로 볼 수 있습니다. 각 요인의 기여도는 추가 측정이 필요합니다.
P99 TTFT의 감소 폭은 약 3.3%로 평균 TTFT의 감소 폭보다 작았습니다. 따라서 평균 지연시간 개선만으로 지연이 긴 요청까지 비슷하게 개선됐다고 볼 수는 없습니다. 책의 절대 성능값은 다른 L40S·버전·환경에서 얻은 참고값이므로 이번 A40 측정값과 구분하고, 같은 조건에서 얻은 BF16 대비 개선 폭을 중심으로 해석합니다.
AWQ Prefix Repetition 표준 벤치마크
AWQ에서도 같은 Prefix Repetition 조건을 사용해 양자화 전후의 합성 cache 워크로드를 비교했습니다. max_model_len=4096, 프리픽스/서픽스 256, 공통 프리픽스 10개, output 128, request-rate 5, max-concurrency 10, temperature=0, seed=0을 유지했습니다.
/workspace/llmso/vllm-venv/bin/vllm bench serve \
  --backend vllm \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --dataset-name prefix_repetition \
  --num-prompts 1000 \
  --request-rate 5 \
  --burstiness 1.0 \
  --max-concurrency 10 \
  --prefix-repetition-prefix-len 256 \
  --prefix-repetition-suffix-len 256 \
  --prefix-repetition-num-prefixes 10 \
  --prefix-repetition-output-len 128 \
  --model "$awq_snapshot_path" \
  --served-model-name Qwen/Qwen3-14B-AWQ \
  --temperature 0 \
  --seed 0 \
  --save-result
Successful requests: 1000
Failed requests: 0
Duration: 321.70s
Total input tokens: 512028
Total generated tokens: 127474
Request throughput: 3.11 req/s
Output token throughput: 396.25 tok/s
Peak output token throughput: 550.00 tok/s
Total token throughput: 1987.89 tok/s
Mean TTFT: 268.44 ms
Median TTFT: 222.80 ms
P99 TTFT: 526.41 ms
Mean TPOT: 23.11 ms
Median TPOT: 23.54 ms
P99 TPOT: 24.92 ms
Mean ITL: 23.11 ms
Median ITL: 18.57 ms
P99 ITL: 104.90 ms
BF16과 AWQ 모두 입력 토큰 수는 512,028개였고, 생성 토큰 수는 BF16 127,136개, AWQ 127,474개로 338개, 약 0.27% 차이였습니다. 같은 합성 데이터 생성 조건과 비슷한 출력량을 사용했으므로 이 조건에서의 성능 차이를 비교합니다.
| 지표 | BF16 | AWQ | 변화 |
|---|---|---|---|
| Duration | 762.22s | 321.70s | 약 57.8% 감소, 약 2.37배 빠름 |
| 요청 처리량 | 1.31 req/s | 3.11 req/s | 기존의 약 2.37배로 증가 |
| 출력 토큰 처리량 | 166.80 tok/s | 396.25 tok/s | 기존의 약 2.37배로 증가 |
| 총 토큰 처리량 | 838.55 tok/s | 1,987.89 tok/s | 기존의 약 2.37배로 증가 |
| 평균 TTFT | 256.23 ms | 268.44 ms | 약 4.8% 증가 |
| Median TTFT | 216.13 ms | 222.80 ms | 약 3.1% 증가 |
| P99 TTFT | 405.32 ms | 526.41 ms | 약 29.9% 증가 |
| Mean TPOT | 58.01 ms | 23.11 ms | 약 60.2% 감소 |
| 평균 ITL | 58.00 ms | 23.11 ms | 약 60.2% 감소 |
| P99 ITL | 110.69 ms | 104.90 ms | 약 5.2% 감소 |
AWQ는 Prefix Repetition에서도 디코드에 해당하는 TPOT와 ITL, 출력 처리량을 크게 개선했지만 TTFT는 평균·중앙값·P99 모두 증가했습니다. 따라서 프리픽스에서도 모든 지표가 같은 방향으로 개선된 것은 아니며, 프리필과 디코드의 영향을 나누어 해석해야 합니다.
두 워크로드 종합
두 워크로드의 변화를 나란히 놓으면 AWQ의 효과가 지표마다 같은 방향이 아니라는 점이 분명해집니다.

처리량 세 지표와 평균 ITL은 두 워크로드 모두 개선됐습니다. 반면 TTFT는 ShareGPT에서 줄고 Prefix Repetition에서는 늘었으며, 특히 Prefix Repetition의 P99 TTFT가 약 29.9% 증가했습니다. 처리량과 초기 응답성이 서로 다른 방향으로 변했으므로, 실제 서비스에 적용할 때는 워크로드별 지연시간 목표와 함께 판단해야 합니다.
AWQ 내부에서 비교하면 Prefix Repetition의 총 토큰 처리량 1,987.89 tok/s는 ShareGPT의 970.16 tok/s보다 약 2.05배 높지만, 출력 토큰 처리량은 396.25 tok/s로 ShareGPT의 465.65 tok/s보다 낮습니다. 입력·출력 길이와 요청률이 다른 워크로드의 비교이므로 이 차이를 캐시 재사용 효과로 단정할 수 없습니다. 총 토큰 처리량에는 캐시에서 재사용한 입력도 포함된다는 점을 고려하고, 캐시 효과는 동일한 워크로드의 대조 실험으로 확인해야 합니다. 벤치마크 프로세스의 Zs 상태는 종료 후 부모 프로세스가 아직 회수하지 않은 상태를 뜻하며, 성공 여부는 요청 결과와 종료 코드를 기준으로 판단합니다.
7단계 워크로드 맞춤 최적화
앞선 비교에 이어 AWQ 서버의 배칭·GPU 메모리 설정을 바꾼 네 후보를 측정했습니다. 두 워크로드에서 각각 200개 요청을 사용한 소규모 비교이며, 결과의 차이와 실험 한계를 함께 살펴봅니다.
워크로드에 따른 최적화 선택
워크로드의 병목에 따라 먼저 검토할 최적화 기법이 달라집니다. LMCache와 추측 디코딩은 이번 7단계에서 실행하지 않은 후속 검토 항목입니다.
| 워크로드 특성 | 우선 검토할 기법 | 검토 이유 |
|---|---|---|
| 긴 입력 처리, 반복되는 공통 문맥 | LMCache를 통한 KV 캐시 재사용 | 반복되는 프리필 결과를 재사용해 입력 처리 비용을 줄이는 후보 |
| 긴 출력, 디코드 비중이 큼 | 추측 디코딩 | 여러 토큰을 추측한 뒤 검증해 디코드 반복 횟수를 줄이는 후보 |
| 일반적인 ShareGPT 대화 트래픽 | 배치 처리, 프리픽스 캐시, 스케줄링 | 입력과 출력이 섞인 워크로드에서 GPU 활용과 대기시간을 함께 조정하는 후보 |
메모리·KV 캐시와 배칭·스케줄링 관련 주요 설정은 다음과 같습니다.
gpu-memory-utilization: vLLM 모델 실행기에 할당할 GPU 메모리 비율입니다. 실측 사용률이 아니라 설정값입니다. 값을 높이면 KV 캐시 공간이 늘 수 있지만 다른 메모리 할당을 위한 여유가 줄어들 수 있습니다.max-model-len: 입력과 출력을 합한 요청당 최대 토큰 수입니다. 원본 ShareGPT의 요청 길이를 확인하지 않고 작은 값을 지정하면 요청을 처리하지 못하거나 출력 길이를 제한해야 할 수 있습니다.block-size: KV 캐시 블록 하나에 담는 토큰 수입니다. 실제 로그와 vLLM 버전별 지원 여부를 확인한 뒤 변경 후보로 삼습니다.max-num-seqs: 스케줄링 한 회에 처리할 시퀀스 수의 상한입니다. 값을 높이면 병렬성이 커질 수 있지만 KV 캐시와 메모리 사용량도 함께 늘어납니다.max-num-batched-tokens: 스케줄링 한 회에 처리할 전체 토큰 수의 상한입니다. 긴 프리필을 얼마나 공급할지와 청크 단위 프리필의 작업 단위를 함께 좌우하므로 TTFT와 ITL을 함께 관찰하며 조정합니다.enable-prefix-caching과enable-chunked-prefill: 현재 서버 로그에서True로 확인된 기본 활성 상태입니다.
--max-paddings는 현재 vLLM 0.28.0 serve에서의 지원 여부를 확인하지 못했으므로 실행 가능한 권장값으로 단정하지 않습니다. max-num-seqs=512 같은 큰 값도 이번 벤치마크의 max-concurrency=10과 KV 캐시 여유를 고려하면 그대로 권장하기 어렵습니다.
실험 설계
목적은 vLLM의 자동 배치 설정을 기준으로 max-num-batched-tokens와 GPU 메모리 할당 비율을 바꿨을 때 처리량과 지연시간이 어떻게 달라지는지 확인하는 것입니다.
아래 파일명은 실행 기록입니다. 현재 원고에 스크립트 본문이 첨부되어 있지 않아 재현하려면 원본 파일을 함께 제공해야 합니다.
네 후보는 공통 실행기와 후보별 래퍼 스크립트로 실행했습니다. 공통 실행기는 AWQ 서버를 기동하고 ShareGPT·Prefix Repetition 축약 벤치마크를 순서대로 실행하며, 후보별 래퍼는 변경할 인자만 전달합니다.
- 공통 실행기:
step07-run-awq-candidate.sh - 후보 1: 자동 설정:
step07-candidate-01-auto.sh - 후보 2: 2048 토큰:
step07-candidate-02-batch-2048.sh - 후보 3: 8192 토큰:
step07-candidate-03-batch-8192.sh - 후보 4: 자동 배치와 GPU 메모리 0.95:
step07-candidate-04-winner-gpu95.sh
비교 지표는 총 토큰 처리량, 출력 토큰 처리량, 평균 TTFT, 평균 ITL과 오류율입니다.
후보 1: AWQ 기준 설정
후보 1은 max-num-batched-tokens를 생략한 대조군입니다. 여기서 자동 배치는 vLLM이 선택한 설정을 뜻하며, gpu-memory-utilization=0.90은 이번 실험에서 명시한 기준값입니다. max-model-len=4096, gpu-memory-utilization=0.90, 프리픽스 캐시와 청크 단위 프리필이 활성화된 상태에서 축약된 ShareGPT와 Prefix Repetition을 각각 실행했습니다.
ShareGPT (200 requests, rate 10, max-concurrency 10, temperature 0, seed 0)
successful: 200 / 200
total token throughput: 876.09 tok/s
output token throughput: 443.69 tok/s
mean TTFT: 129.72 ms
mean ITL: 20.42 ms

Prefix Repetition (200 requests, rate 5, max-concurrency 10,
prefix 256, suffix 256, shared prefixes 10, output 128,
temperature 0, seed 0)
successful: 200 / 200
duration: 63.76s
input tokens: 102409
generated tokens: 25482
request throughput: 3.14 req/s
output token throughput: 399.64 tok/s
total token throughput: 2005.76 tok/s
mean TTFT: 472.52 ms
P99 TTFT: 775.44 ms
mean TPOT: 21.15 ms
mean ITL: 21.14 ms
P99 ITL: 102.91 ms
짧은 표본에서 Prefix Repetition의 TTFT가 높게 측정됐으므로 개선이나 일반적인 성능 특성으로 해석하지 않습니다. 후보 2~4도 같은 축약 워크로드와 지표를 사용해 설정 변경의 상대적인 차이를 비교했습니다. 소규모 비교에서 뚜렷한 처리량 개선을 확인하지 못해, 변경한 후보로 6단계 규모의 벤치마크를 다시 실행하지는 않았습니다.
후보 2: AWQ + max-num-batched-tokens=2048
후보 2는 후보 1과 같은 AWQ 서버 설정에서 --max-num-batched-tokens 2048만 추가한 구성입니다. max-model-len=4096, gpu-memory-utilization=0.90, 프리픽스 캐시와 청크 단위 프리필이 활성화된 상태를 유지하고 같은 축약 워크로드를 실행했습니다.
ShareGPT (200 requests, rate 10, max-concurrency 10, temperature 0, seed 0)
successful: 200 / 200
total token throughput: 870.89 tok/s
output token throughput: 441.05 tok/s
mean TTFT: 166.10 ms
mean TPOT: 20.29 ms
mean ITL: 20.41 ms
P99 TTFT: 1212.08 ms
P99 ITL: 107.69 ms

Prefix Repetition (200 requests, rate 5, max-concurrency 10,
prefix 256, suffix 256, num-prefixes 10, output 128,
temperature 0, seed 0)
successful: 200 / 200
duration: 63.84 s
input tokens: 102409
generated tokens: 25482
request throughput: 3.13 req/s
output token throughput: 399.17 tok/s
total token throughput: 2003.38 tok/s
mean TTFT: 463.03 ms
median TTFT: 450.69 ms
P99 TTFT: 784.00 ms
mean TPOT: 21.25 ms
mean ITL: 21.26 ms
P99 ITL: 100.60 ms
후보 1과 비교하면 ShareGPT의 total·출력 토큰 처리량은 각각 약 0.59% 낮아졌고, 평균 TTFT는 약 28% 증가했습니다. 평균 ITL은 거의 같았습니다. Prefix Repetition에서는 total·출력 토큰 처리량이 약 0.12% 낮아졌고, 평균 TTFT는 약 2.0% 줄었지만 평균 ITL은 약 0.6% 늘었습니다. 이번 표본에서는 2048 설정의 뚜렷한 개선을 확인하지 못해 후속 실험의 기준으로 채택하지 않았습니다.
후보 3: AWQ + max-num-batched-tokens=8192
후보 3은 후보 1과 같은 AWQ 서버 설정에서 --max-num-batched-tokens 8192만 추가한 구성입니다. max-model-len=4096, gpu-memory-utilization=0.90, 프리픽스 캐시와 청크 단위 프리필이 활성화된 상태를 유지하고 후보 1·2와 같은 축약 워크로드를 실행했습니다.
ShareGPT (200 requests, rate 10, max-concurrency 10, temperature 0, seed 0)
successful: 200 / 200
total token throughput: 874.59 tok/s
output token throughput: 442.93 tok/s
mean TTFT: 156.58 ms
median TTFT: 97.43 ms
P99 TTFT: 1004.62 ms
mean TPOT: 20.26 ms
mean ITL: 20.36 ms
P99 ITL: 107.23 ms

Prefix Repetition (200 requests, rate 5, max-concurrency 10,
prefix 256, suffix 256, num-prefixes 10, output 128,
temperature 0, seed 0)
successful: 200 / 200
duration: 63.79 s
input tokens: 102409
generated tokens: 25482
request throughput: 3.14 req/s
output token throughput: 399.44 tok/s
total token throughput: 2004.74 tok/s
mean TTFT: 471.35 ms
median TTFT: 531.23 ms
P99 TTFT: 741.15 ms
mean TPOT: 21.17 ms
mean ITL: 21.17 ms
P99 ITL: 98.05 ms
후보 1~3의 처리량 차이는 약 0.6% 이내였습니다. 후보 3은 후보 1보다 ShareGPT의 총 토큰 처리량이 약 0.17%, Prefix Repetition은 약 0.05% 낮았습니다. 이번 비교에서 8192 설정의 뚜렷한 처리량 개선은 확인하지 못했습니다. 후보 4에서는 자동 배치 설정을 유지한 채 gpu-memory-utilization=0.95만 비교합니다.
후보 4: AWQ 기본 배치와 gpu-memory-utilization=0.95
후보 4는 max-num-batched-tokens를 별도로 지정하지 않고, 후보 1과 같은 AWQ 자동 배치 설정에서 gpu-memory-utilization만 0.90에서 0.95로 높인 구성입니다. max-model-len=4096, 프리픽스 캐시와 청크 단위 프리필이 활성화된 상태를 유지하고 같은 축약 워크로드를 실행했습니다.
ShareGPT (200 requests, rate 10, max-concurrency 10, temperature 0, seed 0)
successful: 200 / 200
total token throughput: 872.76 tok/s
output token throughput: 442.00 tok/s
mean TTFT: 159.00 ms
median TTFT: 95.42 ms
P99 TTFT: 1130.46 ms
mean ITL: 20.40 ms
P99 ITL: 109.21 ms

Prefix Repetition (200 requests, rate 5, max-concurrency 10,
prefix 256, suffix 256, num-prefixes 10, output 128,
temperature 0, seed 0)
successful: 200 / 200
duration: 63.72 s
input tokens: 102409
generated tokens: 25482
output token throughput: 399.90 tok/s
total token throughput: 2007.04 tok/s
mean TTFT: 487.57 ms
median TTFT: 551.80 ms
P99 TTFT: 752.28 ms
mean TPOT: 21.02 ms
mean ITL: 21.01 ms
P99 ITL: 96.89 ms
비교와 최종 결론
수동으로 조정한 후보들의 처리량은 자동 배치 설정을 사용한 후보 1과 큰 차이가 없었습니다. 지연시간은 별도로 살펴볼 필요가 있으므로, 각 지표의 최솟값 대비 편차를 함께 시각화했습니다.

| 워크로드 / 지표 | 후보 1 auto, 0.90 |
후보 2 2048, 0.90 |
후보 3 8192, 0.90 |
후보 4 auto, 0.95 |
|---|---|---|---|---|
| ShareGPT 총 토큰 처리량 (tok/s) | 876.09 | 870.89 | 874.59 | 872.76 |
| ShareGPT 출력 토큰 처리량 (tok/s) | 443.69 | 441.05 | 442.93 | 442.00 |
| ShareGPT 평균 TTFT (ms) | 129.72 | 166.10 | 156.58 | 159.00 |
| ShareGPT 평균 ITL (ms) | 20.42 | 20.41 | 20.36 | 20.40 |
| Prefix Repetition 총 토큰 처리량 (tok/s) | 2005.76 | 2003.38 | 2004.74 | 2007.04 |
| Prefix Repetition 출력 토큰 처리량 (tok/s) | 399.64 | 399.17 | 399.44 | 399.90 |
| Prefix Repetition 평균 TTFT (ms) | 472.52 | 463.03 | 471.35 | 487.57 |
| Prefix Repetition 평균 ITL (ms) | 21.14 | 21.26 | 21.17 | 21.01 |
ShareGPT의 처리량 차이는 후보 간 0.6% 이내, Prefix Repetition은 0.2% 이내였습니다. 다만 후보별 반복 측정 결과가 없어 이 차이가 설정 변경의 효과인지 측정 변동인지 판단하기 어렵습니다. ShareGPT의 평균 TTFT는 후보 간 최대 약 28% 차이가 났으므로 지연시간까지 모두 같다고 보기도 어렵습니다. gpu-memory-utilization=0.95에서도 이번 최대 동시 요청 수 10 조건에서는 뚜렷한 처리량 개선을 확인하지 못했습니다.
후속 실험의 기준 설정은 max-num-batched-tokens를 별도로 지정하지 않는 AWQ 자동 배치와 gpu-memory-utilization=0.90으로 유지합니다. 이번 소규모 비교에서는 수동 설정을 추가할 만큼 뚜렷한 처리량 개선을 확인하지 못했으며, 워크로드와 vLLM 버전이 달라지면 다시 비교해야 합니다.
실험 한계와 다음 작업
이번 비교는 워크로드별 200개 요청으로 범위를 줄였으며, 후보별 반복 측정 결과는 남기지 않았습니다. 따라서 작은 차이를 설정 변경의 효과로 확정하기는 어렵습니다. 후속 실험에서는 워밍업과 반복 측정 조건을 정하고, 지연시간 목표와 GPU 메모리 사용량을 함께 확인할 필요가 있습니다.
LMCache와 추측 디코딩은 이번에 실행하지 않았습니다. 후속 실험에서도 ShareGPT와 Prefix Repetition을 분리해 측정하고, 기법별 효과를 비교할 계획입니다.
8단계 분산 서빙
분산 서빙은 이번 실습에서 실행하지 않았습니다. 다음 실험에서는 단일 A40의 측정값을 기준으로 GPU를 추가했을 때의 확장 방식을 비교할 계획입니다.
- 요청을 여러 모델 복제본에 분산하는 수평 확장과 하나의 모델을 여러 GPU에 나누는 텐서 병렬화를 구분합니다.
- 모델 복제본을 늘렸을 때 처리량, 비용, 라우팅 효율과 프리픽스 캐시 hit 변화를 비교합니다.
- 모델이 한 GPU에 올라가지 않는 경우에는 GPU 간 인터커넥트와 통신 오버헤드를 포함해 텐서 병렬화·파이프라인 병렬화를 검토합니다.
- 여러 노드를 사용하면 노드 간 통신, 네트워크 대역폭과 운영 복잡도까지 측정 범위에 포함합니다.
한국어 특화 모델 vLLM 서빙 실습
앞선 Qwen3-14B 실습에서는 모델 정밀도와 서빙 설정에 따른 성능 변화를 비교했습니다. 이어지는 실습에서는 A.X-4.0-Light와 EXAONE-4.0-32B-AWQ를 vLLM 서버, API와 Gradio UI에 연결했습니다. 여기서는 구축 과정의 호환성 문제와 한국어 요청의 동작 확인에 초점을 맞춥니다.
A.X-4.0-Light 공식 모델카드와 A.X 공식 GitHub 저장소는 이 모델을 7B 파라미터, BF16 형식, 최대 16,384 토큰 컨텍스트 모델로 설명합니다. 모델카드의 KMMLU 64.15와 CLIcK 68.05는 Light 모델의 값입니다. KMMLU 78.3과 CLIcK 83.5는 72B A.X 4.0 모델의 값이므로 Light 모델의 성능으로 옮겨 쓰지 않습니다.
EXAONE-4.0-32B-AWQ 공식 모델카드와 EXAONE 4.0 공식 GitHub 저장소 기준 EXAONE4.0은 2025년 7월 15일 공개된 32B 모델이며, 최대 131,072 토큰 컨텍스트와 공식 AWQ 체크포인트를 제공합니다. EXAONE-4.0-32B-FP8 체크포인트도 확인할 수 있습니다.
목표와 모델 후보
다음 두 모델을 대상으로 GPU 메모리, 양자화 형식과 패키지 호환성을 확인하고, API와 Gradio UI에서 한국어 응답을 받는 과정을 검증했습니다.
| 모델 | 실습 GPU 메모리 | 이번 실습에서의 역할 |
|---|---|---|
| A.X-4.0-Light | 16GB급 | 해당 환경에서 서버를 구축하고 API·UI 연결을 확인. 일반적인 최소 메모리 요구량을 뜻하지는 않음 |
| EXAONE4.0-32B | 48GB급 | RunPod A40에서 AWQ 서버, API·UI와 한국어 스트리밍 응답을 확인. 최대 컨텍스트 길이는 4,096으로 설정 |
EXAONE4.0-32B는 A40에서 공식 AWQ 체크포인트로 실행했습니다. vLLM의 양자화 하드웨어 호환성 표에서 AWQ는 Ampere를 지원하지만 FP8 W8A8은 Ampere 지원 대상으로 표시되지 않으므로, A40에서 FP8 성능을 전제로 계획하지 않습니다.
A.X-4.0-Light 구축 환경
다음은 이번에 실제로 완료한 A.X-4.0-Light 구축 결과입니다.
- vLLM 서버와 OpenAI 호환 API 실행을 확인했습니다.
transformers==4.52.4,fastapi==0.115.12를 사용해 패키지 호환성 문제를 정리했습니다.- FlashInfer를 설치해 어텐션·샘플링 커널을 사용할 수 있는 환경을 구성했습니다.
- 서버는
--gpu-memory-utilization 0.95와--enforce-eager옵션으로 실행했습니다. - API 응답을 받고 Gradio 화면에 표시되는 것까지 확인했습니다.
transformers==4.52.4와 fastapi==0.115.12는 이번 A.X-4.0-Light 실습 환경에서 확인한 해결 사례입니다. 다른 환경에서는 transformers==5.16.1, vllm==0.9.0.1, fastapi==0.141.1 조합에서 충돌이 관찰될 수 있으므로, 이 버전 고정을 모든 vLLM 환경의 일반 규칙으로 적용하지 않습니다.
디렉터리 구조와 파일 역할
실습에 사용한 최소 구조는 다음과 같습니다. 실제 프로젝트 루트의 절대 경로는 실행 환경에 따라 달라지므로 이 문서에서는 고정하지 않습니다.
<project-root>/
├── serve_vllm.sh   # vLLM 서버 실행 옵션과 환경변수 관리
├── app.py          # vLLM OpenAI 호환 API를 호출하는 Gradio UI
├── models/         # 모델 가중치와 토크나이저 캐시
└── logs/           # 서버와 애플리케이션 로그
serve_vllm.sh는 모델 경로와 포트, GPU 메모리 할당 비율, eager 실행 여부를 한곳에서 관리합니다. app.py는 vLLM 서버의 /v1/chat/completions를 호출해 입력을 전달하고 응답을 Gradio 화면에 표시합니다. UI 코드는 모델을 직접 로드하지 않고, 별도로 실행 중인 vLLM API를 사용합니다.
설치와 실행 순서
먼저 의존 패키지의 호환성을 맞춘 뒤 vLLM 서버와 UI를 각각 실행합니다.
# 호환성 문제가 확인된 버전을 고정
uv pip install transformers==4.52.4 fastapi==0.115.12

# FlashInfer 설치 후 serve_vllm.sh에서 vLLM 서버 실행
./serve_vllm.sh

# 별도 터미널에서 Gradio UI 실행
python app.py
serve_vllm.sh의 핵심 vLLM 옵션은 다음과 같습니다.
vllm serve <A.X-4.0-Light-model-path> \
  --gpu-memory-utilization 0.95 \
  --enforce-eager
모델 경로와 포트는 실행 환경에 맞게 지정하며, 위 명령의 옵션 표기는 재현 가능한 형태로 정리한 것입니다. 실행 과정에서 transformers와 fastapi 버전 호환성, FlashInfer 설치 여부, CUDA 그래프 초기화 여부를 순서대로 확인했습니다.
호환성 문제와 해결 과정
transformers버전이 맞지 않으면 모델 설정이나 토크나이저 로딩 단계에서 오류가 발생할 수 있어4.52.4로 맞췄습니다.- FastAPI 의존성 충돌은 버전을
fastapi==0.115.12로 고정해 해결했습니다. - GPU 메모리 할당 비율을
0.95까지 허용하고--enforce-eager를 사용해 CUDA Graph 캡처와 관련된 초기화 문제를 피했습니다. 이는 이번 성공 사례의 설정이며, 모든 GPU와 모델의 최적값이라는 뜻은 아닙니다. - FlashInfer를 설치한 뒤 vLLM이 해당 커널을 선택할 수 있는 상태를 확인했습니다. 실제 성능 향상 폭을 확인하려면 별도 벤치마크가 필요합니다.
실행 검증
다음 순서로 모델 서버, API, UI, GPU 상태를 확인했고 모두 성공했습니다.
GET  /v1/models                 -> 200, 모델 목록 확인
POST /v1/chat/completions       -> 200, assistant 응답 확인
http://<host>:7860              -> Gradio UI 접속 확인
nvidia-smi                      -> GPU 프로세스와 메모리 사용량 확인
<host>, 포트에 연결된 외부 IP와 PID는 Pod를 다시 만들거나 프로세스를 재기동하면 달라지는 일회성 값입니다. 따라서 재현 명령의 고정값으로 기록하지 않습니다. /v1/models가 응답하는지 먼저 확인한 뒤 chat completions를 호출하고, 마지막으로 Gradio가 같은 API를 사용하는지 확인하는 순서가 안전합니다.
운영과 보안 주의
- Jupyter 비밀번호, RunPod API 키와 모델 저장소 토큰은 셸 스크립트나 로그, Git 저장소에 기록하지 않습니다.
0.0.0.0으로 서버를 열 때는 RunPod 포트 공개 범위와 인증 프록시를 함께 확인합니다. 외부에 인증 없는 OpenAI 호환 API를 직접 노출하지 않습니다.- Gradio를
0.0.0.0:7860으로 열고 인증 없이 외부에 노출하면 LAN이나 공인 네트워크에서 누구나 UI에 접근할 수 있습니다. 방화벽, 인증 또는 리버스 프록시를 함께 구성합니다. - 모델 캐시와 로그는 영속 볼륨에 두고, 컨테이너 디스크와 GPU 메모리 사용량을 따로 관찰합니다.
gpu-memory-utilization=0.95는 메모리 부족 위험을 높일 수 있으므로 실제 동시 요청과 컨텍스트 길이에 맞춰 낮출 수 있어야 합니다.- 모델 로딩, 간단한 API 요청 처리, 벤치마크 실행은 각각 따로 확인해야 하는 검증 단계입니다.
RunPod A40에서 EXAONE 실습
이번 후속 실습에서는 RunPod NVIDIA A40 48GB 환경에서 공식 LGAI-EXAONE/EXAONE-4.0-32B-AWQ 스냅샷을 다운로드했습니다. 스냅샷 hash는 1ce84bc0d0ea5a18e49b163584214cf5b74f34d2이고, HF 캐시는 약 17G, 17개 파일로 구성됐습니다.
로컬 스냅샷을 사용해 vLLM 0.28.0 환경에서 서버를 기동하는 데 성공했습니다. 초기 검증은 컨텍스트 길이를 4096으로 제한했으며, 모델카드에 기재된 131,072 토큰 전체 컨텍스트 성능을 확인한 결과는 아닙니다.
vllm serve <EXAONE-4.0-32B-AWQ local snapshot> \
  --served-model-name LGAI-EXAONE/EXAONE-4.0-32B-AWQ \
  --quantization awq \
  --host 127.0.0.1 \
  --port 8000 \
  --dtype auto \
  --max-model-len 4096 \
  --gpu-memory-utilization 0.90
서버의 /health는 HTTP 200을 반환했고, 상태 확인 시 GPU 사용량은 41,601 / 46,068 MiB였습니다. 프로세스 경과시간은 17분 15초로 관측됐지만, 이는 순수 모델 로딩 시간만을 뜻하지 않고 프로세스 전체 경과시간입니다. PID는 재기동 때 바뀌는 일회성 값이므로 기록하지 않습니다.
EXAONE Chat Completions 검증
서버가 실제 한국어 요청을 처리하는지 확인하기 위해 reasoning을 끈 상태로 Chat Completions를 호출했습니다.
curl -X POST http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "LGAI-EXAONE/EXAONE-4.0-32B-AWQ",
    "messages": [{"role": "user", "content": "대한민국의 사계절을 설명해줘."}],
    "max_tokens": 96,
    "temperature": 0,
    "chat_template_kwargs": {"enable_thinking": false}
  }'
HTTP 200 응답을 받았고, 약 3.04초 동안 입력 46토큰과 출력 96토큰, 총 142토큰을 처리했습니다. 자연스러운 한국어 네 문장이 반환됐으며 <think> 블록은 노출되지 않았습니다.
EXAONE 메모리 구성
재기동 로그에서 인식된 총 GPU 메모리는 44.42 GiB, 목표 메모리 할당 비율 0.90에 해당하는 용량은 39.98 GiB였습니다. 가중치와 non-Torch 메모리는 17.31 GiB, 최대 활성화 메모리는 0.37 GiB, CUDA Graph는 1.01 GiB, KV 캐시는 22.3 GiB로 기록됐습니다. 항목을 단순 합산하면 약 40.99 GiB로 목표 용량보다 큽니다. 총 메모리에서 이 합계를 뺀 값은 약 3.43 GiB이지만, 각 수치의 측정 시점과 중복 집계 여부를 확인하기 전에는 이를 현재 여유 메모리의 실측값으로 해석하지 않습니다.
--kv-cache-memory-bytes=22703113114(21.14 GiB)는 KV 캐시 크기를 직접 지정하는 후보값입니다. 이 옵션을 지정하면 KV 캐시 크기를 gpu-memory-utilization으로 자동 산정하는 방식은 사용하지 않습니다. 27189570048(25.32 GiB)를 지정하는 후보는 메모리 여유가 더 작아집니다. 두 값 모두 실제 부하에서 검증한 설정은 아니므로, 동시 요청 수와 컨텍스트 길이를 늘릴 때는 활성화 텐서와 CUDA Graph에 필요한 공간까지 함께 확인해야 합니다. vLLM v0.28.0 옵션 문서
Gradio 실행 환경과 UI 검증
vLLM 환경의 FastAPI·Transformers 의존성과 충돌하지 않도록 Gradio UI는 별도 가상환경에서 구성했습니다.
uv venv /workspace/llmso/gradio-venv
uv pip install --python /workspace/llmso/gradio-venv/bin/python gradio openai
설치 결과는 gradio==6.26.0, openai==3.8.0입니다. /workspace FUSE 네트워크 스토리지에서 작은 파일의 메타데이터 작업이 많아 설치에 약 6분이 걸렸습니다.
첫 실행에서는 Gradio 6.26.0에서 ChatInterface(type="messages") 인자가 제거되어 TypeError가 발생했습니다. type 인자를 제거하고 Gradio 6의 구조화된 대화 기록에서 메시지 본문을 문자열로 변환하는 extract_text()를 app.py에 추가한 뒤, UI 로그인과 EXAONE 한국어 스트리밍 응답을 확인했습니다.
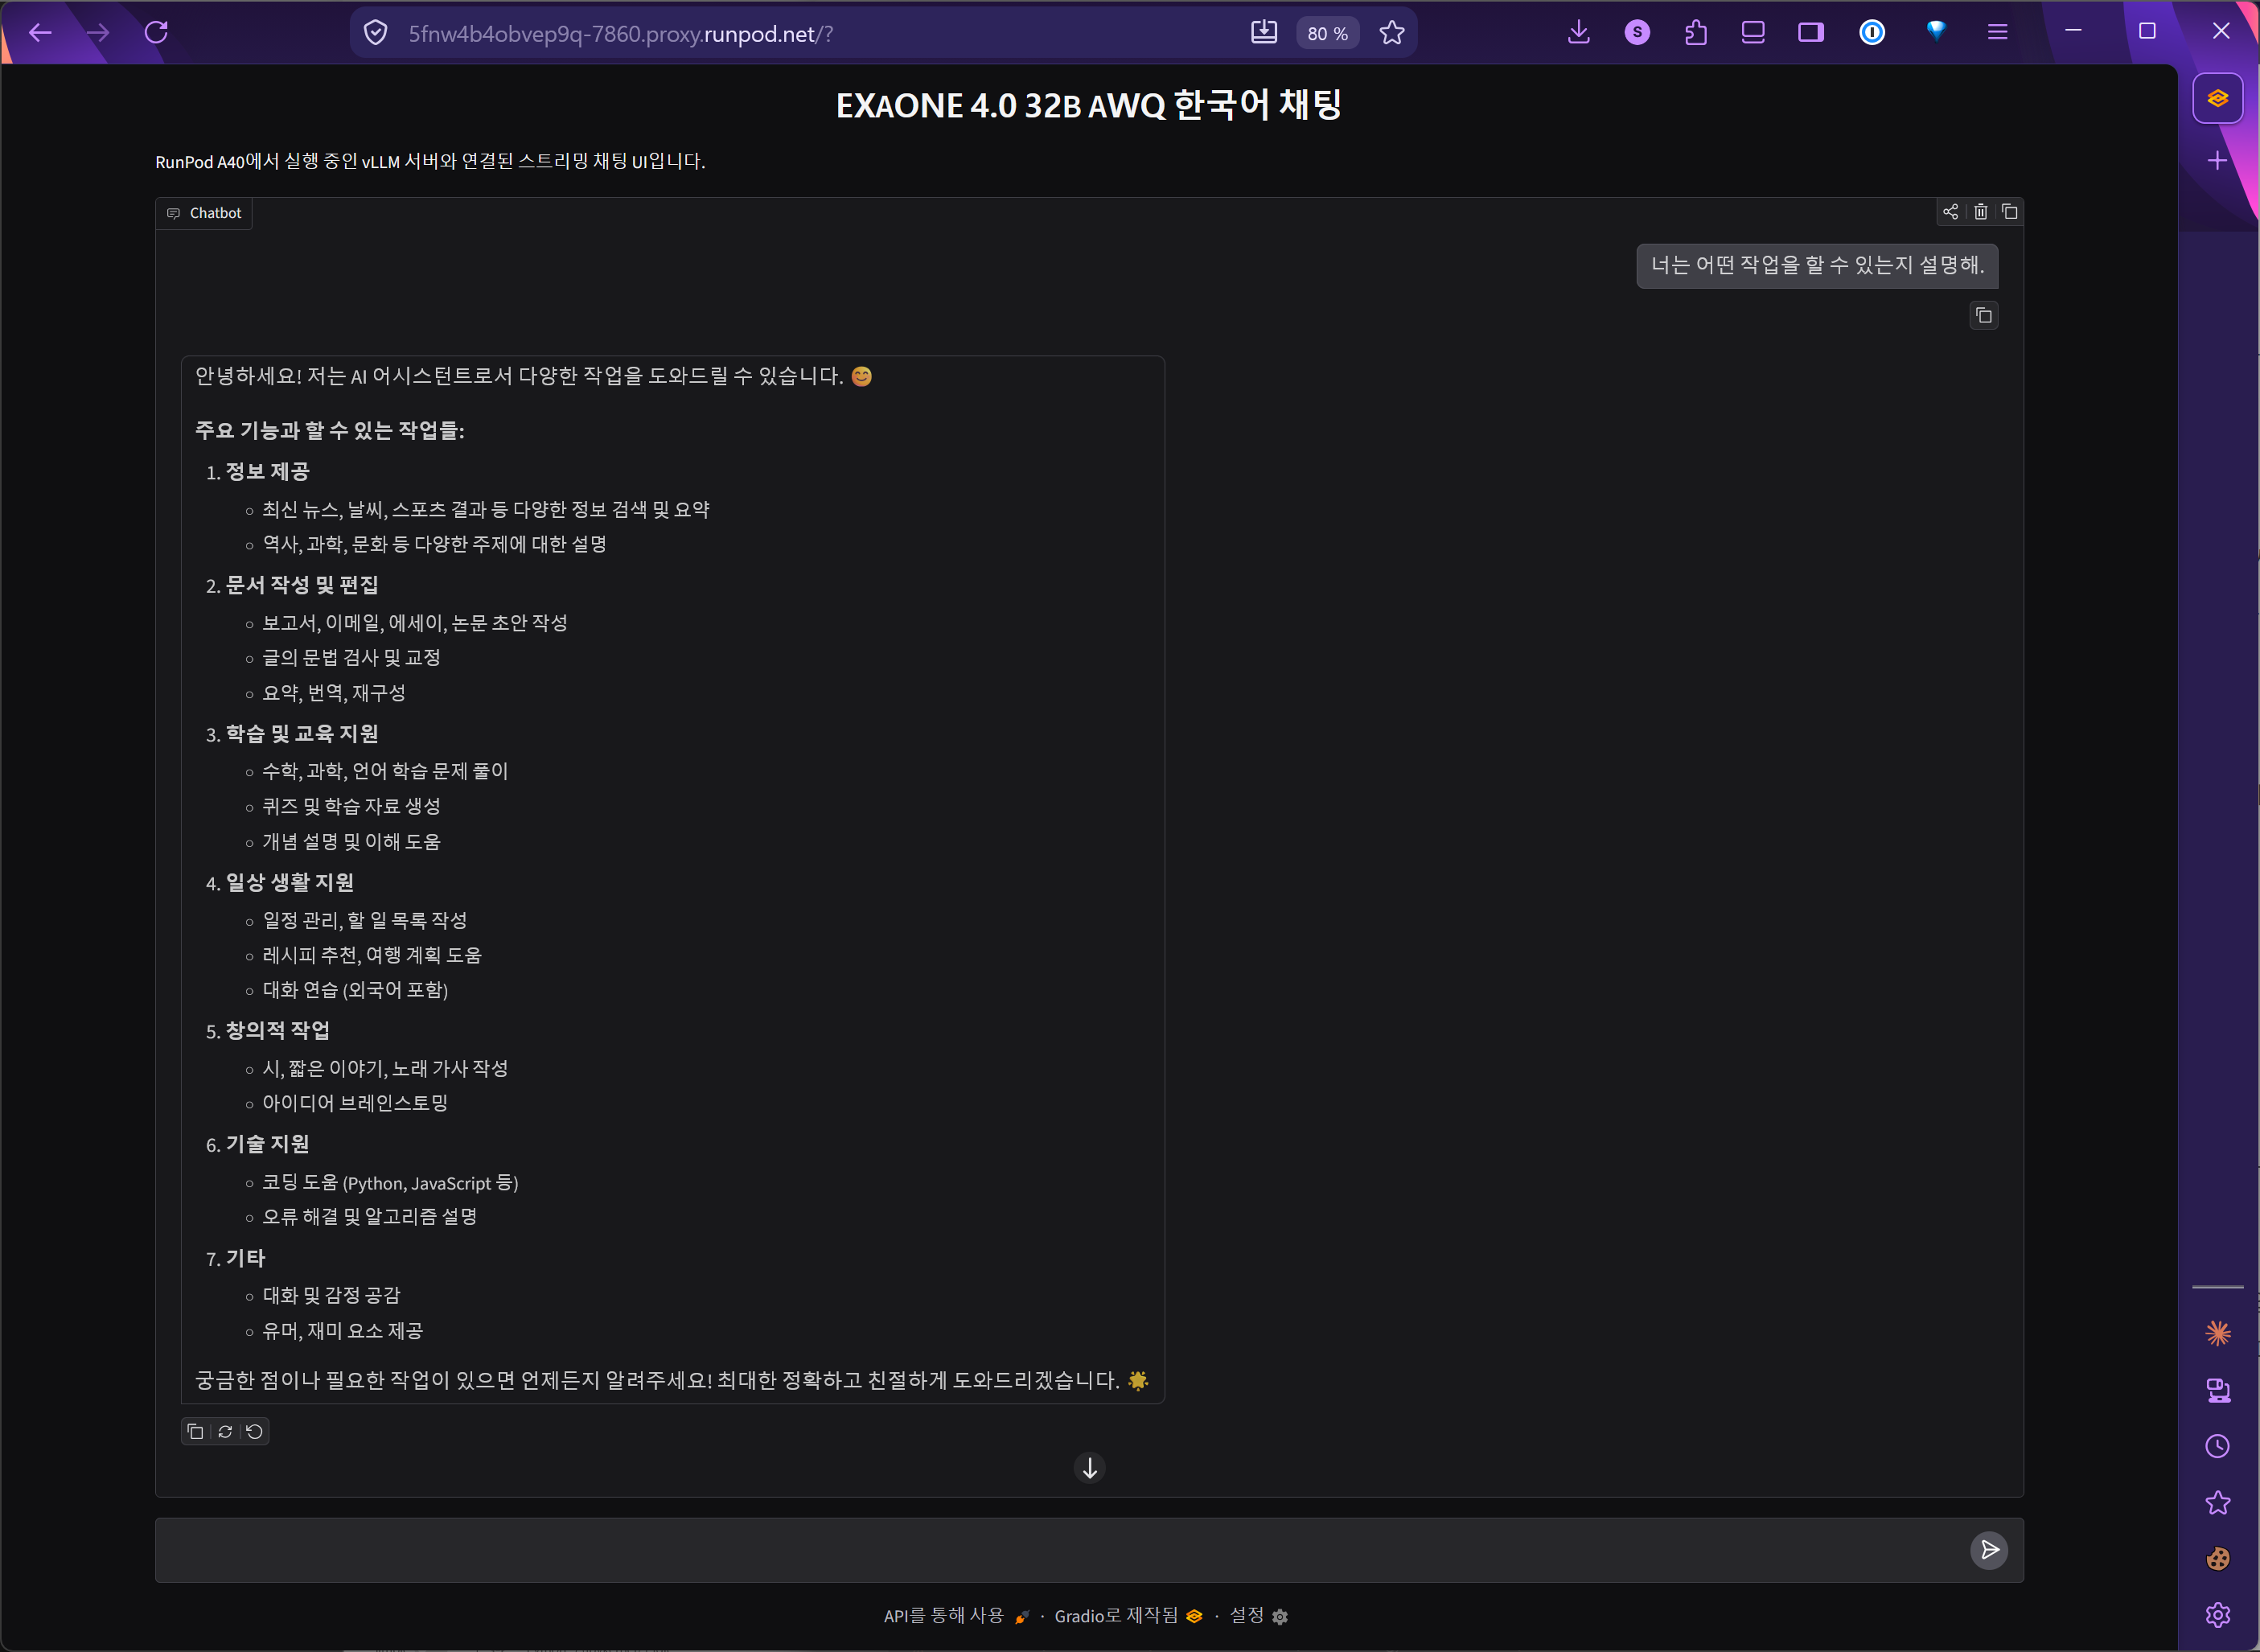
RunPod Pod에 7860/http 포트를 추가하는 과정에서 컨테이너가 재생성되어 vLLM과 Gradio를 다시 기동했습니다. /workspace 200GB 영속 저장공간의 모델·가상환경·스크립트는 유지되어 모델을 다시 다운로드하지 않았습니다. Gradio를 0.0.0.0:7860에서 실행하고 RunPod HTTP 프록시를 통해 접속했습니다.
단일 스트리밍 호출 측정
UI에서 실제로 사용하는 경로를 확인하기 위해 별도 측정 스크립트로 한국어 스트리밍 호출을 1회 실행했습니다.
HTTP status: 200
prompt tokens: 56
completion tokens: 77
total tokens: 133
TTFT: 12018.15 ms
total latency: 14381.68 ms
end-to-end output throughput: 5.35 tok/s
decode throughput after first token: 32.67 tok/s
approximate TPOT: 30.61 ms
응답은 성능 검증, 보안·개인정보, 확장성·비용 관리의 세 항목을 설명하는 정상적인 한국어 답변이었습니다. 서버 재기동 직후의 첫 요청에서 TTFT는 약 12.02초로 관측됐습니다. 이 한 건으로 초기화와 워밍업을 마친 상태의 평균 성능이나 최대 처리량을 판단할 수는 없습니다.
위 전체 지연시간에서 TTFT를 빼면 2,363.53 ms입니다. 첫 토큰을 제외한 76토큰에 이 구간을 적용하면 약 32.16 tok/s, 31.10 ms/token으로, 기록된 32.67 tok/s, 30.61 ms와 다릅니다. 원시 결과는 보존했으며, 측정 스크립트에서 마지막 콘텐츠 수신과 스트림 종료 중 어느 시점을 사용했는지 확인해야 합니다.
서버 로그의 Avg prompt throughput 5.6, Avg generation throughput 7.7, 프리픽스 hit 10.5%는 로그 시간창에서 계산된 엔진 평균입니다. 단일 요청의 직접 측정값과 섞지 않고 보조 관측으로만 봅니다. 당시 Running=0, Waiting=0, KV usage=0%였던 것도 요청이 끝난 뒤의 유휴 상태를 나타냅니다.
- 측정 스크립트:
/workspace/llmso/scripts/measure_exaone_single_call.py - 결과 파일:
/workspace/llmso/logs/exaone-single-call-metrics.json - 서버 로그:
/workspace/llmso/logs/vllm-exaone-4.0-32b-awq.log - 스크립트 전체는 본문에 중복하지 않고, 위 파일에서 요청·타이밍 측정 방법을 확인합니다.
마무리
단일 RunPod A40에서 EXAONE-4.0-32B-AWQ를 로드하고, OpenAI 호환 API와 Gradio 인증 UI를 거쳐 한국어 스트리밍 응답을 받는 전체 경로를 확인했습니다. 첫 호출의 TTFT가 길었으므로 워밍업 이후 반복 측정은 후속 과제로 남겼습니다.
실습 결과와 회고
단일 A40에서 AWQ는 BF16보다 모델 로딩 메모리를 줄였고, ShareGPT와 Prefix Repetition 모두에서 처리량과 평균 ITL을 개선했습니다. 다만 TTFT는 ShareGPT에서 줄고 Prefix Repetition에서 늘었습니다. 양자화의 효과를 판단할 때는 처리량뿐 아니라 워크로드별 지연시간도 함께 봐야 한다는 점을 확인했습니다.
AWQ의 배칭·메모리 설정 네 가지를 비교한 소규모 실험에서는 기본 설정을 바꿀 만큼 뚜렷한 처리량 개선을 확인하지 못했습니다. 한국어 모델 실습은 서버와 API·UI 연결, 한국어 응답 확인까지 진행했으며, 반복 부하 측정과 응답 품질 평가는 후속 과제로 남았습니다.
이번 실습이 오래 걸린 이유
이번 실습은 모델을 한 번 실행하는 작업보다 환경과 실험 조건을 검증하는 데 시간이 더 많이 필요했습니다. 주요 원인은 다음과 같습니다.
- 초기 50GB 저장공간으로는 Qwen3-14B 원본 가중치 약 28GB에 Hugging Face 임시·부분 다운로드, 캐시 중복과 컴파일 캐시까지 함께 저장하기 어려웠습니다. 디스크 쿼터 문제가 반복된 뒤 200GB로 확장하고 캐시를 정리해 해결했습니다.
/workspace가 FUSE 기반 스토리지라 대형 분할 가중치 파일 로딩과 서버 재기동이 느렸습니다. BF16 서버는 프로세스 경과시간 약 14분인 시점에 정상 동작을 확인했으며, 정확한 준비 완료 시점은 따로 계측하지 않았습니다.- 최초 실행에서
ninja같은 런타임 의존성을 뒤늦게 설치해 서버를 다시 기동해야 했습니다. - BF16과 AWQ에 ShareGPT 2,000건 및 Prefix Repetition 1,000건을 각각 같은 조건으로 실행했습니다. 특히 BF16 ShareGPT 테스트에 약 39분이 걸렸고, 설정 후보도 한 GPU에서 하나씩 확인해야 해서 전체 시간이 길어졌습니다.
- 자연 대화 트래픽과 프리픽스 합성 트래픽의 목적을 초기에 분리하지 못해 프리픽스-only 예비 결과를 본 실험에 재사용할 수 없었습니다. 이후 올바른 ShareGPT 데이터셋, served model과 endpoint 조건으로 다시 측정했습니다.
- EXAONE 32B AWQ 다운로드와 모델 로딩, Gradio v6 API 호환성 수정, 최초 단일 호출의 cold-start 비용도 추가로 발생했습니다.
다음 실습에서는 저장공간과 캐시 용량을 먼저 산정하고, 의존성과 작은 표본을 검증한 뒤 본 벤치마크를 실행하려고 합니다. 실행 명령과 결과 파일명도 미리 정해 측정 조건을 일관되게 남길 계획입니다. 여러 Pod로 실험을 나눌 때는 GPU와 소프트웨어 환경을 맞추고 비용도 함께 확인해야 합니다.
이번 실습에서는 환경 준비와 측정 조건을 정리하는 데도 많은 시간이 들었습니다. 그 조건과 결과를 함께 남겨야 다음 실험에서 무엇을 바꿀지 판단할 수 있었습니다.