[CloudNeta] Hands-On LLM Serving 3주차 part 2 - 필수 LLM 최적화 기법
이 글은 3주차 연재의 두 번째 편입니다.
- part 1 - LLM 서빙의 최적화 (이 글)
- part 2 - 필수 LLM 최적화 기법
그림 1, 2, 6, 8, 10, 11, 14, 21, 24, 25, 26은 beengineer500의 배칭과 어텐션 글에 수록된 도식을 사용하거나 그 내용을 바탕으로 재구성했습니다.
그림 4, 7, 12, 13은 실시간 서빙에서 배칭이 필요한 이유와 연속 배칭·청크 프리필을 설명한 영상의 화면을 캡처했습니다.
그림 15부터 18까지는 GQA와 MQA의 KV 캐시 절감 효과를 설명한 영상의 화면을 캡처했습니다.
그림 19와 20의 GPU 실행 계층은 NVIDIA CUDA Programming Guide가 설명하는 thread, warp, block, grid와 SM의 관계를 바탕으로 작성했습니다.
그림 28과 29는 Maarten Grootendorst의 양자화 시각 가이드에 수록된 도식을 사용했습니다.
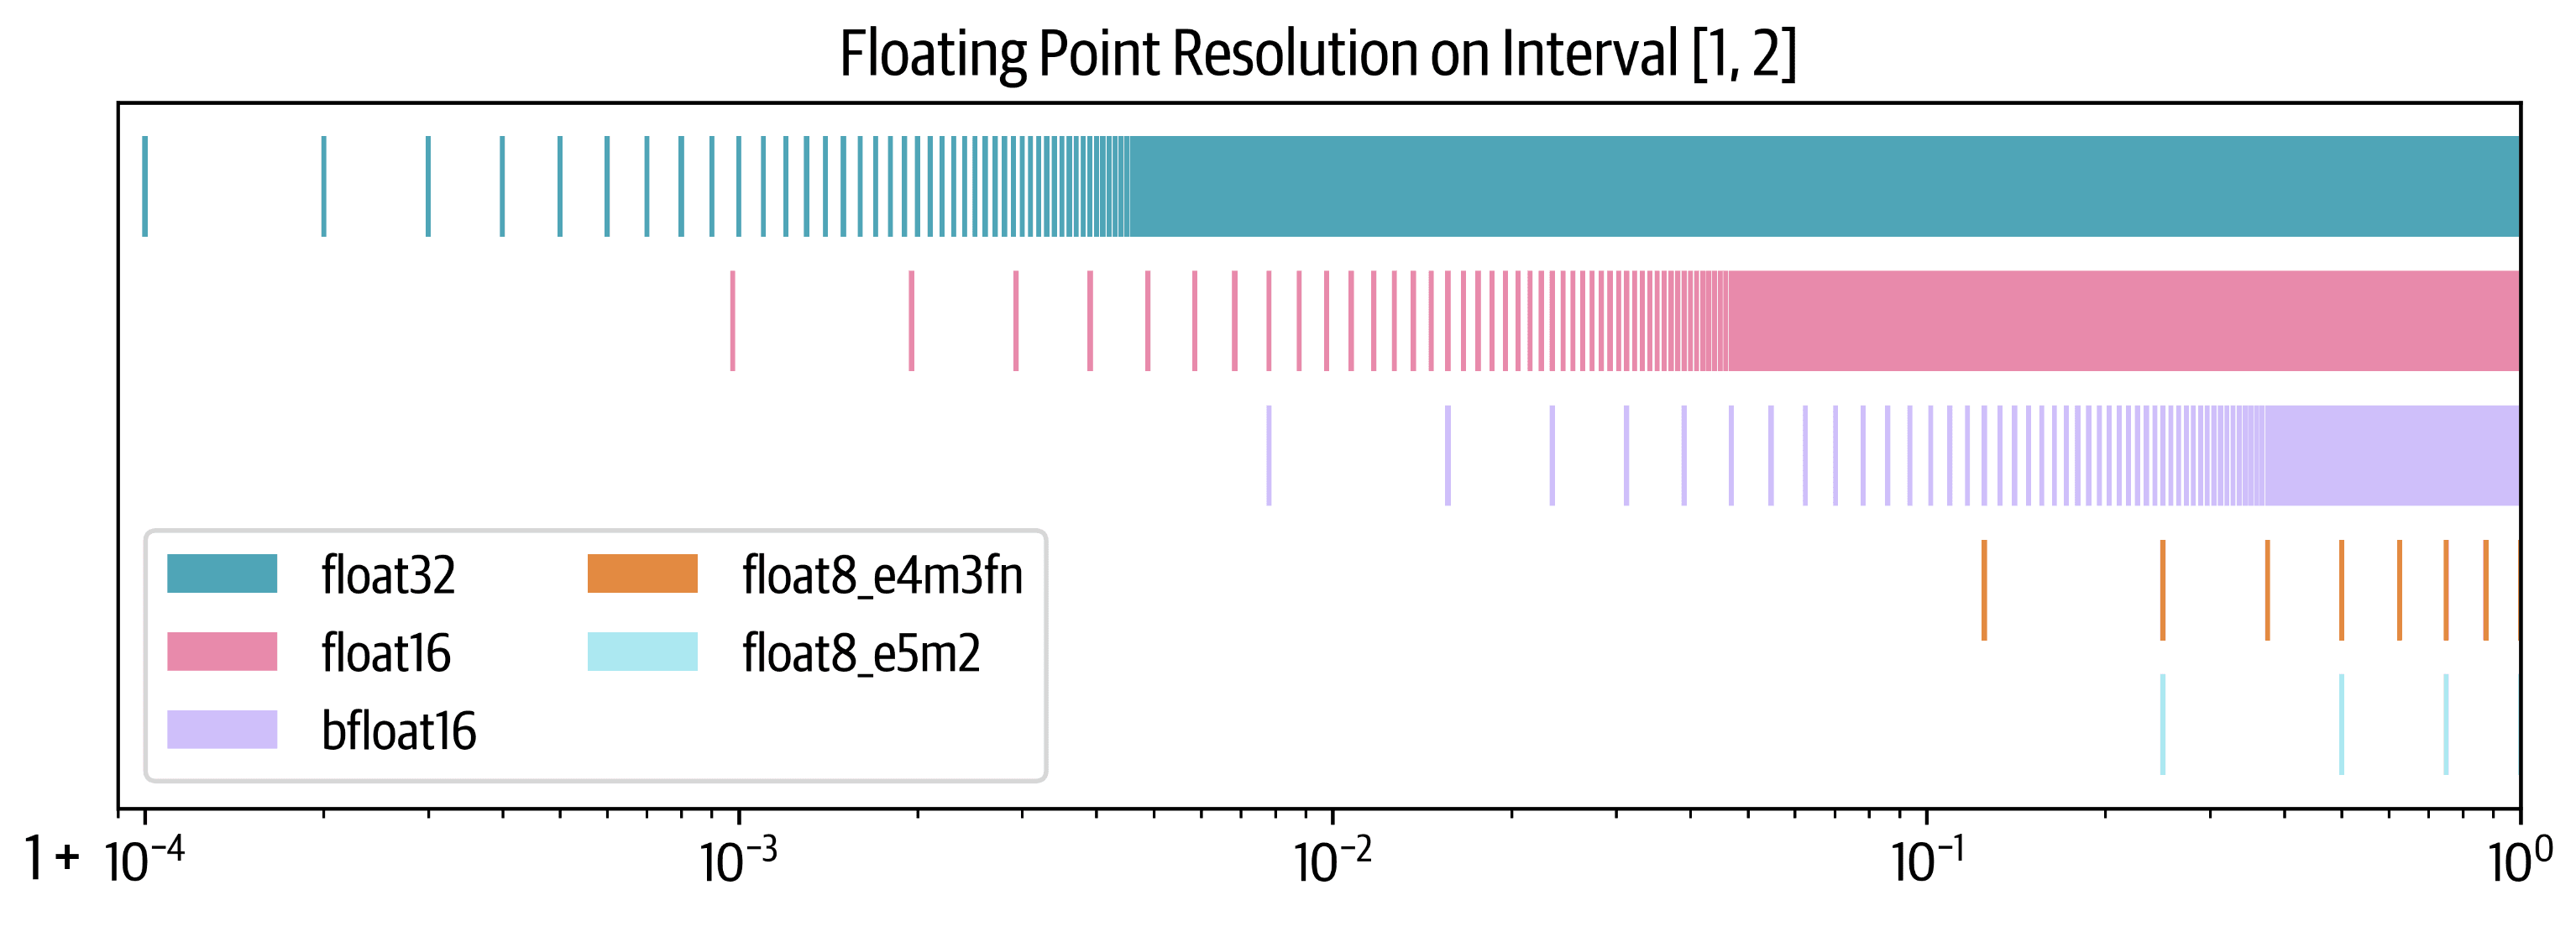
그림 30과 31은 Hugging Face Ultra-Scale Playbook의 부동소수점 범위와 해상도 자료를 사용했습니다. 그림 32는 INT8과 FP8의 값 분포 차이를 같은 기준으로 시각화한 자료입니다.
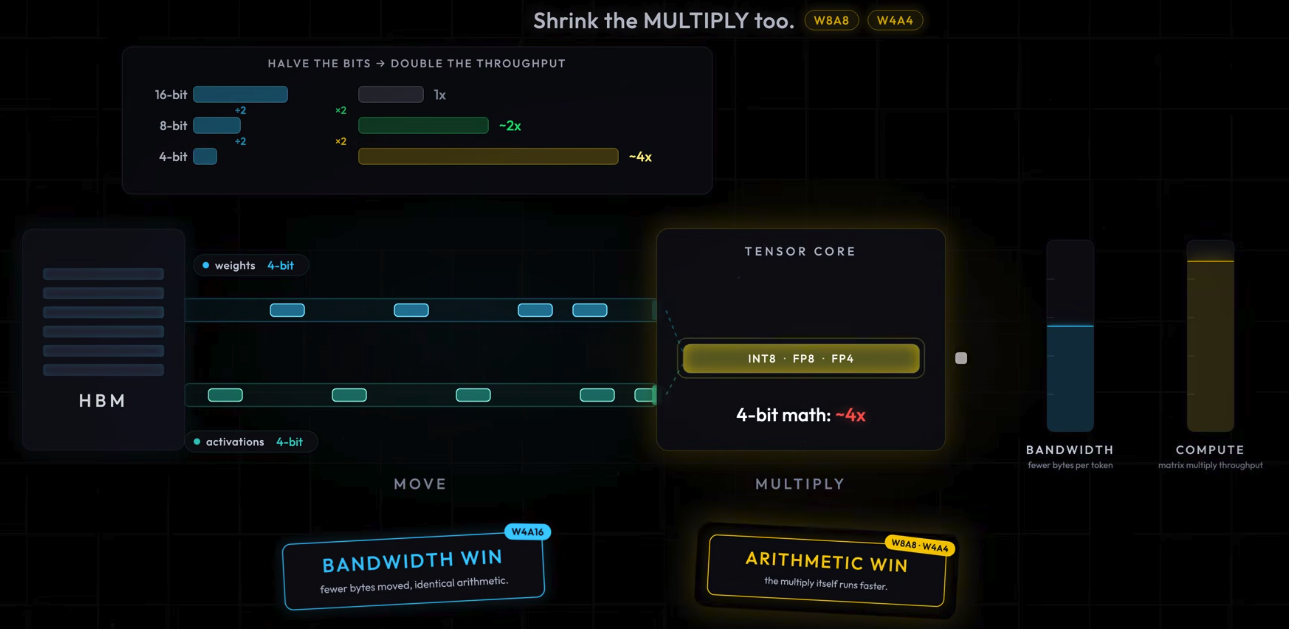
그림 33은 가중치와 활성화 양자화의 효과를 설명한 영상, 그림 34는 같은 영상의 KV 캐시 압축 설명 화면을 캡처했습니다.
그림 35는 GGUF 파일 형식 사양이 설명하는 헤더, 메타데이터와 텐서 데이터의 구성을 나타냅니다.
그림 36은 Neural Magic 연구진의 LLM 양자화 정확도·성능 연구에 수록된 Llama 3.1 계열 평가 결과입니다.
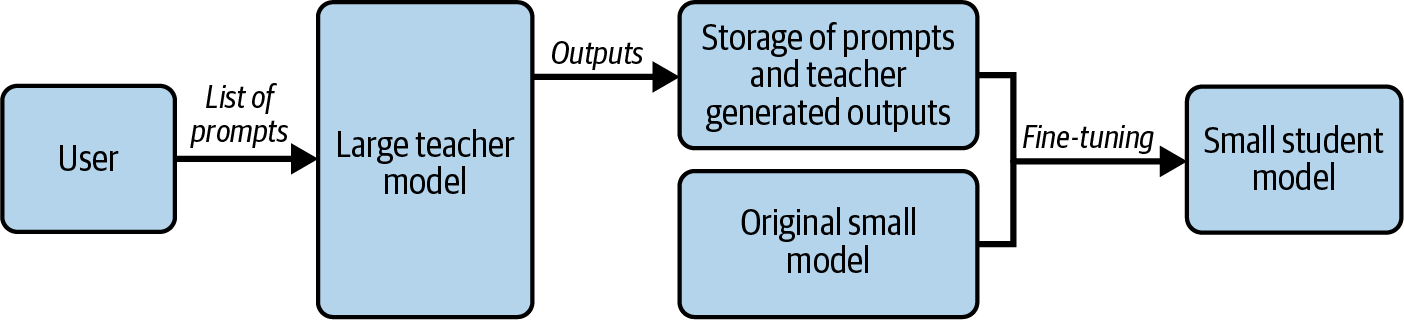
그림 37, 38, 40은 Build a DeepSeek Model (From Scratch)의 증류 설명과 DeepSeek-R1 연구를 바탕으로 구성했습니다. 그림 39는 교사가 생성한 응답으로 학생 모델을 파인튜닝하는 출력 증류 과정을 나타냅니다.
그림 41은 NVIDIA의 2:4 구조적 희소성 설명에 수록된 도식입니다.
그림 43은 SGLang의 RadixAttention 문서를 바탕으로 구성했습니다. 그림 44는 프리픽스 캐싱의 멀티턴 대화 사례를 재구성한 도식이며, 그림 45는 vLLM Production Stack의 프리픽스 인지 라우팅 문서를 바탕으로 구성했습니다.
그림 42는 일반 캐싱과 프리픽스 캐싱의 동작 차이를 설명하기 위해 새로 구성한 도식입니다.
들어가며
6장에서는 필수 LLM 최적화 기법에 대해 살펴보고, 각 기법이 어떤 의미를 가지는지 살펴봅니다. 또한 KodeKloud의 vLLM을 이용한 LLM 추론 구동을 통해 어떤 식으로 문제를 해결하는지 직접 쫓아가봅니다.
필수 LLM 최적화 기법
필수 LLM 최적화 기법은 아래와 같습니다:
- Batching and scheduling: GPU idle time을 줄이고 throughput을 높인다.
- Attention and kernel optimization: attention 계산과 memory movement를 줄인다. (KV Cache와 HBM↔SRAM 데이터 이동을 줄임)
- Model compression: 모델 자체를 작고 빠르게 만든다. quantization, distillation, pruning으로 memory footprint와 연산 비용을 줄인다.
- Prefix caching: 이전 Prompt 계산 결과를 재사용한다. 반복 prefix를 재사용해 prefill 비용을 줄인다.
각 최적화 기법이 어떤 병목을 완화하는지 연결하면 다음과 같습니다.
Batching과 스케줄링 레벨의 최적화
LLM 온라인 서빙의 목표는 지연시간 SLA를 지키면서 GPU 활용률과 처리량을 높이는 것입니다. 이를 위해 서로 다른 계층의 최적화 기법을 함께 적용합니다.
- 배칭과 스케줄링
- 동적 배칭: 최대 배치 크기와 대기시간을 기준으로 요청을 묶습니다.
- 연속 배칭: iteration마다 완료된 요청을 제거하고 새로운 요청을 추가합니다.
- 청크 프리필: 긴 Prefill을 나누어 Decode 요청과 함께 스케줄링합니다.
- 연산 최적화
- 스케일링 어텐션: 긴 컨텍스트에서 어텐션의 연산량과 메모리 사용량을 줄입니다.
- 커널 최적화: 동일한 연산을 GPU에서 더 효율적으로 실행합니다.
- 모델 최적화
- 모델 압축: 양자화와 증류를 통해 메모리 사용량과 연산 비용을 줄입니다.
온라인 서빙에서 배칭은 처리량을 높이는 핵심 수단이지만 모든 환경에 필수적인 것은 아닙니다. 트래픽이 적거나 지연시간을 우선하는 서비스에서는 작은 배치를 사용하거나 요청을 개별적으로 처리할 수도 있습니다.
오프라인 서빙과 실시간 온라인 서빙
2장에서는 LLM 서빙을 오프라인 서빙과 실시간 온라인 서빙으로 구분했습니다.
- 오프라인 서빙(offline serving): 처리할 요청이 미리 준비되어 있습니다. 여러 요청을 하나의 큰 텐서로 묶어 모델에 한꺼번에 전달하기 쉽습니다.
- 실시간 온라인 서빙(real-time online serving): 사용자가 요청을 보낼 때마다 서로 다른 시점에 요청이 도착합니다. 배치를 만들기 위해 요청을 오래 기다리면 응답 지연시간이 늘어납니다.
여러 요청을 배치로 묶으면 GPU가 한 번에 수행할 작업이 늘어나 전체 처리량을 높일 수 있습니다. 다만 배치를 구성하는 대기시간과 한 번의 연산량도 증가하므로 개별 요청의 지연시간은 길어질 수 있습니다. 실시간 서빙에서는 처리량과 지연시간 사이의 균형이 중요합니다.
실시간 서빙에 배칭이 필요한 이유
LLM 추론은 Prefill과 Decode에서 서로 다른 형태의 행렬곱을 수행합니다.
- Prefill: 입력 프롬프트의 여러 토큰을 함께 처리하고 KV 캐시를 만듭니다. 프롬프트가 충분히 길면 가중치를 여러 토큰의 연산에 재사용하므로 산술 강도가 높아지는 경향이 있습니다.
- Decode: 활성 요청마다 새 토큰 하나씩 생성합니다. 작은 배치에서는 가중치와 KV 캐시를 읽는 양에 비해 수행하는 연산이 적어 메모리 대역폭의 영향을 크게 받습니다.
배치 크기가 3이라면 한 번의 Decode 반복에서 각 요청의 새 토큰을 하나씩, 모두 세 개 생성할 수 있습니다. 요청별 생성 과정은 여전히 자기회귀적으로 진행되지만, 같은 반복에 포함된 요청은 GPU에서 함께 계산됩니다.

전체 추론 파이프라인에서 Tokenization은 Transformer에 입력할 토큰 ID를 만드는 전처리입니다. Prefill과 Decode는 동일한 Transformer 전체를 실행하는 두 단계이며 별도의 레이어로 구성되지 않습니다.
Prefill은 프롬프트 전체의 KV 캐시를 만들고 첫 출력 토큰을 준비하며, Decode는 기존 KV 캐시를 읽고 새 K/V를 추가하면서 이후 토큰을 하나씩 생성합니다.

배칭과 산술 강도
5장에서 살펴본 선형 레이어의 행렬곱에서는
배치 크기가 커지면 하나의 행렬 연산에서 같은 모델 가중치를 여러 요청의 토큰 계산에 재사용할 수 있습니다. GPU 메모리에서 가져온 데이터당 수행하는 연산이 늘어나므로 산술 강도와 GPU 연산 장치 활용률도 높아집니다.
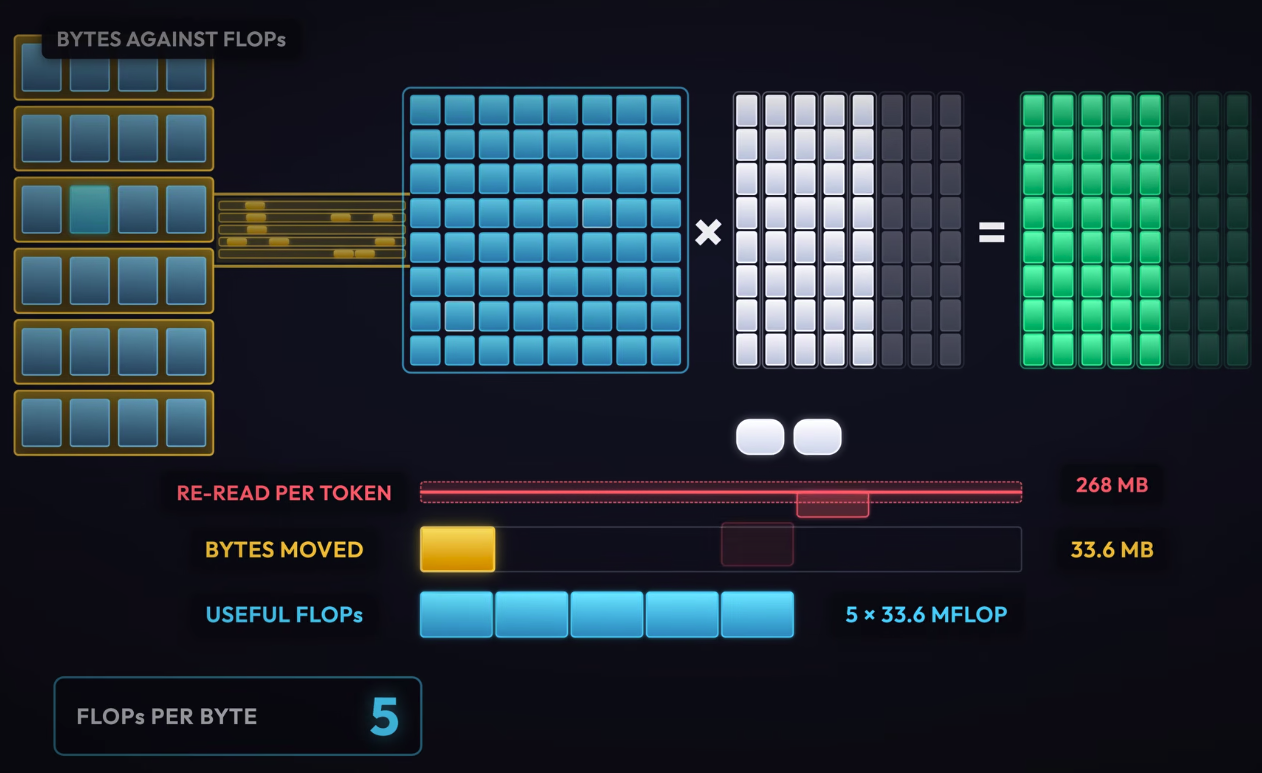
그림 4의 수치는 배칭과 산술 강도의 관계를 설명하기 위한 예시입니다. 실제 데이터 이동량과 달성 가능한 성능은 모델 구조와 정밀도, 배치 크기, 커널 구현과 하드웨어에 따라 달라집니다. 관련 과정은 배칭과 산술 강도 설명 영상에서도 확인할 수 있습니다.
Prefill과 Decode에서의 효과
- Prefill: 긴 프롬프트는 그 자체로 큰 행렬을 만들기 때문에 GPU 연산 자원을 이미 충분히 사용할 수 있습니다. 짧은 프롬프트에서는 배칭이 도움이 되지만, 프롬프트가 길어질수록 추가 배칭의 이점은 상대적으로 작아질 수 있습니다.
- Decode: 작은 배치에서는 산술 강도가 낮아 메모리 대역폭의 영향을 크게 받습니다. 여러 요청을 함께 처리하면 한 번 가져온 가중치를 더 많은 토큰 생성에 활용할 수 있어 전체 처리량이 증가합니다.
배칭의 핵심은 모델 가중치를 읽는 비용을 여러 요청의 연산에 분산하는 것입니다. 특히 Decode 처리량을 높이는 데 효과적이지만, 배치 대기시간과 KV 캐시 사용량도 함께 증가합니다. 이후에는 이 트레이드오프를 다루는 동적 배칭과 스케줄링 기법을 살펴봅니다.
온라인 추론에서의 동적 배칭
온라인 서비스에서는 요청의 도착 시점을 미리 알 수 없습니다. 최대 배치 크기가 찰 때까지 계속 기다리면 먼저 도착한 요청의 대기시간이 길어집니다. 이 방식은 요청을 미리 확보할 수 있는 오프라인 서빙에는 적합하지만 지연시간이 중요한 온라인 서빙에는 사용하기 어렵습니다.
동적 배칭(dynamic batching)은 다음 두 조건 중 하나를 만족하면 현재까지 모인 요청을 모델에 전달합니다.
- 대기 중인 요청 수가
max_batch_size또는 선호 배치 크기에 도달한 경우 - 가장 오래 기다린 요청이
max_delay_time에 도달한 경우
flowchart TD
    requestQueue["Request Queue"] --> maxBatch{"Max Batch Size 도달?"}
    maxBatch -->|예| gpuInference["GPU Inference"]
    maxBatch -->|아니요| maxDelay{"Max Delay 도달?"}
    maxDelay -->|예| gpuInference
    maxDelay -->|아니요| waitMore["조금 더 기다림"]
    waitMore --> maxBatch
최대 배치 크기나 최대 대기시간에 도달하면 현재까지 모인 요청을 GPU로 전달합니다.
10인승 운송 수단에 비유하면 승객 10명이 모였을 때 바로 출발하고, 10명이 모이지 않아도 정해진 대기시간이 지나면 현재 인원으로 출발하는 방식입니다. 요청이 하나뿐이어도 최대 대기시간을 넘기지 않으므로 지연시간의 상한을 관리할 수 있습니다.
NVIDIA Triton도 최대 배치 크기와 max_queue_delay_microseconds를 이용해 같은 방식으로 동적 배치를 구성합니다. 자세한 동작은 Triton Dynamic Batcher 문서에서 확인할 수 있습니다.
| 설정 | 값을 높일 때 | 값을 낮출 때 |
|---|---|---|
| 최대 배치 크기 | 처리량이 높아질 수 있지만 한 번의 처리시간과 메모리 사용량이 증가합니다. 너무 크면 OOM 위험이 커집니다. | 요청당 지연시간은 줄어들 수 있지만 GPU 병렬성을 충분히 사용하지 못할 수 있습니다. |
| 최대 대기시간 | 더 큰 배치를 만들기 쉬워지지만 대기열 지연시간이 증가합니다. | 요청을 빨리 처리하지만 실제 배치 크기가 작아져 배칭 효과가 줄어듭니다. |
튜닝 목표는 지연시간 SLA를 지키면서 실제 배치 크기를 가능한 한 크게 유지하는 것입니다. 평균 배치 크기와 대기열 지연시간, GPU 메모리 사용량을 함께 측정해야 합니다.
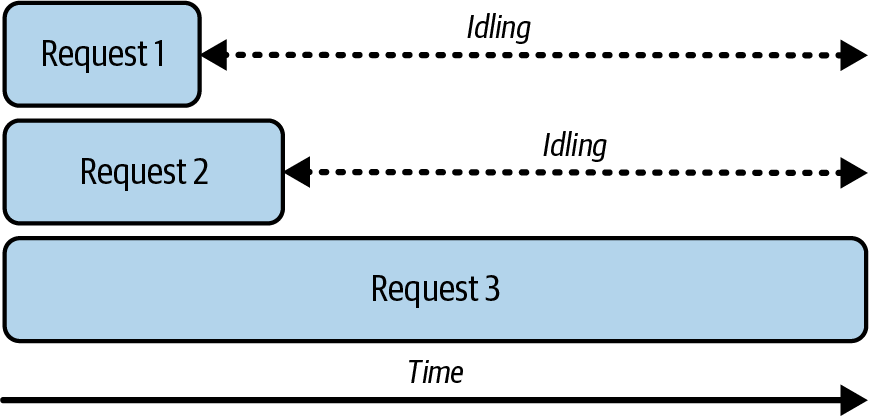
전통적인 동적 배칭은 한 번 구성한 배치를 일정한 작업 단위로 처리합니다. LLM은 요청마다 입력과 출력 길이가 달라 먼저 끝난 요청의 자리가 비어도 긴 요청은 계속 실행될 수 있습니다. 결과를 먼저 반환할 수 있는 구현도 있지만, 고정된 배치가 빈 슬롯을 새 요청으로 채우지 못하면 GPU 활용률은 점차 낮아집니다.
LLM 온라인 추론을 위한 연속 배칭
연속 배칭(continuous batching)은 inflight batching 또는 iteration-level batching이라고도 합니다. 스케줄러는 각 모델 실행 iteration이 끝날 때 활성 배치를 다시 구성합니다.
- 완료된 요청을 활성 배치에서 제거합니다.
- 비어 있는 슬롯에 대기열의 요청을 추가합니다.
- 남은 요청과 새 요청을 다음 iteration에서 함께 처리합니다.
새 요청은 iteration 경계에서 합류합니다. 실행 중인 GPU 커널에는 중간에 추가되지 않습니다. 짧은 요청이 끝난 자리를 바로 재사용하므로 가장 긴 요청이 끝날 때까지 빈 슬롯을 유지하는 문제를 줄일 수 있습니다. 요청 1이 끝나면 요청 4를 넣고, 요청 2가 끝나면 요청 5를 넣는 식으로 활성 배치의 크기를 유지합니다.
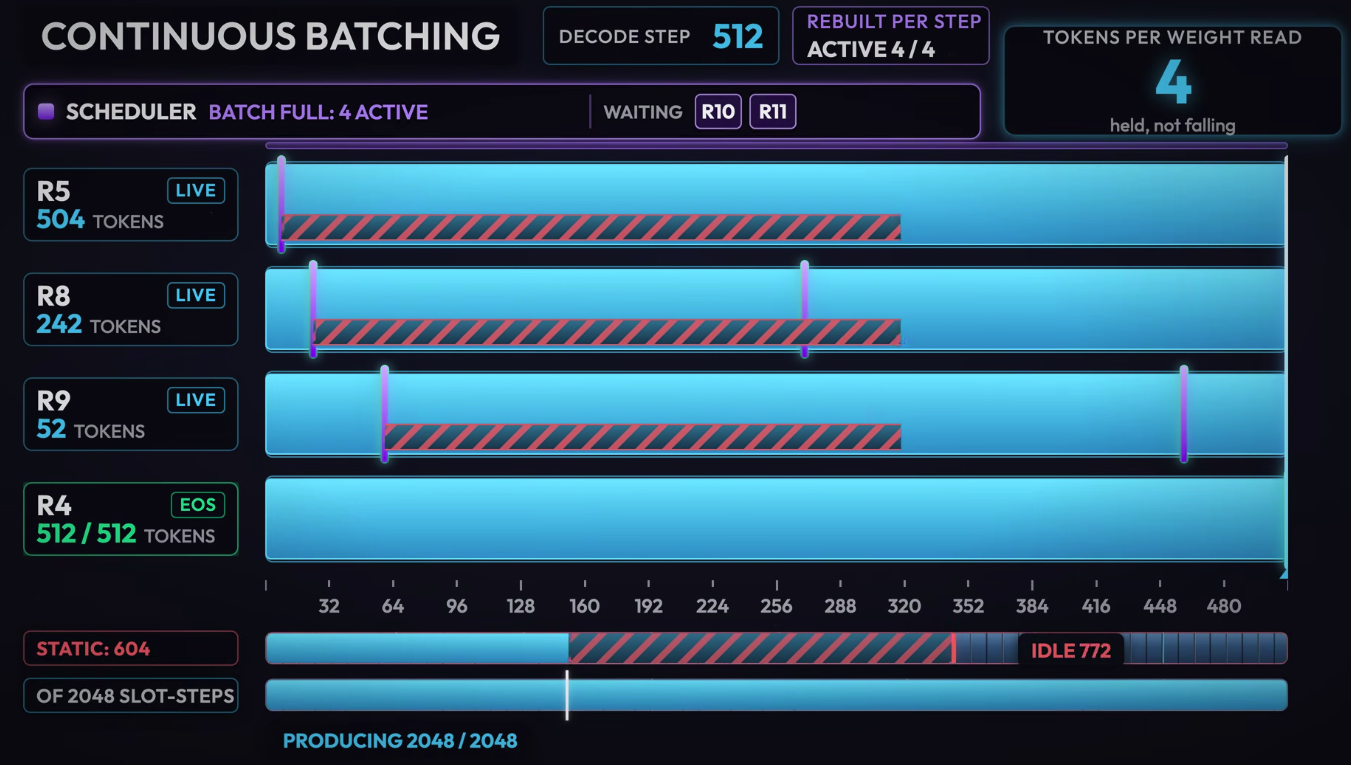
연속 배칭에서는 고정된 시간 창으로 실행 배치를 유지하지 않습니다. 대기열 관리나 입장 제어를 위한 지연 설정은 구현에 따라 존재할 수 있지만, 실행 중인 배치의 핵심 제약은 다음 세 가지입니다.
| vLLM 설정 | 제어 범위 | 의미 |
|---|---|---|
--max-num-seqs |
요청 단위 | 한 iteration에서 함께 처리할 수 있는 최대 시퀀스 수 |
--max-num-batched-tokens |
토큰 단위 | 한 iteration에서 스케줄러가 처리하도록 허용하는 전체 토큰 수 |
--max-model-len |
요청별 길이 | 프롬프트와 생성 토큰을 합친 시퀀스 하나의 최대 길이 |
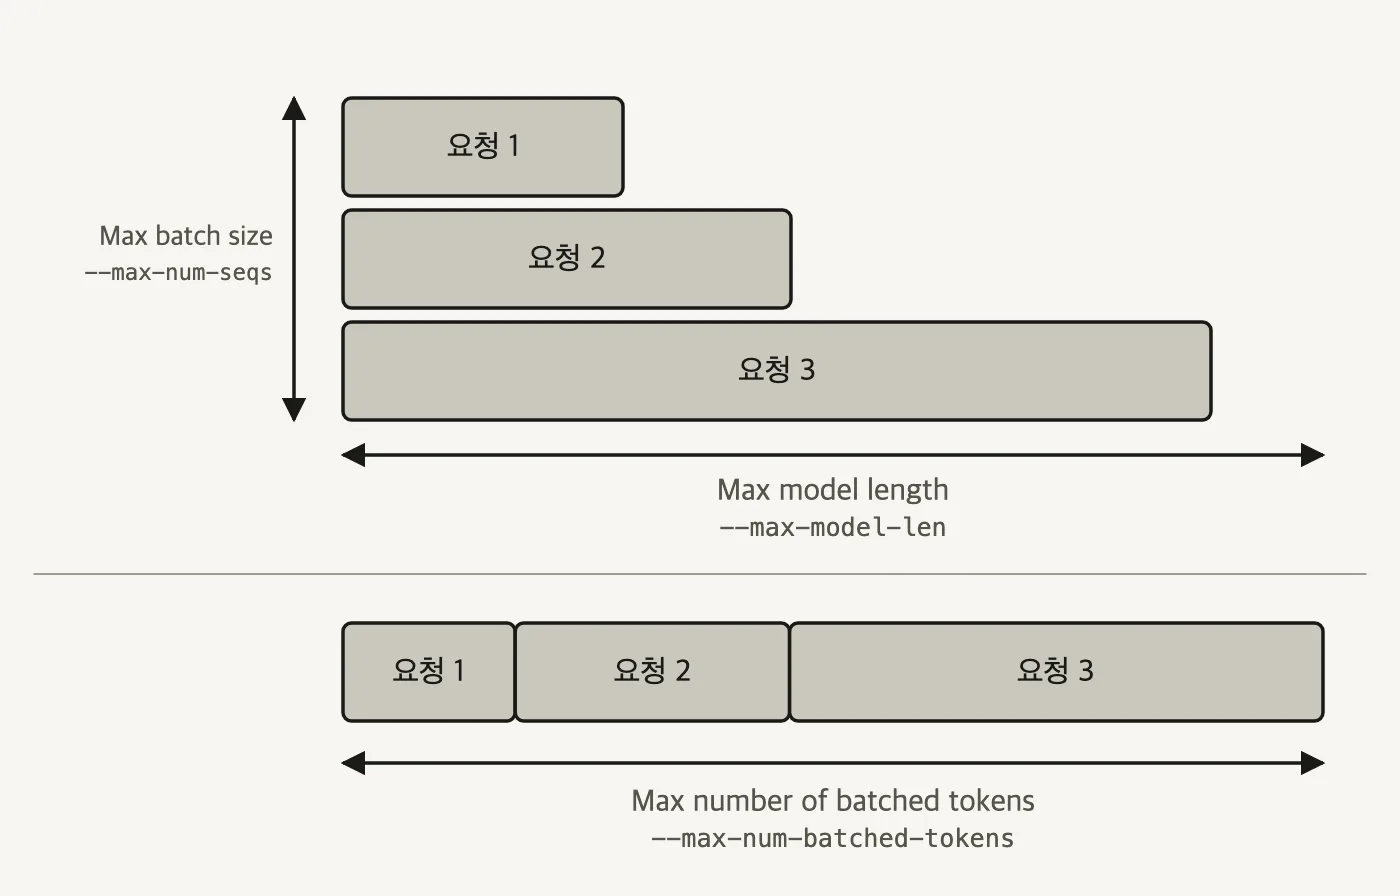
Prefill은 요청 하나가 많은 입력 토큰을 사용하므로 max_num_batched_tokens의 영향을 크게 받습니다. Decode에서는 활성 요청마다 일반적으로 토큰 하나를 처리하므로 병렬성은 max_num_seqs의 영향을 크게 받습니다. 요청 수만 제한하면 짧은 프롬프트 여러 개와 매우 긴 프롬프트 몇 개의 차이를 표현하기 어려우므로 두 설정을 함께 사용합니다.
다음은 각 값의 관계를 보여주기 위한 설정 예시입니다. 실제 값은 모델과 GPU 메모리, 트래픽 분포와 지연시간 목표에 맞춰 조정해야 합니다.
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --max-num-batched-tokens 4096 \
  --max-num-seqs 128 \
  --max-model-len 1024
--max-num-batched-tokens 4096: 한 iteration의 전체 처리 토큰 예산을 4,096개로 제한합니다.
--max-num-seqs 128: 한 iteration에 활성화할 수 있는 시퀀스를 최대 128개로 제한합니다.
--max-model-len 1024: 요청 하나의 프롬프트와 생성 결과를 합친 길이를 최대 1,024토큰으로 제한합니다.
각 옵션의 현재 정의는 vLLM SchedulerConfig 문서에서 확인할 수 있습니다.
청크 프리필(Chunked Prefill)을 이용한 연속 배칭
연속 배칭은 출력 길이가 다른 요청 때문에 배치 슬롯이 비는 문제를 줄입니다. 그러나 긴 Prefill과 짧은 Decode가 같은 스케줄러에서 경쟁하는 문제는 남습니다.
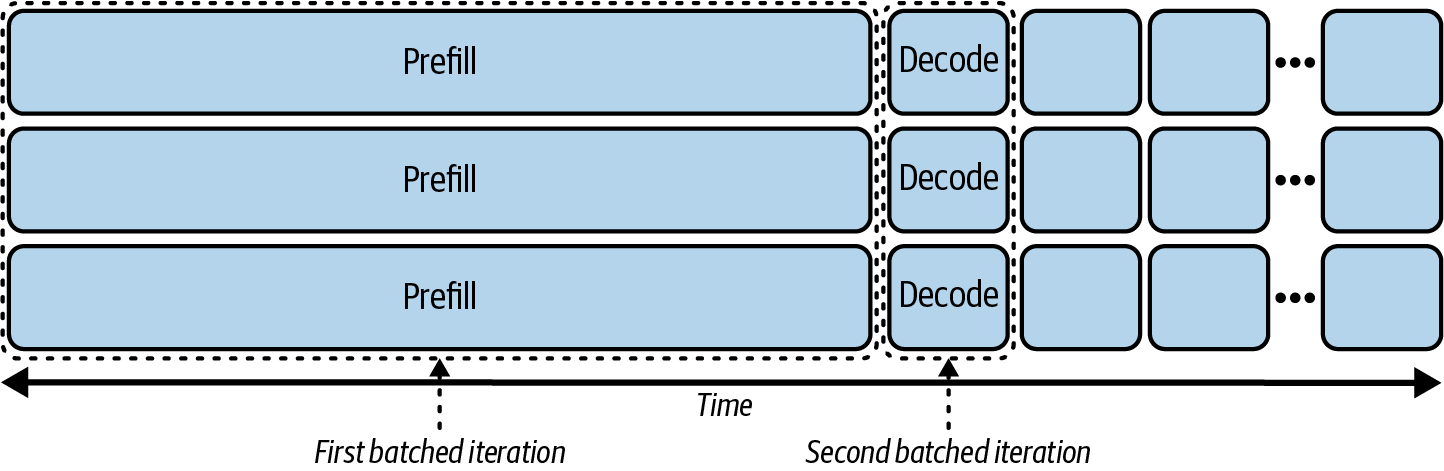
그림 9는 요청의 입력 길이와 출력 길이, 시작 시점이 같은 이상적인 경우입니다. 실제 온라인 트래픽에서는 새 요청의 Prefill이 실행 중인 요청의 Decode 사이에 합류합니다.
- Prefill을 먼저 처리하면 새 요청의 TTFT를 줄일 수 있지만, 실행 중인 Decode가 긴 시간 멈춰 ITL이 나빠질 수 있습니다.
- 긴 Prefill 전체를 Decode와 같은 iteration에 넣으면 함께 실행할 수는 있지만, iteration 시간이 긴 Prefill에 크게 영향을 받습니다.
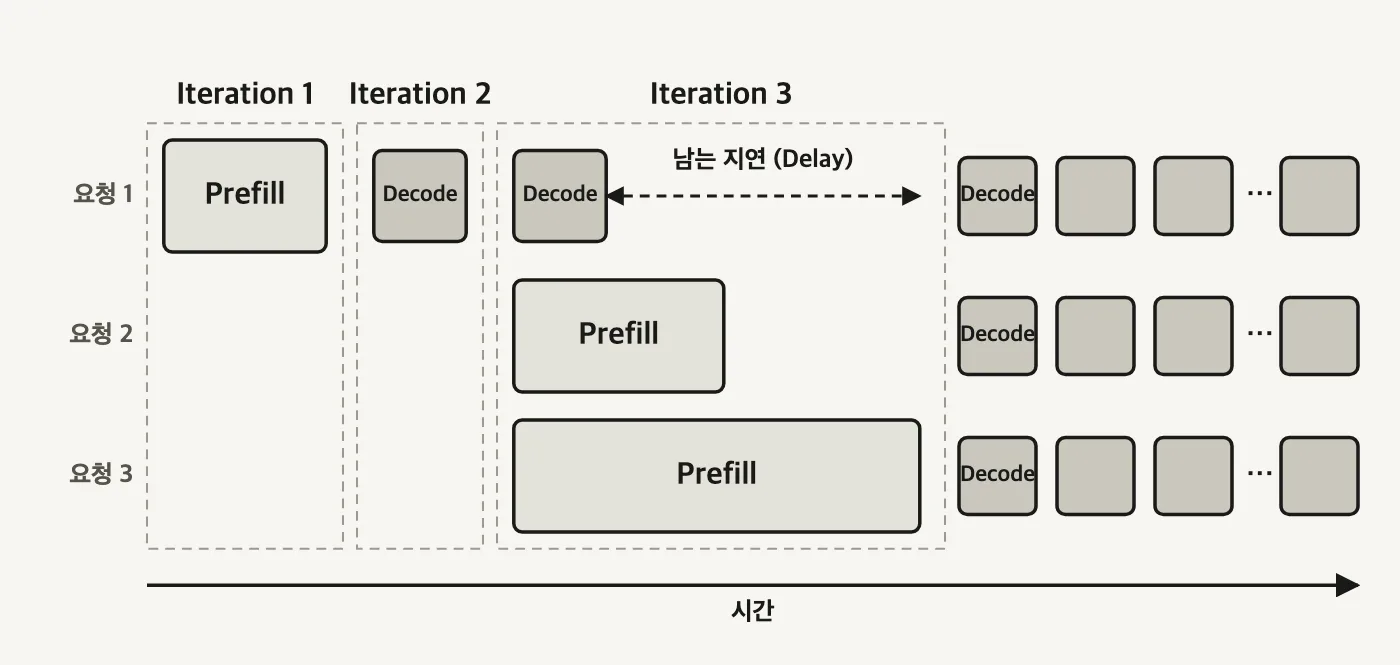
청크 프리필(chunked prefill)은 긴 프롬프트를 여러 토큰 조각으로 나누어 여러 iteration에 걸쳐 처리합니다. 스케줄러는 Decode 요청을 처리하면서 남은 토큰 예산에 Prefill 조각을 배치할 수 있습니다. 긴 Prefill 하나가 Decode를 오랫동안 막는 현상이 줄고, 성격이 다른 두 워크로드를 한 배치에서 함께 활용할 수 있습니다.
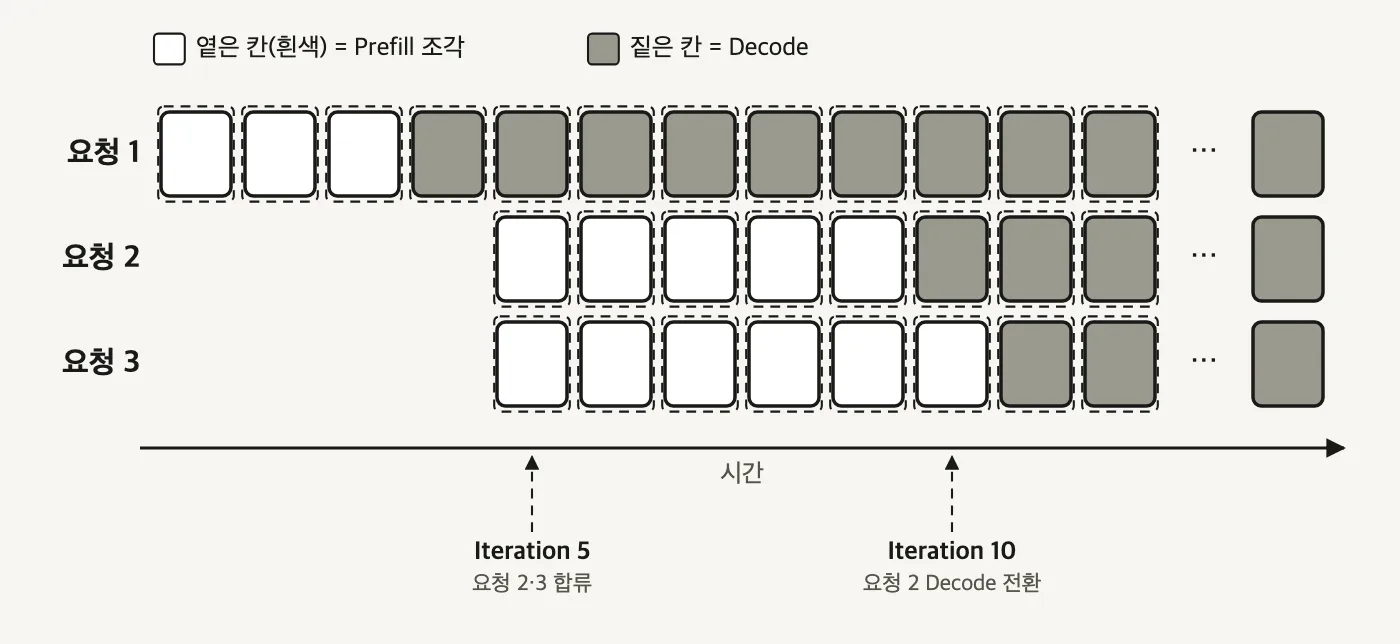
현재 vLLM V1의 청크 프리필 스케줄러는 다음 순서로 동작합니다.
- 대기 중인 Decode 요청을 먼저 배치합니다.
max_num_batched_tokens에서 남은 토큰 예산에 Prefill 요청을 추가합니다.- 남은 예산보다 Prefill이 길면 들어갈 수 있는 만큼만 청크로 나눕니다.
- 처리하지 못한 Prefill 토큰은 다음 iteration에서 이어서 계산합니다.
max_num_batched_tokens는 한 iteration의 전체 토큰 예산입니다. 고정된 청크 크기를 직접 지정하는 옵션은 아닙니다. Decode를 먼저 배치하고 남은 예산에 따라 실제 Prefill 청크 크기가 결정됩니다.
| 토큰 예산 | 장점 | 주의할 점 |
|---|---|---|
| 작은 값 | Prefill이 Decode를 막는 시간이 짧아져 ITL에 유리합니다. | iteration 횟수와 스케줄링 오버헤드가 늘고 Prefill 진행이 느려져 TTFT와 처리량에 불리할 수 있습니다. |
| 큰 값 | 한 번에 더 많은 Prefill 토큰을 처리해 TTFT와 Prefill 처리 효율에 유리합니다. | 긴 Prefill 조각이 Decode를 더 오래 지연시켜 ITL이 나빠질 수 있습니다. |
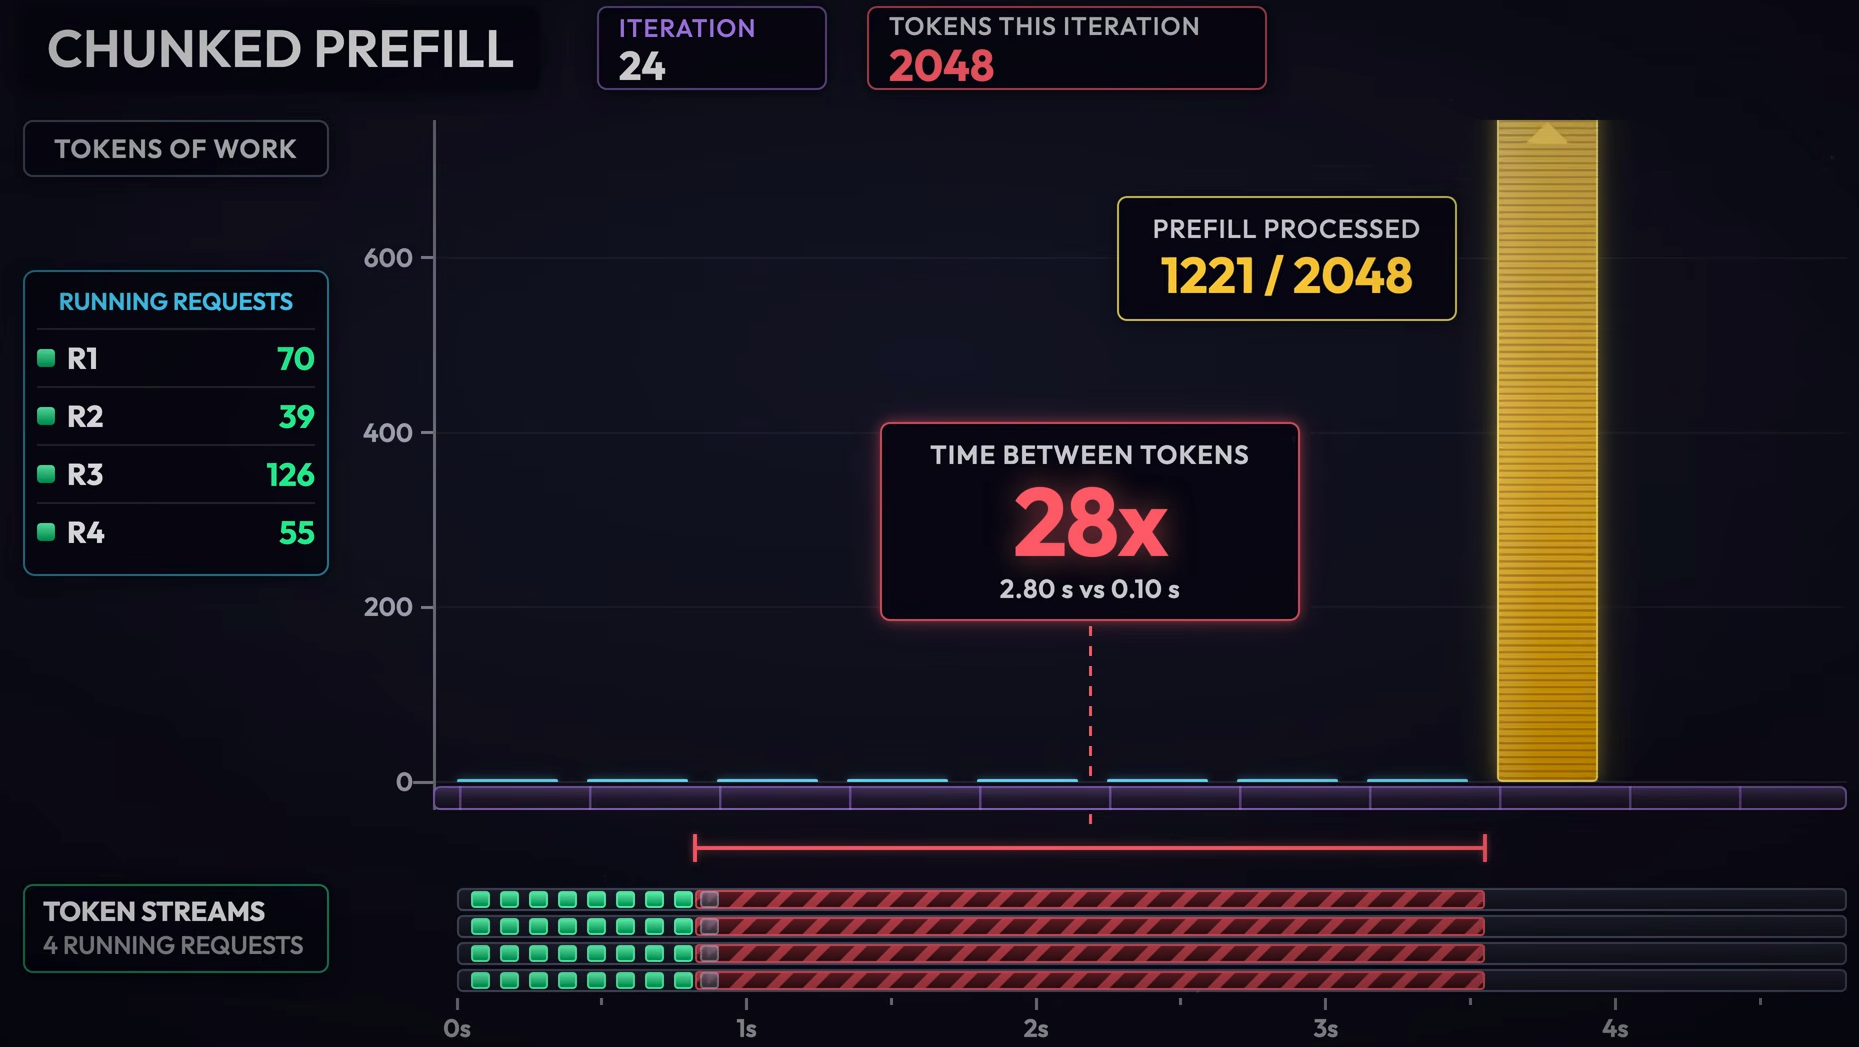
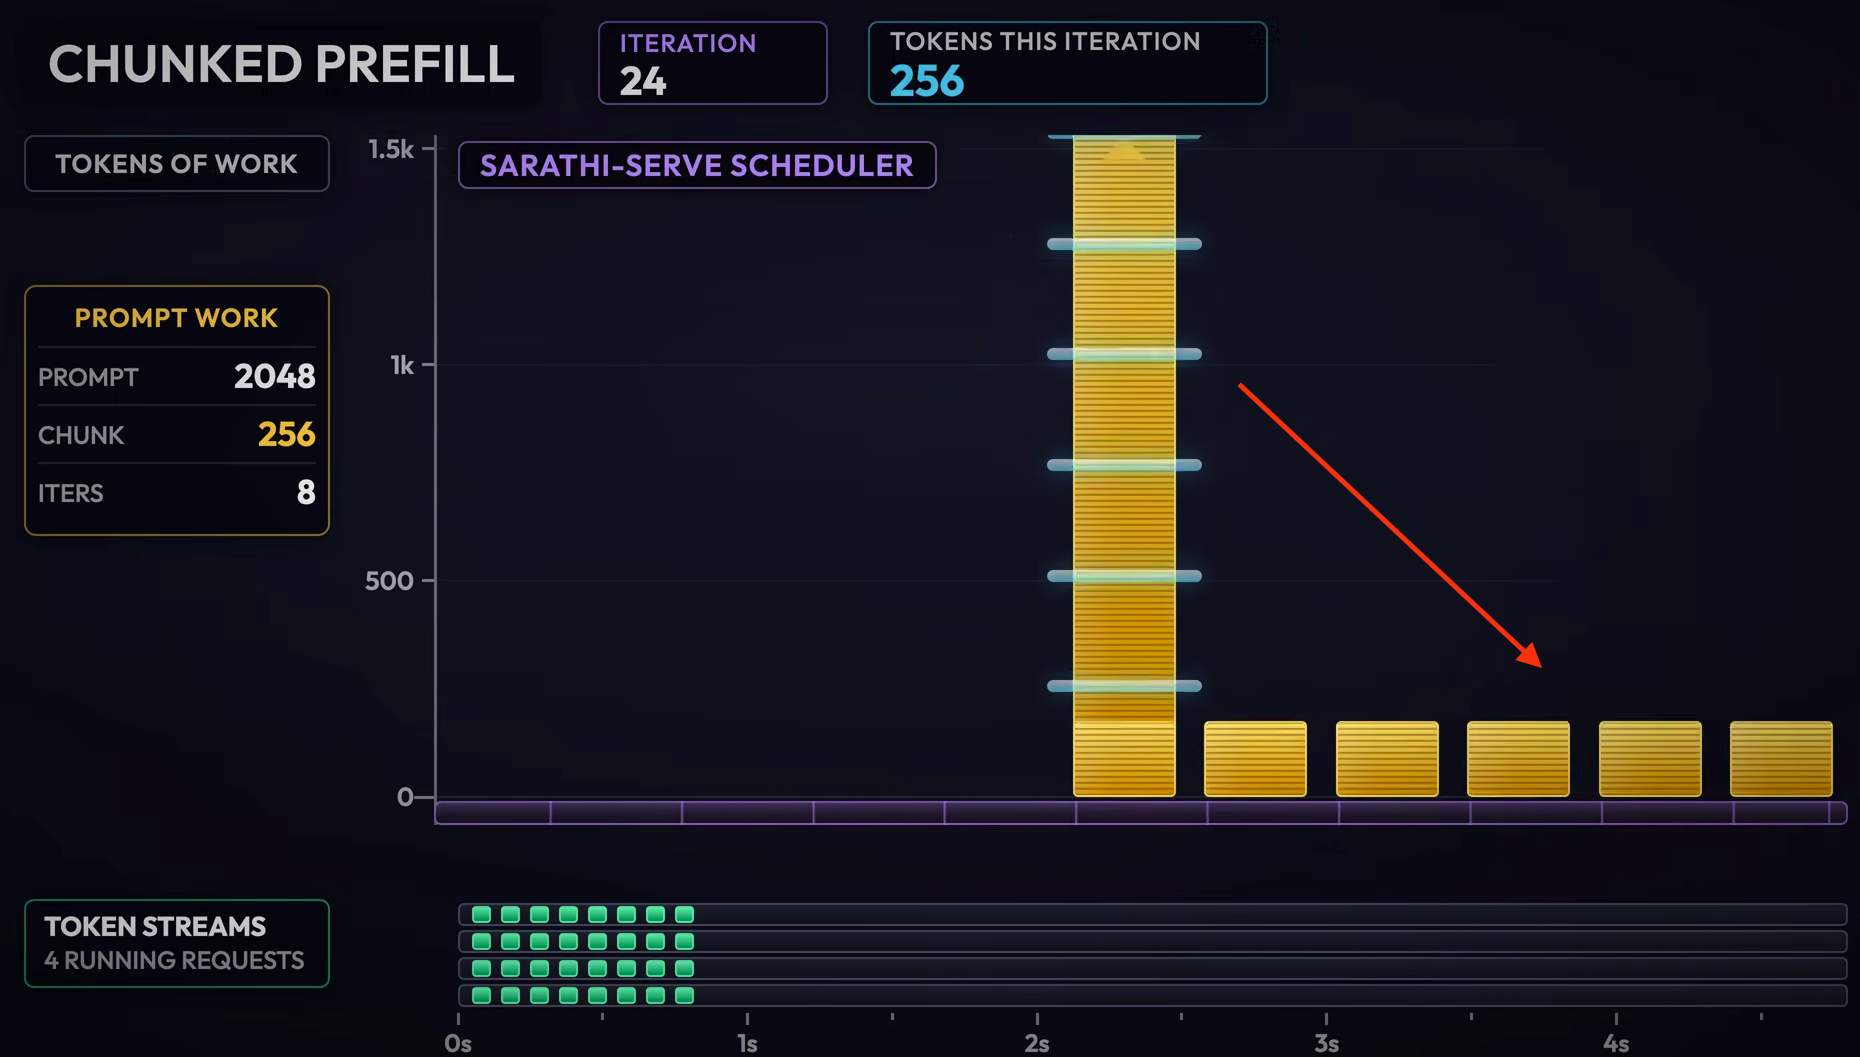
그림 12와 그림 13의 수치는 특정 설정을 비교한 예시입니다. 일반적인 결론은 청크를 작게 나눌수록 Decode가 긴 Prefill에 막히는 시간이 짧아지고, 그만큼 Prefill iteration과 스케줄링 횟수가 늘어난다는 점입니다.
따라서 청크 프리필의 효과는 하나의 지표로 고정되지 않습니다. 작은 토큰 예산은 ITL을 우선하고, 큰 토큰 예산은 TTFT와 Prefill 처리 효율을 우선합니다. 처리량과 종단 지연시간은 모델, GPU와 입력·출력 길이 분포를 기준으로 측정해야 합니다.
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --enable-chunked-prefill \
  --max-num-batched-tokens 2048 \
  --max-num-seqs 128 \
  --max-model-len 4096
vLLM V1에서는 지원 가능한 모델에 청크 프리필이 기본으로 활성화됩니다. 위 예시에서는 의도를 드러내기 위해 옵션을 명시했습니다.
max_num_batched_tokens에 따른 TTFT와 ITL의 관계는 vLLM Optimization and Tuning 문서에서 확인할 수 있습니다.
청크 프리필은 긴 컨텍스트가 많은 환경에서 Decode 지연을 완화하고 GPU 활용률을 높이는 데 유용합니다. 스케줄링과 KV 캐시 관리가 복잡해지는 비용도 있으므로 TTFT, ITL, 처리량과 메모리 사용량을 함께 측정해 토큰 예산을 정해야 합니다. 더 큰 규모에서는 Prefill과 Decode를 서로 다른 GPU나 노드로 분리하는 방식도 사용할 수 있으며, 이는 이후 장에서 다룹니다.
스케일링 어텐션과 (GPU) 커널 최적화
트랜스포머 블록은 크게 어텐션 레이어와 피드포워드 레이어(FFN 또는 MLP)로 구성됩니다. 이 절에서는 두 구성요소 중 어텐션을 긴 컨텍스트와 높은 동시 요청 수에 맞게 효율적으로 확장하는 방법을 살펴봅니다.
어텐션 최적화는 다음 세 가지 흐름으로 나눌 수 있습니다.
- 어텐션 구조 최적화: MHA(Multi-Head Attention) 이후 등장한 MQA(Multi-Query Attention), GQA(Grouped-Query Attention)와 MLA(Multi-head Latent Attention)를 살펴봅니다. 이 구조들은 K와 V의 공유 또는 압축 방식을 바꿔 모델 품질 저하를 줄이면서 KV 캐시 크기와 메모리 접근량을 낮추는 것을 목표로 합니다.
- GPU 커널 최적화: 여러 연산을 합치는 커널 퓨전부터 어텐션과 하드웨어 특성에 맞춰 메모리 접근을 줄이는 FlashAttention 등의 커널을 살펴봅니다.
- KV 캐시 메모리 관리: PagedAttention이 KV 캐시를 고정된 블록 단위로 관리해 메모리 파편화와 과도한 사전 할당을 줄이는 원리를 살펴봅니다.
먼저 MQA, GQA와 MLA가 KV 캐시의 논리적인 크기를 줄이는 방법을 알아봅니다. 이어서 커스텀 GPU 커널이 어텐션 연산과 메모리 접근을 개선하는 방식을 살펴보고, 마지막으로 PagedAttention이 KV 캐시의 GPU 메모리 저장과 할당 방식을 개선하는 과정을 다룹니다.
확장 가능한 어텐션 메커니즘[1]
Decode 단계에서는 새 토큰을 생성할 때마다 이전 토큰의 K와 V를 KV 캐시에서 읽습니다. 컨텍스트가 길어질수록 HBM에서 온칩 메모리로 가져와야 할 데이터가 늘어나므로 KV 캐시의 크기는 메모리 용량과 대역폭 모두에 영향을 줍니다.
KV 캐시를 줄이면 다음과 같은 이점이 있습니다.
- Decode iteration의 메모리 전송량이 감소합니다.
- 요청 하나가 차지하는 GPU 메모리가 줄어 더 많은 요청을 동시에 처리할 수 있습니다.
- 같은 GPU 메모리에서 더 긴 컨텍스트를 유지할 수 있습니다.
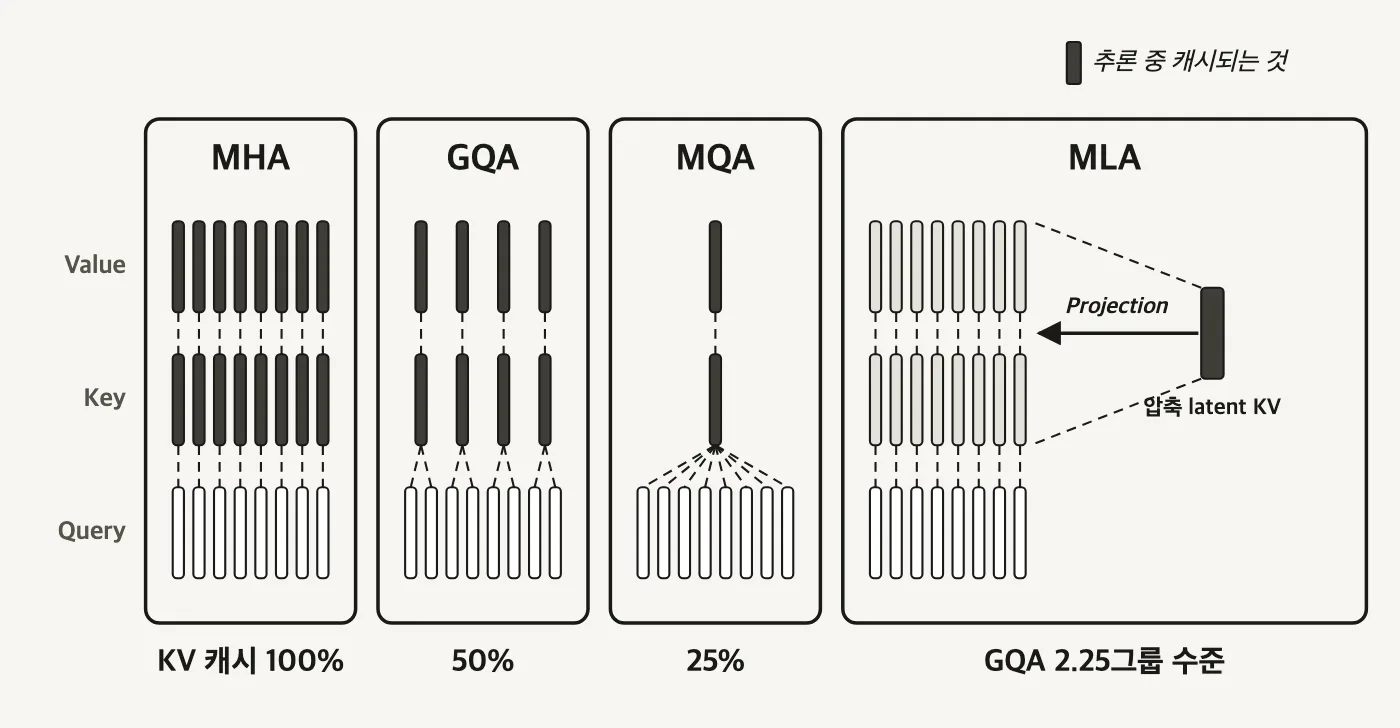
그림 14의 GQA 50%와 MQA 25%는 쿼리 헤드 4개에 KV 헤드를 각각 2개와 1개 사용한 예시입니다. 실제 절감률은 전체 쿼리 헤드 수와 KV 헤드 수, 헤드 차원과 모델 구조에 따라 달라집니다. MLA의 GQA 2.25그룹 수준도 DeepSeek-V2의 구성을 GQA와 비교한 값입니다.
MHA(Multi-Head Attention)
MHA는 각 쿼리 헤드에 대응하는 K와 V 헤드를 따로 둡니다. 쿼리 헤드 수와 KV 헤드 수가 같으므로 각 헤드의 표현력을 독립적으로 유지할 수 있지만, 네 방식 중 KV 캐시가 가장 큽니다.
MQA(Multi-Query Attention)
MQA는 모든 쿼리 헤드가 하나의 K 헤드와 V 헤드를 공유합니다. 쿼리 헤드가
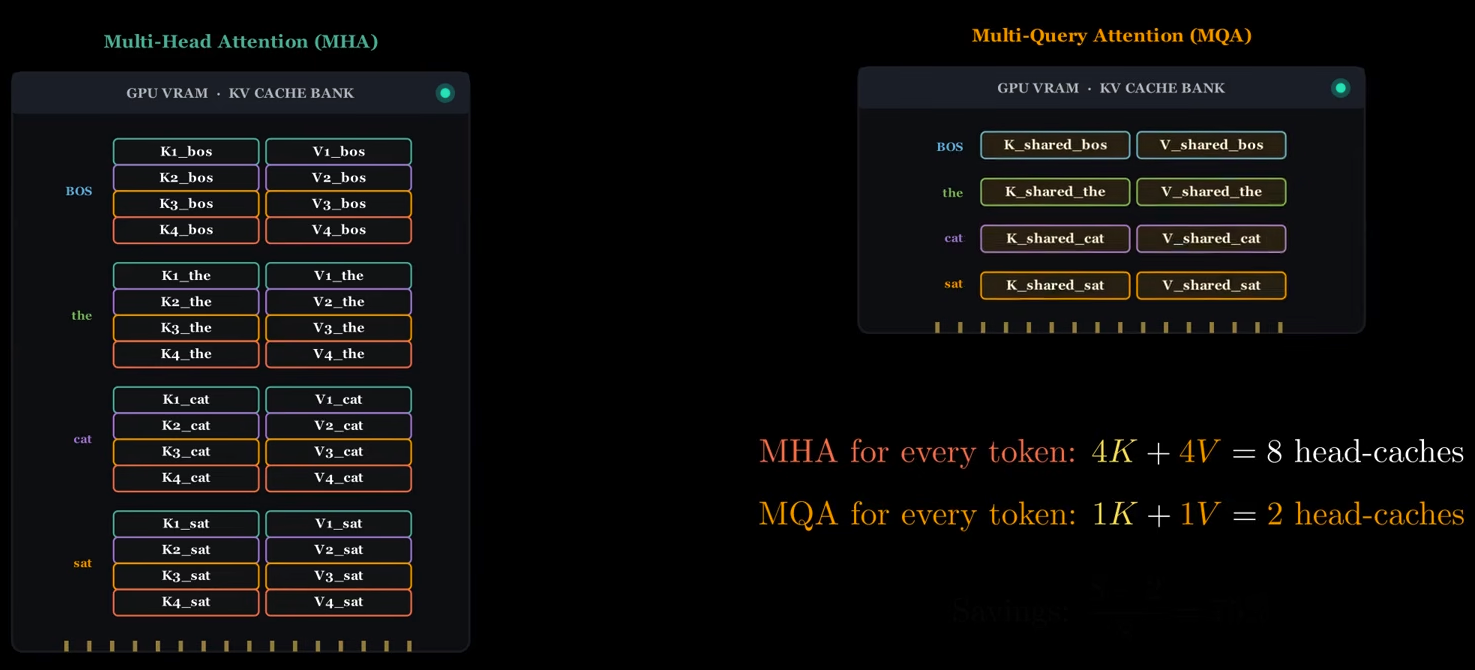
GQA(Grouped-Query Attention)
GQA는 쿼리 헤드를 여러 그룹으로 나누고 같은 그룹의 쿼리들이 하나의 K와 V 헤드를 공유합니다. KV 헤드 수가
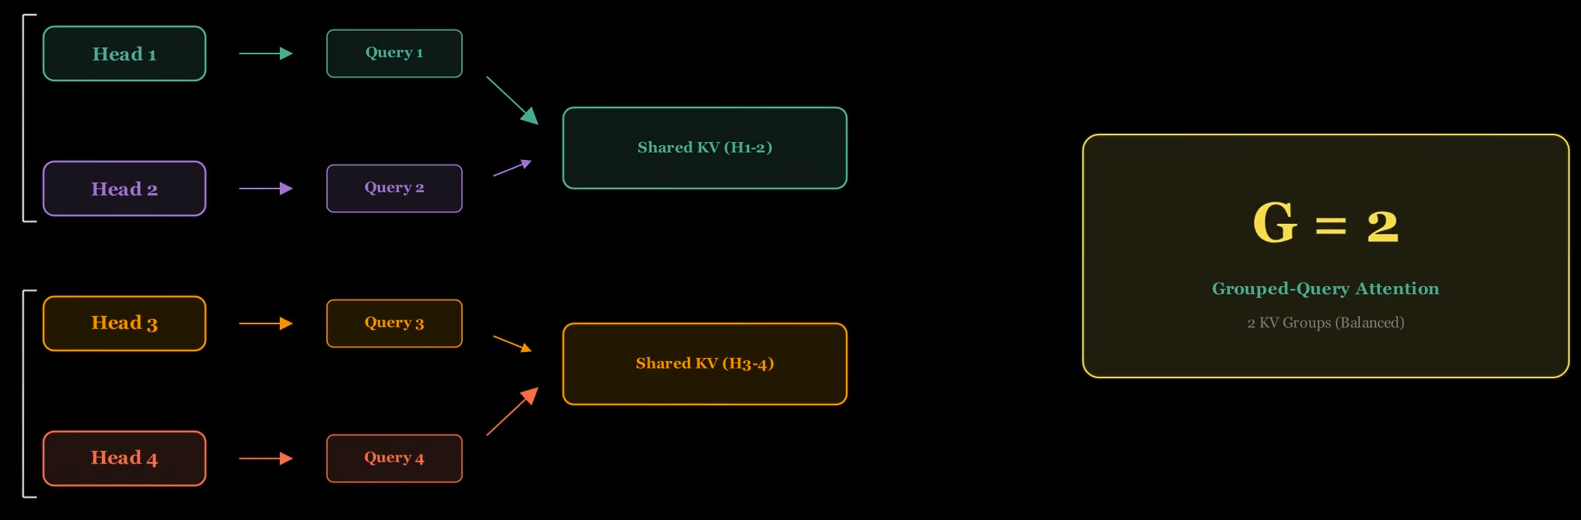
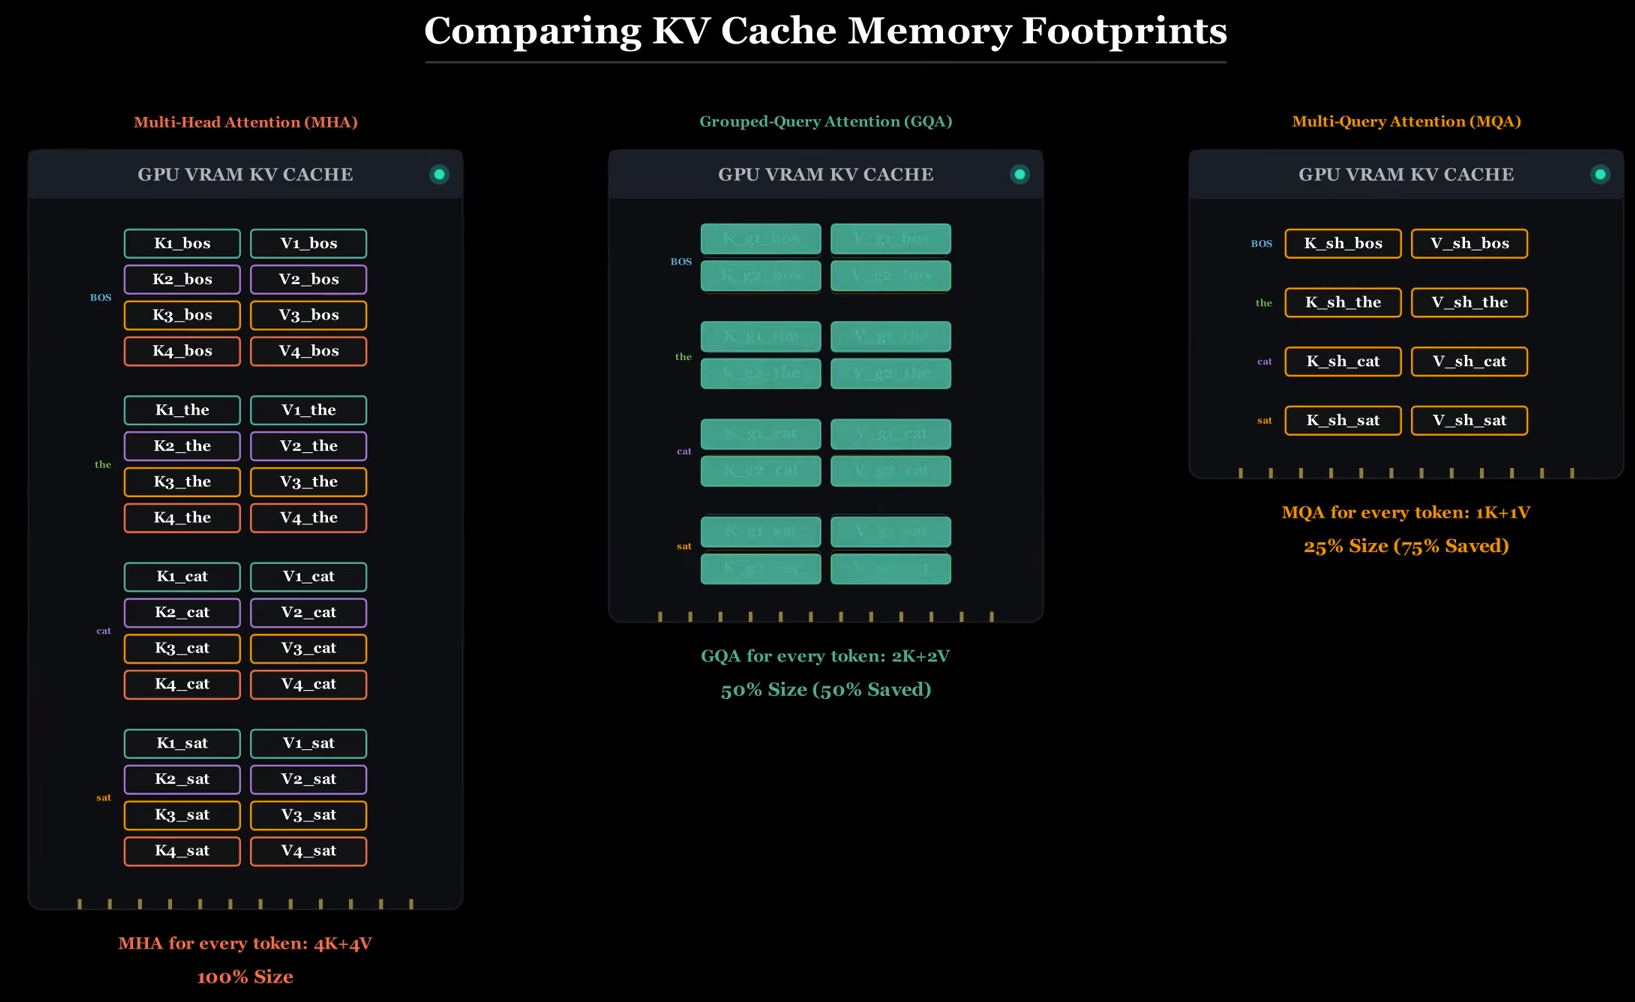
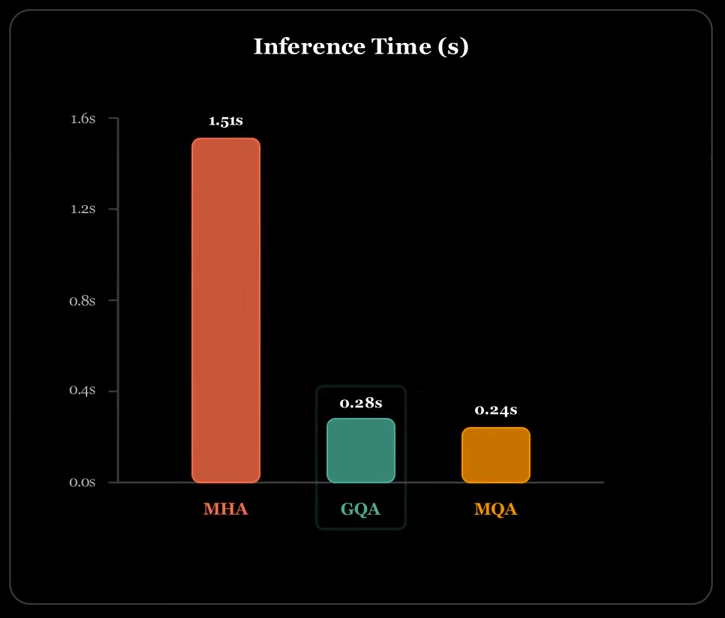
KV 헤드가 줄면 캐시 용량과 Decode 시 읽을 데이터가 함께 감소하므로 추론 성능도 개선될 수 있습니다. 다만 그림 18의 시간은 특정 실험에서 얻은 예시이며, 일반적인 속도 비율은 아닙니다. 실제 결과는 모델과 GPU, 컨텍스트 길이, 배치 크기와 커널 구현에 따라 달라집니다.
MLA(Multi-head Latent Attention)
MLA는 KV 헤드 수를 공유하는 대신 K와 V를 저차원 latent 표현으로 함께 압축하고, Decode에 필요한 압축 표현을 캐싱합니다. 연산 시에는 이 표현을 투영해 각 헤드가 사용할 정보를 구성합니다. DeepSeek-V2는 MLA를 도입해 기존 DeepSeek 67B보다 KV 캐시를 93.3% 줄였다고 보고했습니다. 구조와 측정 조건은 DeepSeek-V2 기술 보고서에서 확인할 수 있습니다.
MHA, MQA와 GQA는 KV 헤드의 공유 범위를 조정하고, MLA는 캐싱할 표현 자체를 압축합니다. 따라서 이 구조들을 하나의 단순한 우열 관계로 보기보다 모델 품질, KV 캐시 크기, 지원 커널과 하드웨어를 함께 비교해야 합니다.
Hybrid Attention
긴 컨텍스트에서는 전체 토큰 쌍을 비교하는 전역 어텐션의 계산량과 KV 캐시가 계속 증가합니다. 이를 줄이기 위해 Linear Attention과 recurrent state, sliding-window attention 등은 중간 상태를 압축하거나 어텐션 범위를 제한합니다. 압축 과정에서 세부 정보가 희석될 수 있으므로 DeltaNet 계열은 상태를 갱신하고, 게이트를 추가한 구조는 오래된 정보의 감쇠와 새로운 정보의 반영 정도를 조절합니다.
Kimi K3는 Kimi Delta Attention(KDA) 3개 층과 Gated MLA 1개 층을 반복하는 Hybrid Attention을 사용합니다. KDA는 고정 크기의 recurrent state로 긴 시퀀스를 효율적으로 처리하고, Gated MLA는 주기적으로 전역 어텐션을 수행해 압축된 상태만으로 처리하기 어려운 정보를 보완합니다. 이 구성은 Kimi K3 공식 설명과 공식 모델 저장소에서 확인할 수 있습니다.
모델 설정에서 어텐션 방식 확인하기
일반적인 MHA, GQA와 MQA 계열은 Hugging Face 모델의 config.json에서 num_attention_heads와 num_key_value_heads를 비교해 구분할 수 있습니다.
# MHA: 쿼리 헤드 수와 KV 헤드 수가 같습니다.
"num_attention_heads": 32,
"num_key_value_heads": 32

# GQA: 쿼리 헤드 수보다 KV 헤드 수가 적고 1보다 큽니다.
"num_attention_heads": 32,
"num_key_value_heads": 8
# KV 헤드 하나를 쿼리 헤드 4개가 공유합니다.

# MQA: KV 헤드가 하나입니다.
"num_attention_heads": 32,
"num_key_value_heads": 1
이 두 값만으로 판단할 수 있는 범위는 일반적인 MHA, GQA와 MQA 계열입니다. MLA나 Hybrid Attention은 모델별 설정과 구현을 추가로 확인해야 합니다.
어텐션 구조는 서빙 단계에서 임의로 교체하는 옵션이 아니라 모델 아키텍처의 일부입니다. 따라서 모델을 선택할 때 품질뿐 아니라 목표 컨텍스트 길이, 동시 요청 수, KV 캐시 사용량과 서빙 프레임워크의 커널 지원까지 함께 평가해야 합니다.
커널 퓨전과 커스텀 어텐션 커널
GPU 커널(kernel)은 GPU에서 실행되는 작고 특화된 프로그램입니다. 행렬곱, 정규화와 Softmax처럼 모델을 구성하는 연산은 하나 이상의 커널로 실행됩니다. 같은 수식을 계산하더라도 모델 구조와 입력 shape, 데이터 타입과 GPU 세대에 맞는 커널을 사용하면 메모리 이동과 실행 오버헤드를 줄여 GPU 활용률과 처리량을 높일 수 있습니다.
CUDA의 소프트웨어 실행 단위는 thread, warp, thread block과 grid의 계층으로 구성됩니다. thread 32개가 일반적으로 하나의 warp를 이루고, 여러 warp로 구성된 thread block은 하나의 SM(Streaming Multiprocessor)에 배치됩니다. 같은 block의 thread는 해당 SM의 레지스터와 shared memory를 이용해 데이터를 빠르게 공유할 수 있습니다.
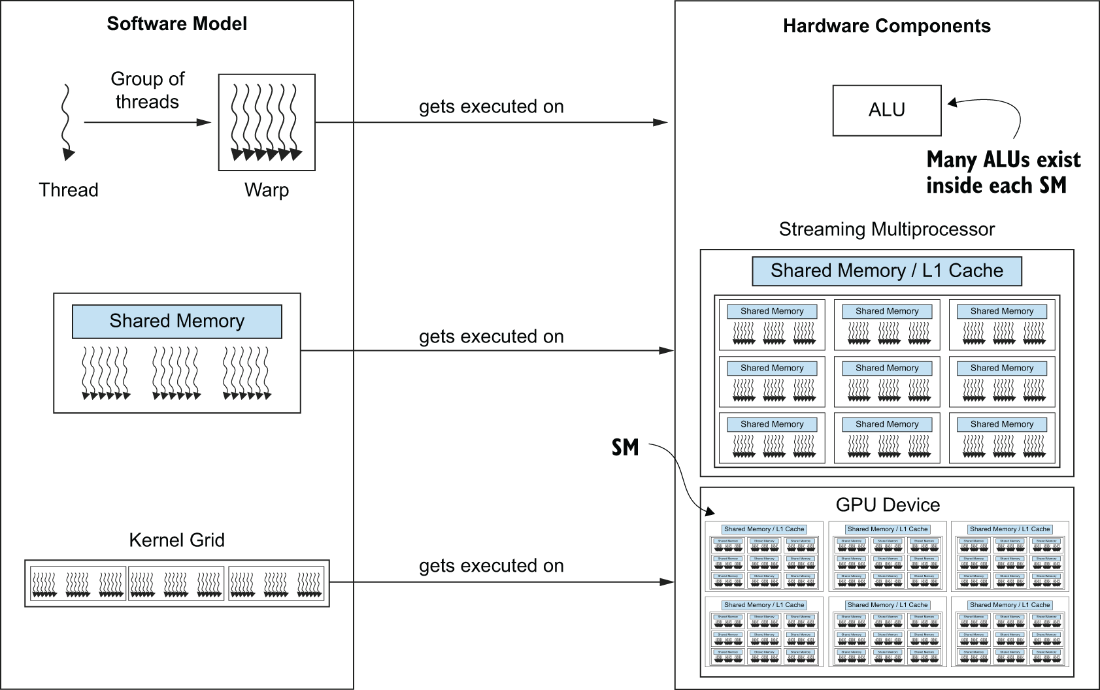
커널 정의와 실행 과정은 사용하는 프레임워크에 따라 다릅니다. Triton처럼 JIT 컴파일을 사용하는 경우에는 host인 CPU에서 커널을 정의하고 첫 호출에 컴파일한 뒤, GPU에 grid를 실행하도록 요청합니다. GPU는 grid의 block을 사용 가능한 SM에 배치해 병렬로 실행합니다.
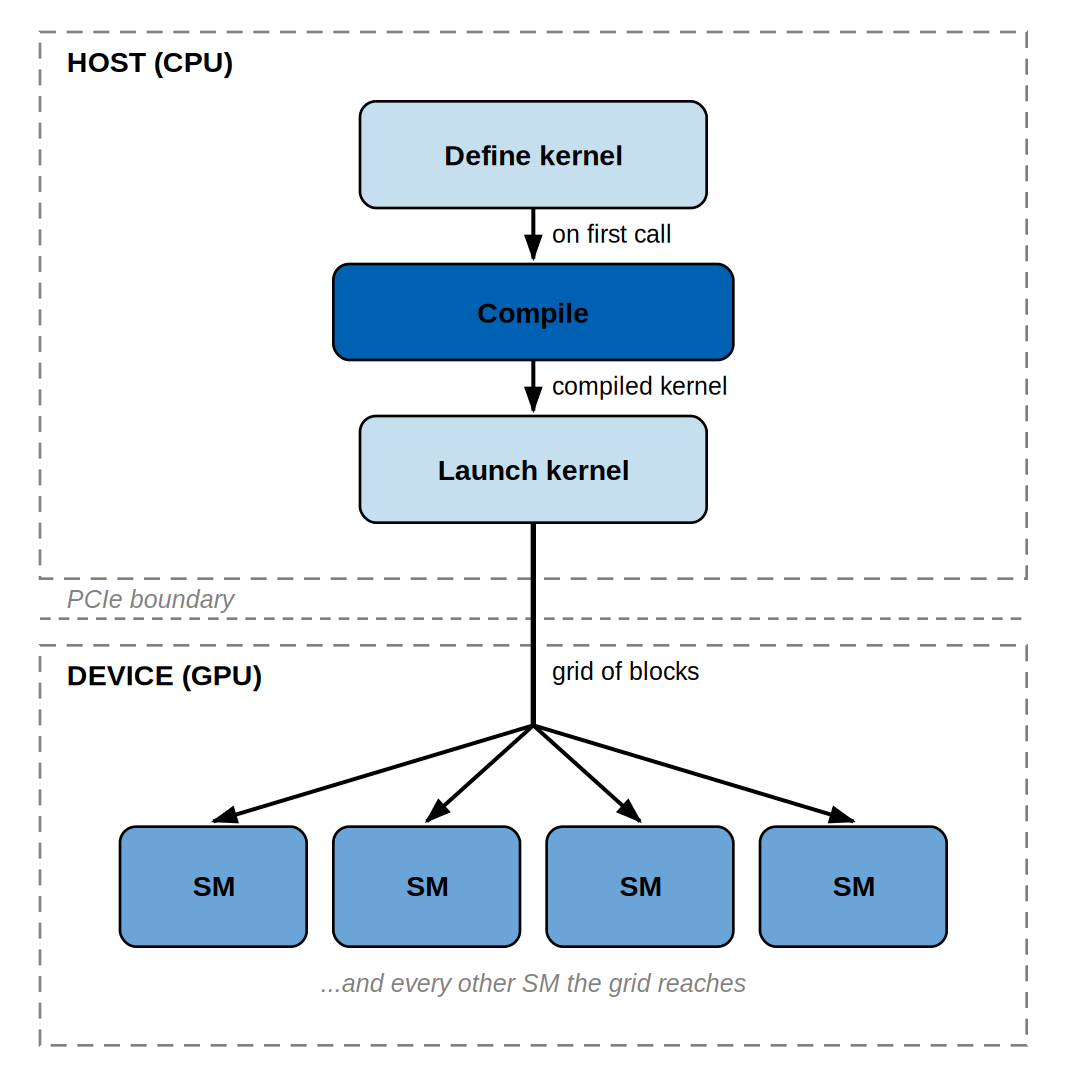
이 구조의 성능 비용에는 연산 시간, 반복적인 커널 실행과 중간 결과를 HBM에 쓰고 다시 읽는 시간이 모두 포함됩니다. 커널 퓨전과 FlashAttention은 이 데이터 이동을 줄이는 대표적인 방법입니다.
커널 퓨전
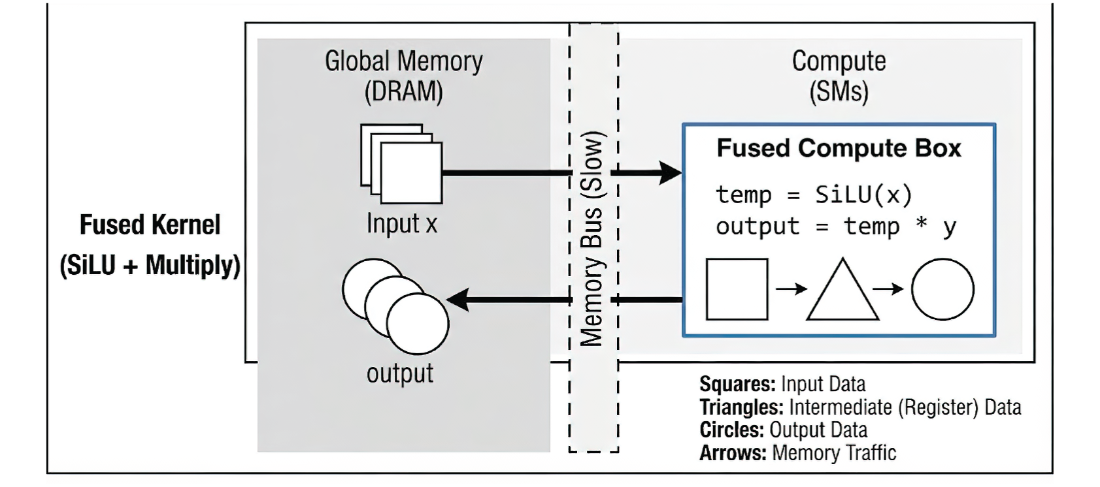
커널 퓨전(kernel fusion)은 연속된 여러 연산을 하나의 커널로 합치는 기법입니다. 개별 커널로 실행하면 각 단계의 중간 결과를 GPU 글로벌 메모리에 쓴 뒤 다음 커널이 다시 읽어야 합니다. 연산을 합치면 중간값을 레지스터나 shared memory에 유지한 채 다음 계산에 사용할 수 있습니다.
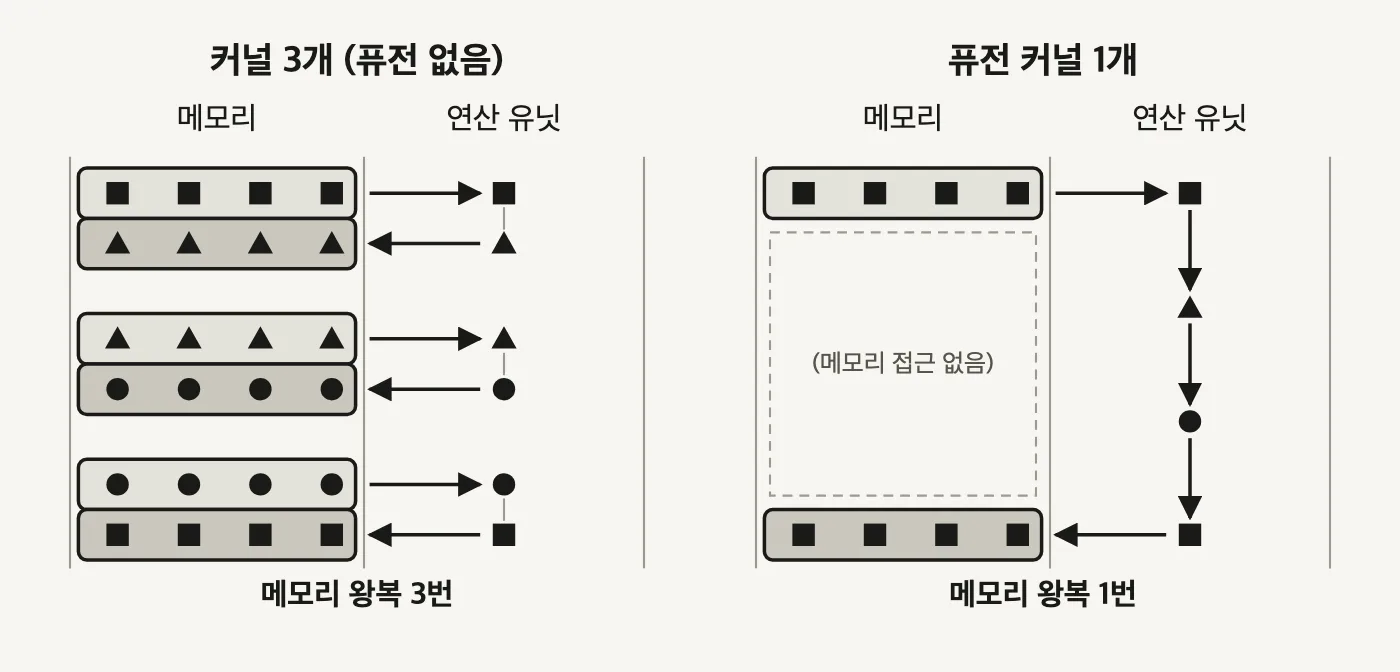
예를 들어 SiLU와 곱셈을 따로 실행하면 SiLU 결과를 HBM에 기록하고 다시 가져와야 합니다. 하나의 퓨전 커널에서는 입력을 읽은 뒤 SiLU 결과를 레지스터에 유지하고 곧바로 곱셈을 수행해 최종 출력만 HBM에 기록합니다.
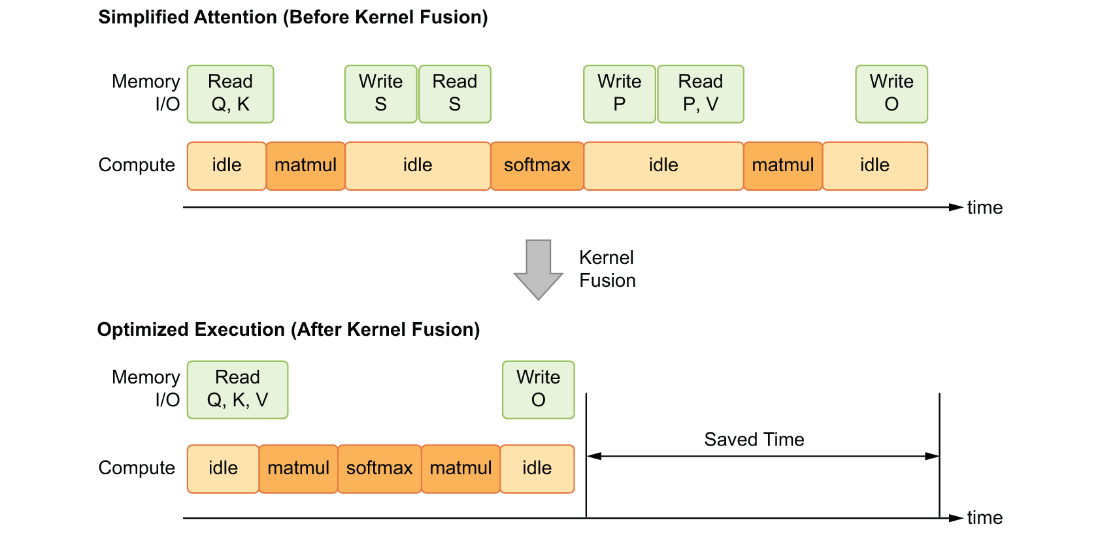
어텐션에서도 QK 행렬곱, Softmax와 PV 행렬곱을 별도 커널로 실행하면 중간 행렬을 쓰고 읽는 동안 연산 장치가 대기할 수 있습니다. 그림 23은 이 과정을 하나의 실행 흐름으로 합쳤을 때 줄어드는 메모리 I/O와 유휴 시간을 단순화해 보여줍니다. 실제 퓨전 범위와 커널 구성은 백엔드와 GPU에 따라 달라집니다.
FlashAttention
표준 어텐션을 여러 커널로 구현하면
FlashAttention은 HBM과 온칩 SRAM 사이의 I/O를 고려해 설계한 정확한 어텐션 알고리즘입니다. Q, K와 V를 작은 tile로 나누고, tile 단위의 행렬곱과 online softmax를 레지스터와 shared memory에서 처리합니다. 전체
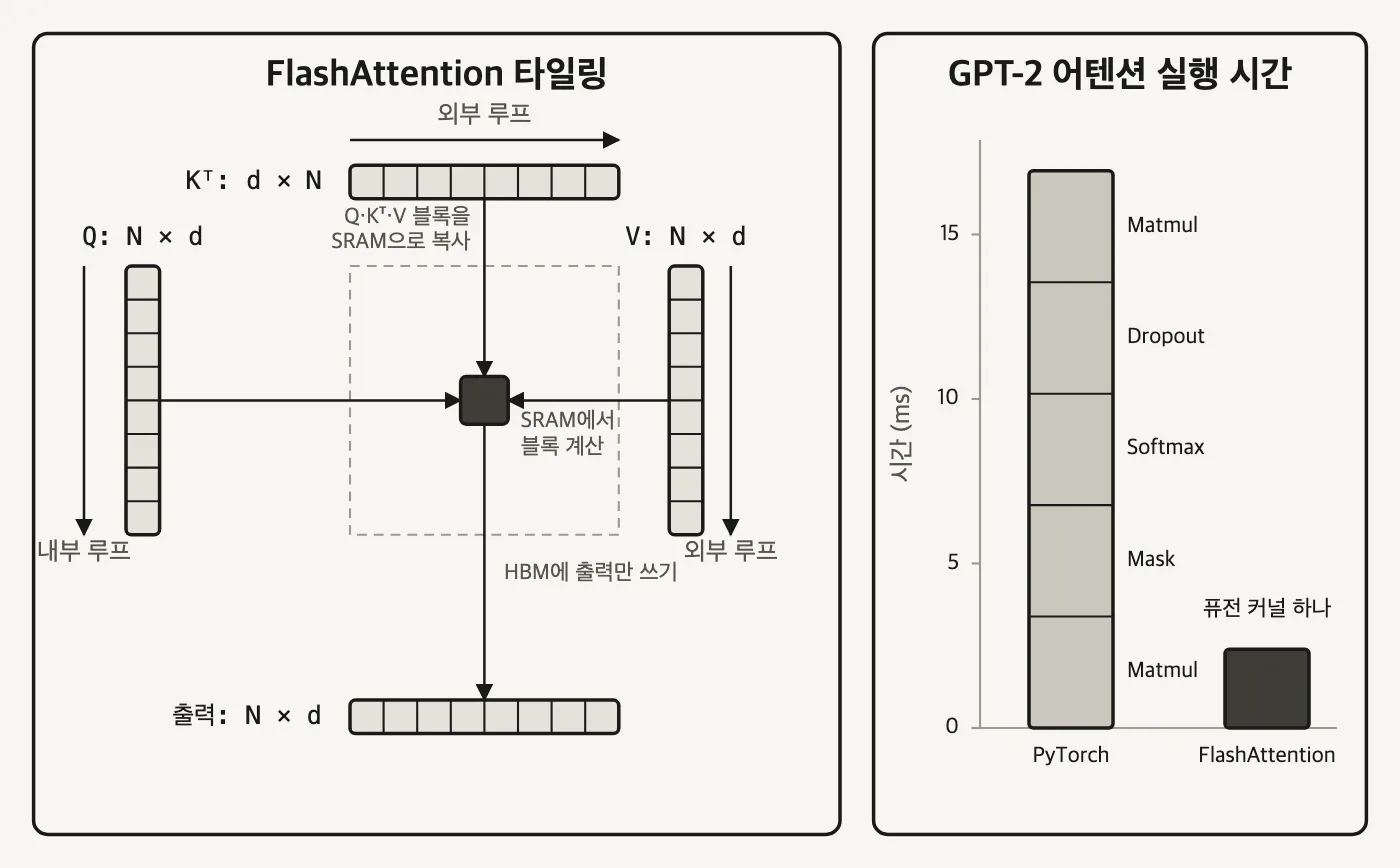
그림 24 오른쪽의 실행시간은 논문에 제시된 GPT-2 어텐션 사례를 단순화한 값입니다. 모든 모델과 GPU에서 같은 비율의 속도 향상을 보장하지 않으며, 입력 길이와 데이터 타입, GPU와 비교 대상 커널에 따라 결과가 달라집니다.
FlashAttention이 줄이는 병목을 기존 구현의 흐름으로 보면 그림 25와 같습니다.
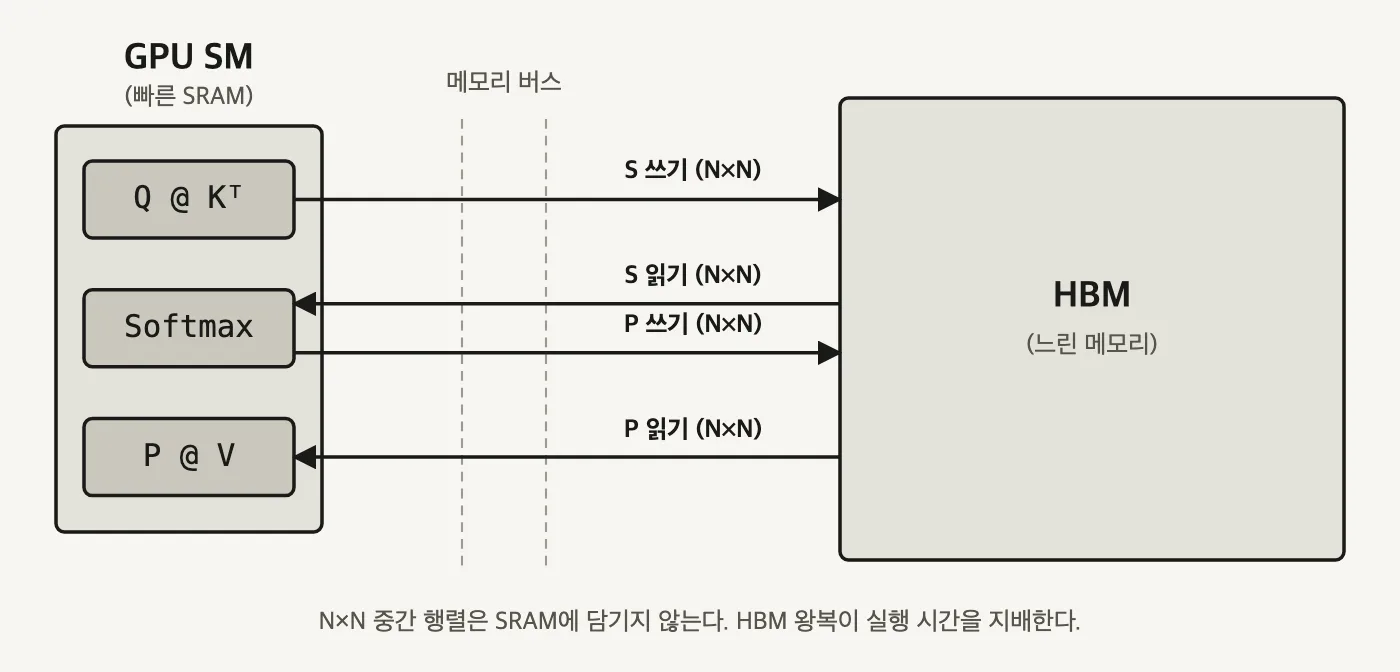
FlashAttention-2는 thread block과 warp 사이의 작업 분할을 개선하고 비행렬곱 연산을 줄여 병렬성과 GPU 점유율을 높였습니다. FlashAttention-3는 Hopper GPU의 비동기 Tensor Core와 TMA를 활용해 데이터 이동과 연산을 겹치고, block 단위 행렬곱과 Softmax를 중첩합니다. 자세한 차이는 FlashAttention-2 논문과 FlashAttention-3 논문에서 확인할 수 있습니다.
커널 구현에는 CUDA와 GPU 아키텍처, 컴파일러와 성능 프로파일링에 대한 전문성이 필요합니다. 모델을 서빙하는 입장에서는 커널을 직접 작성하기보다 vLLM이나 SGLang이 제공하는 자동 선택을 기본값으로 사용하고, 목표 워크로드를 벤치마크한 뒤 필요할 때 백엔드를 변경하는 편이 일반적입니다. FlashInfer, xFormers와 Triton도 사용할 수 있으며, 커널 작성 언어인 Triton은 NVIDIA Triton Inference Server와 다른 프로젝트입니다.
vLLM은 하드웨어와 모델 구성을 기준으로 어텐션 백엔드와 FlashAttention 버전을 자동 선택합니다. 특정 백엔드를 검증할 때는 다음과 같이 명시할 수 있습니다.
# 기본값: 지원되는 백엔드를 자동 선택합니다.
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --max-model-len 4096 \
  --max-num-batched-tokens 8192 \
  --max-num-seqs 128

# 비교 실험에서 FlashAttention과 버전을 명시하는 예시입니다.
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --attention-backend FLASH_ATTN \
  --attention-config.flash_attn_version=3 \
  --max-model-len 4096 \
  --max-num-batched-tokens 8192 \
  --max-num-seqs 128
FlashAttention 2, 3과 4의 지원 범위는 GPU compute capability와 데이터 타입에 따라 다릅니다. 현재 옵션과 자동 선택 기준은 vLLM Attention Backend 문서에서 확인해야 합니다. 처음에는 자동 선택으로 측정하고, 동일한 모델·정밀도·트래픽에서 TTFT, ITL과 처리량을 비교해 변경 여부를 결정합니다.
PagedAttention
KV 캐시는 요청이 생성한 토큰 수에 따라 실행 중에도 계속 증가합니다. 입력 길이는 요청마다 다르고 출력 길이는 미리 알 수 없으므로, 요청별 최대 크기를 연속된 메모리로 미리 할당하면 사용하지 않는 예약 공간과 내·외부 파편화가 커집니다.
PagedAttention은 운영체제의 페이징에서 아이디어를 가져와 KV 캐시를 고정 크기의 논리 block으로 나눕니다. block table은 각 논리 block을 GPU 메모리의 물리 block에 매핑합니다. 물리 block은 서로 붙어 있을 필요가 없고 토큰이 늘어날 때 필요한 만큼 추가할 수 있습니다.
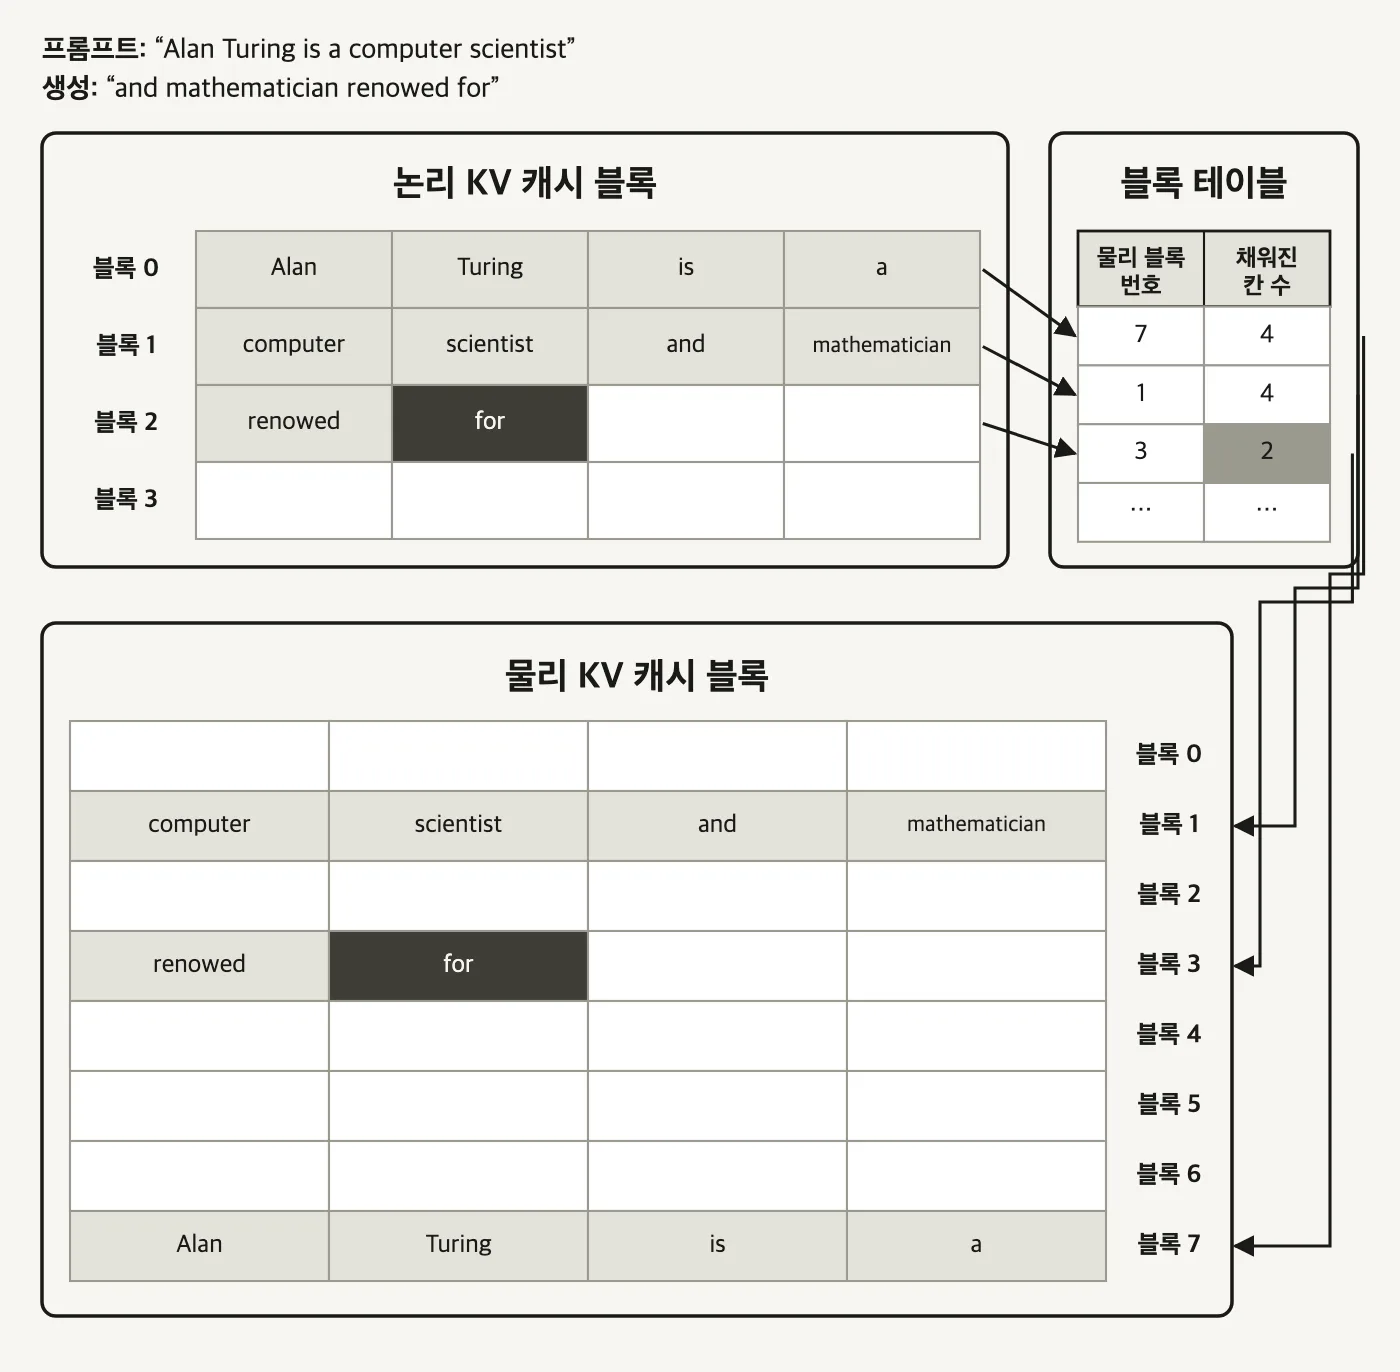
그림 26에서는 논리 block 0, 1, 2가 물리 block 7, 1, 3에 저장됩니다. block 하나에는 최대 네 토큰이 들어가며 마지막 block은 생성 중이라 두 칸만 사용합니다. 이 배치는 예시이고 실제 block 크기는 서빙 엔진 설정과 구현에 따라 달라집니다.
PagedAttention 원 논문은 기존 시스템에서 예약된 KV 캐시 메모리 중 실제 토큰 상태를 저장하는 비율이 20.4%에서 38.2%에 불과했으며, vLLM과 PagedAttention의 block 단위 관리로 KV 캐시 낭비를 거의 0에 가깝게 줄였다고 보고했습니다. 측정 조건과 구현은 PagedAttention 원 논문에서 확인할 수 있습니다.
PagedAttention은 KV 캐시가 GPU 메모리에 저장되고 할당되는 방식을 바꾸는 메모리 관리 기법입니다. 연산을 합치는 커널 퓨전이나 타일링을 적용하는 FlashAttention과 최적화 대상이 다르며, paged KV cache를 읽을 수 있는 어텐션 커널과 함께 동작합니다. vLLM에서는 이 block 기반 KV 캐시 관리가 기본 구조이므로 일반적인 서빙에서 별도의 기능 플래그로 켜지 않습니다.
세 기법은 서로 다른 관점에서 GPU 메모리 병목을 완화합니다.
| 기법 | 최적화 대상 | 주요 효과 |
|---|---|---|
| 커널 퓨전 | 연속된 연산과 중간 결과 | 커널 실행과 글로벌 메모리 왕복 감소 |
| FlashAttention | 어텐션 알고리즘과 HBM I/O | |
| PagedAttention | KV 캐시의 물리적 배치와 할당 | 메모리 파편화와 사전 예약 낭비 감소 |
MHA·MQA·GQA·MLA는 모델 아키텍처에 포함된 구조입니다. 일반적인 서빙 옵션으로 교체하기 어려우므로 KV 캐시와 품질 특성을 고려해 적합한 모델을 선택해야 합니다. MHA·GQA·MQA 계열은 config.json의 num_attention_heads와 num_key_value_heads를 비교해 확인할 수 있습니다.
커널 퓨전과 FlashAttention은 서빙 프레임워크와 실행 백엔드에서 적용됩니다. 동일한 모델도 PyTorch 기본 커널, FlashAttention과 FlashInfer 등 어떤 백엔드로 실행하는지에 따라 성능이 달라질 수 있습니다. 모델 구조와 GPU, 데이터 타입의 호환성을 확인하고 자동 선택 결과와 후보 백엔드를 벤치마크합니다.
PagedAttention은 서빙 엔진의 KV 캐시 메모리 관리 방식입니다. vLLM 같은 엔진에서는 내부 기본 구조로 사용되며, 사용자는 max_model_len, max_num_seqs와 KV 캐시 메모리 설정을 조정해 동시 처리량과 컨텍스트 길이를 튜닝합니다.
실무에서는 KV 캐시가 효율적인 모델 선택 → 연속 배칭과 paged KV cache를 지원하는 서빙 엔진 선택 → 호환되는 어텐션 커널 확인 → TTFT·ITL·처리량 비교 순서로 접근할 수 있습니다.
모델 압축 - 양자화와 증류를 중심으로 살펴보기
앞에서는 배칭으로 요청을 처리하는 방법과 어텐션 연산·메모리 접근을 최적화하는 방법을 살펴봤습니다. 이제 모델 자체의 크기와 연산량을 줄이는 방법으로 범위를 넓혀보겠습니다.
LLM의 큰 크기는 높은 GPU 비용과 제한된 하드웨어 가용성으로 이어집니다. 모델 압축은 품질 손실을 허용 가능한 수준으로 관리하면서 메모리 사용량, 데이터 이동량과 연산량을 줄이는 프로덕션 최적화 전략입니다. 이를 통해 더 작은 GPU나 엣지 장치에 모델을 배포하고, 같은 하드웨어에서 더 많은 요청을 처리할 수 있습니다.
모델 압축은 크게 양자화, 증류, 가지치기로 나눌 수 있습니다.

따라서 이 절에서는 양자화를 중심으로 원리와 서빙 효과를 살펴보고, 이후 증류와 가지치기의 역할을 간단히 비교합니다.
양자화(Quantization)
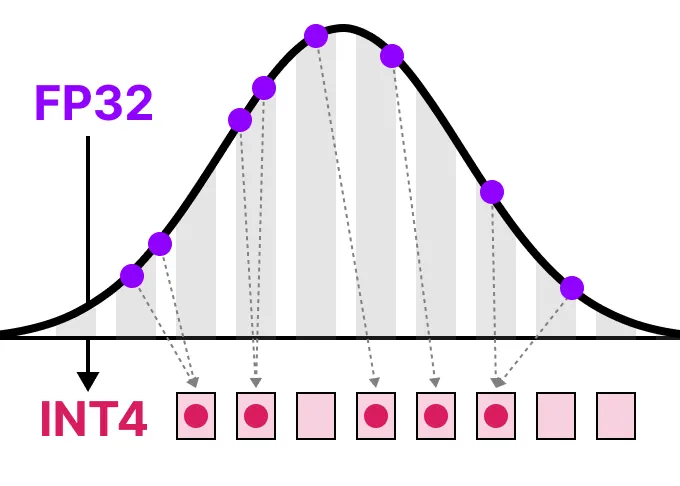
양자화는 모델의 가중치, 활성화 또는 KV 캐시를 FP32·FP16·BF16 같은 고정밀 포맷에서 FP8·INT8·FP4·INT4 같은 저비트 포맷으로 변환하는 기법입니다. 하나의 값을 표현하는 비트 수를 줄여 메모리 사용량과 데이터 이동량을 절감하는 대신, 원래 값을 얼마나 잘 보존할 수 있는지 확인해야 합니다.
숫자 포맷의 범위와 정밀도
부동소수점 포맷은 부호, 지수부, 가수부로 구성됩니다.
- 부호 비트는 값의 양수와 음수를 구분합니다.
- 지수부는 표현할 수 있는 값의 범위인 동적 범위(dynamic range)에 큰 영향을 줍니다.
- 가수부는 인접한 값을 얼마나 촘촘하게 구분할 수 있는지, 즉 정밀도에 큰 영향을 줍니다.
| 포맷 | 전체 비트 | 부호 | 지수부 | 가수부 | 최대 유한값의 크기 |
|---|---|---|---|---|---|
| FP32 | 32 | 1 | 8 | 23 | 약 |
| BF16 | 16 | 1 | 8 | 7 | 약 |
| FP16 | 16 | 1 | 5 | 10 |
FP16과 BF16은 모두 16비트지만 비트 배분이 다릅니다. BF16은 FP32와 같은 8비트 지수부를 사용해 비슷한 동적 범위를 유지하고, FP16은 더 많은 가수부 비트로 제한된 범위 안의 값을 더 세밀하게 표현합니다.
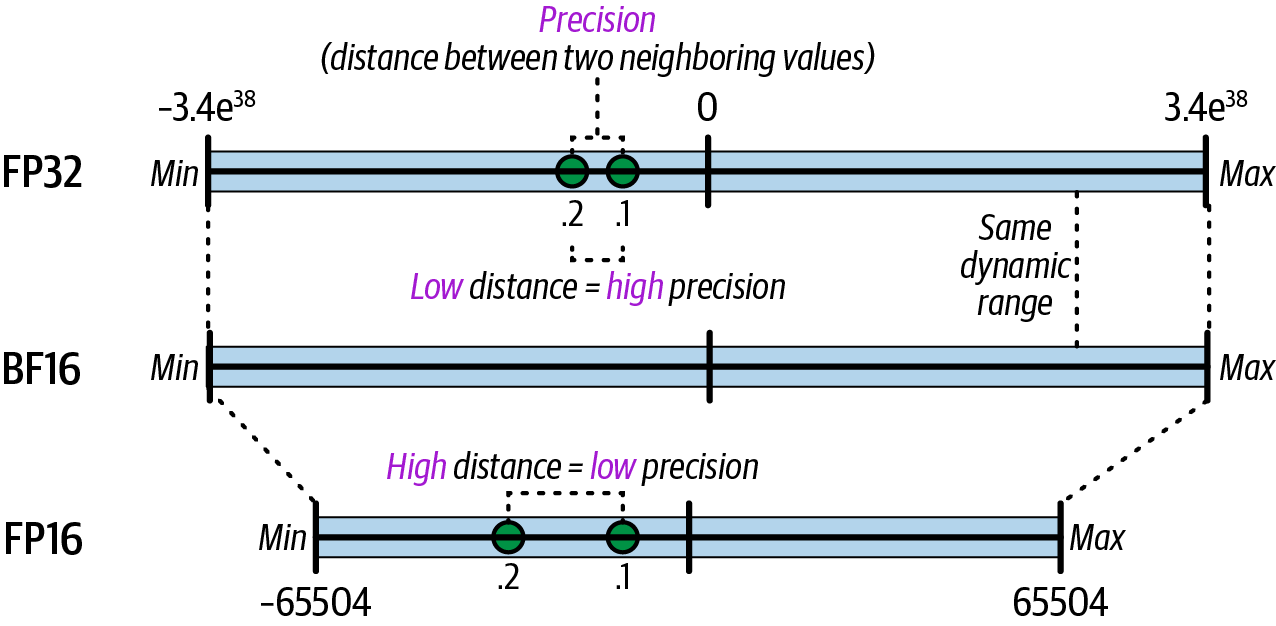
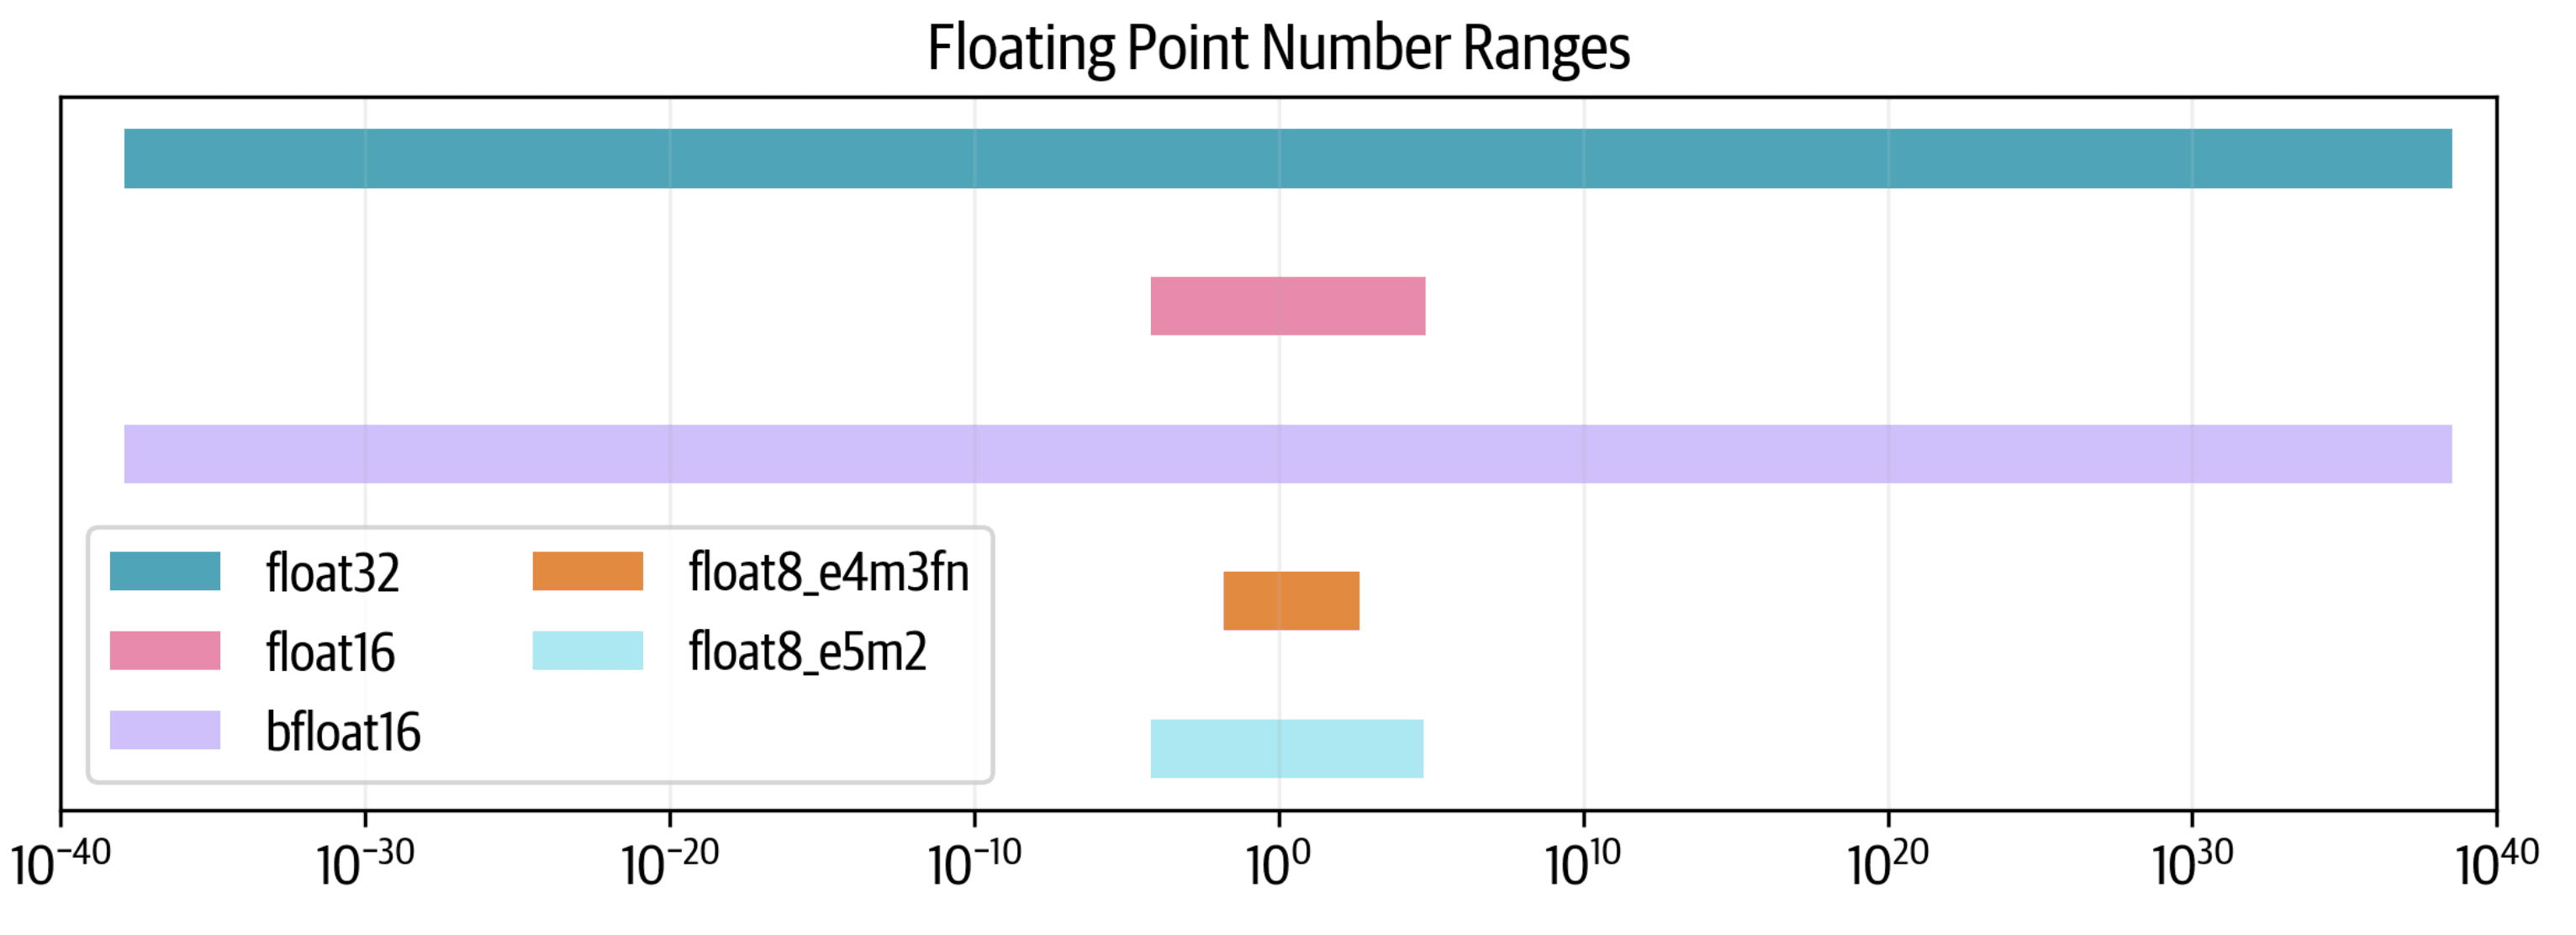
같은 구간에서도 가수부가 짧을수록 표현 가능한 값 사이의 간격이 넓어집니다. 그림 31에서 FP8은 1과 2 사이를 FP16·BF16보다 훨씬 적은 값으로 표현합니다.
양자화 오차와 스케일링
저비트 포맷으로 변환할 때는 주로 두 종류의 오차가 생깁니다.
- **반올림 오차(rounding error)**는 원래 값을 저비트 포맷으로 정확히 표현하지 못해 가까운 값에 대응시키면서 발생합니다.
- **클램핑 오차(clamping error)**는 스케일링된 값이 포맷의 표현 범위를 벗어나 최댓값이나 최솟값으로 잘리면서 발생합니다. 극단값이 많으면 왜곡이 커질 수 있습니다.
정수 양자화는 보통 스케일 팩터
여기서
INT와 FP 기반 저비트 포맷
INT8·INT4는 스케일이 정해지면 양자화 구간 안의 값이 일정한 간격으로 배치됩니다. FP8·FP4는 지수부를 사용하므로 값의 간격이 일정하지 않습니다. 0에 가까운 영역은 비교적 촘촘하고 값의 크기가 커질수록 간격도 넓어집니다.
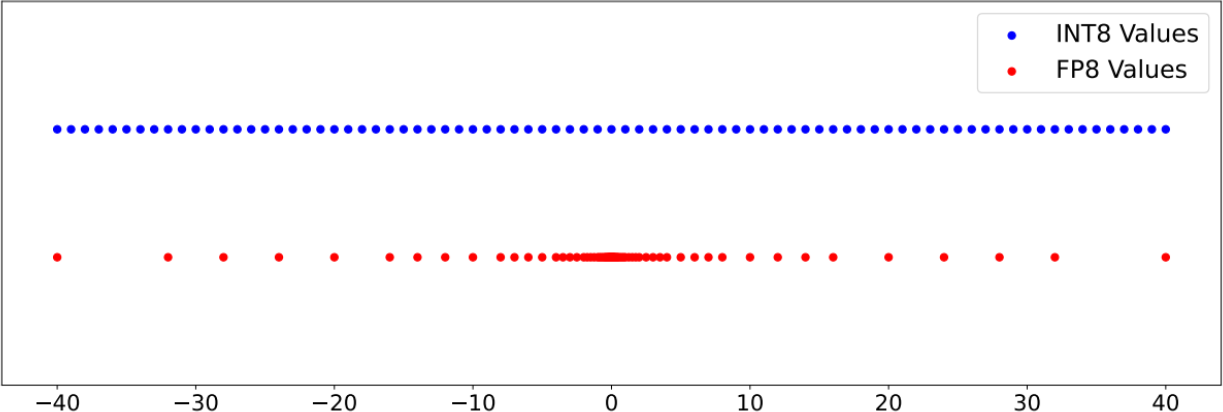
따라서 같은 비트 수라도 어느 포맷이 더 정확한지는 가중치와 활성화의 분포, 이상치의 크기, 스케일링 단위에 따라 달라집니다.
양자화가 서빙에 주는 효과
- 모델 크기 감소
- 70억 개의 가중치를 BF16으로 저장하면 약 14GB가 필요합니다. 이론적인 원시 데이터 크기는 INT8에서 약 7GB, INT4에서 약 3.5GB로 줄어듭니다.
- 실제 체크포인트에는 스케일과 메타데이터가 포함되므로 파일 크기는 이 계산보다 조금 커질 수 있습니다.
- 남은 GPU 메모리는 KV 캐시와 더 큰 배치에 사용할 수 있습니다. 가중치만 양자화했을 때 KV 캐시 자체의 크기는 줄어들지 않습니다.
- 데이터 이동량 감소
- 한 번의 디코드 iteration에서 HBM으로부터 읽어야 할 가중치가 작아집니다. 메모리 대역폭 제한이 강한 워크로드의 지연시간과 처리량을 개선할 수 있습니다.
- 모델을 단일 GPU나 노드에 배치할 수 있게 되면 GPU·노드 간 통신도 피할 수 있습니다.
- 연산 처리량 향상 가능
- 저정밀 행렬 연산을 지원하는 Tensor Core와 최적화된 커널을 사용하면 같은 시간에 더 많은 연산을 수행할 수 있습니다.
- 지원되는 데이터 타입, GPU 세대, 커널과 행렬 크기가 맞아야 하므로 비트 수를 절반으로 줄였다고 실제 처리량이 항상 두 배가 되지는 않습니다.
Weight-only와 Weight-and-Activation 양자화
W4A16은 가중치를 4비트, 활성화를 16비트로 처리한다는 뜻입니다. W8A8은 가중치와 활성화를 모두 8비트로 처리합니다. KV 캐시 정밀도는 이 표기에 포함되지 않으며 별도로 설정합니다.
| 구분 | W4A16 | W8A8 |
|---|---|---|
| 양자화 대상 | 가중치 | 가중치와 활성화 |
| FP16 대비 원시 가중치 크기 | 약 75% 감소 | 약 50% 감소 |
| 주된 이점 | 모델 적재 용량과 HBM 데이터 이동량 절감 | 데이터 이동량 절감과 저정밀 행렬 연산 활용 |
| 추가 비용 | 가중치 언패킹·역양자화 또는 혼합 정밀도 커널 | 활성화 스케일 계산과 양자화 오버헤드 |
| 대표 방식 | AWQ, GPTQ | INT8·FP8 기반 W8A8 |
Weight-only 방식은 압축된 가중치를 실행 중에 풀어 계산 포맷으로 변환합니다. Marlin이나 Machete 같은 혼합 정밀도 커널은 이 과정을 행렬 곱셈과 가깝게 결합해 중간 데이터 이동과 오버헤드를 줄입니다. 이 경우에도 변환 자체가 사라지는 것은 아니며, 실제 성능은 GPU와 지원 커널에 따라 달라집니다.
활성화 값은 요청과 레이어마다 달라집니다. 동적 스케일링은 실행 중 관측한 값으로 스케일을 계산해 입력 변화에 잘 대응하지만 계산 비용이 추가됩니다. 정적 스케일링은 대표 캘리브레이션 데이터로 스케일을 미리 정해 실행 비용을 줄이며, 실제 트래픽 분포와 캘리브레이션 데이터가 다르면 오차가 커질 수 있습니다.
FP8 포맷과 하드웨어 지원
FP8에는 대표적으로 E4M3와 E5M2가 있습니다. E4M3는 가수부가 하나 더 많아 정밀도가 높고, E5M2는 지수부가 하나 더 많아 동적 범위가 넓습니다. FP8 형식 논문은 두 포맷을 딥러닝 연산에 맞춰 제안했으며, NVIDIA Transformer Engine은 E4M3의 최대 유한값을 448, E5M2를 57,344로 설명합니다.
| FP8 포맷 | 전체 비트 | 부호 | 지수부 | 가수부 | 특성 |
|---|---|---|---|---|---|
| E4M3 | 8 | 1 | 4 | 3 | 높은 정밀도, 좁은 범위 |
| E5M2 | 8 | 1 | 5 | 2 | 낮은 정밀도, 넓은 범위 |
FP8의 제한된 범위는 스케일링으로 보완합니다. 예를 들어 블록별 스케일링은 작은 데이터 블록마다 별도의 스케일을 적용해 이상치가 나머지 값의 정밀도를 지나치게 떨어뜨리는 문제를 줄입니다. 자세한 동작은 NVIDIA Transformer Engine의 FP8 스케일링 문서에서 확인할 수 있습니다.
FP8의 속도 이득을 얻으려면 네이티브 FP8 연산을 지원하는 GPU와 커널이 필요합니다. NVIDIA H100 같은 Hopper 계열과 이후 세대는 FP8 Tensor Core를 제공하지만, A100 같은 Ampere GPU는 네이티브 FP8 Tensor Core가 없습니다. 서빙 엔진의 양자화 호환성 표에서 모델 포맷과 GPU 세대가 실제로 지원되는지 먼저 확인해야 합니다.
모델을 한 GPU나 노드에 적재하기 어렵거나 디코드의 가중치 읽기가 병목이면 W4A16 같은 Weight-only 방식을 먼저 검토할 수 있습니다. 높은 배치의 Prefill과 행렬 연산 처리량까지 개선하려면 하드웨어가 지원하는 W8A8·FP8 방식을 함께 비교합니다.
최종 선택은 모델 품질 평가와 실제 워크로드 벤치마크로 결정합니다. 동일한 양자화 포맷도 모델, GPU, 커널, 배치 크기와 입력·출력 길이에 따라 TTFT·ITL·처리량이 달라질 수 있습니다.
다른 양자화 기법들
KV 캐시와 어텐션 양자화
앞에서 살펴본 W4A16과 W8A8은 주로 Transformer의 선형 레이어에서 사용하는 가중치와 활성화를 대상으로 합니다. KV 캐시는 별도의 데이터 타입과 스케일을 사용하므로 따로 양자화해야 합니다.
KV 캐시를 FP16·BF16에서 FP8로 낮추면 같은 GPU 메모리에 더 많은 토큰을 저장할 수 있습니다. 긴 컨텍스트를 유지하거나 동시 요청 수가 많은 서빙에서 배치 크기와 처리량을 높일 수 있고, 뒤에서 살펴볼 프리픽스 캐싱에도 더 많은 공간을 제공할 수 있습니다.
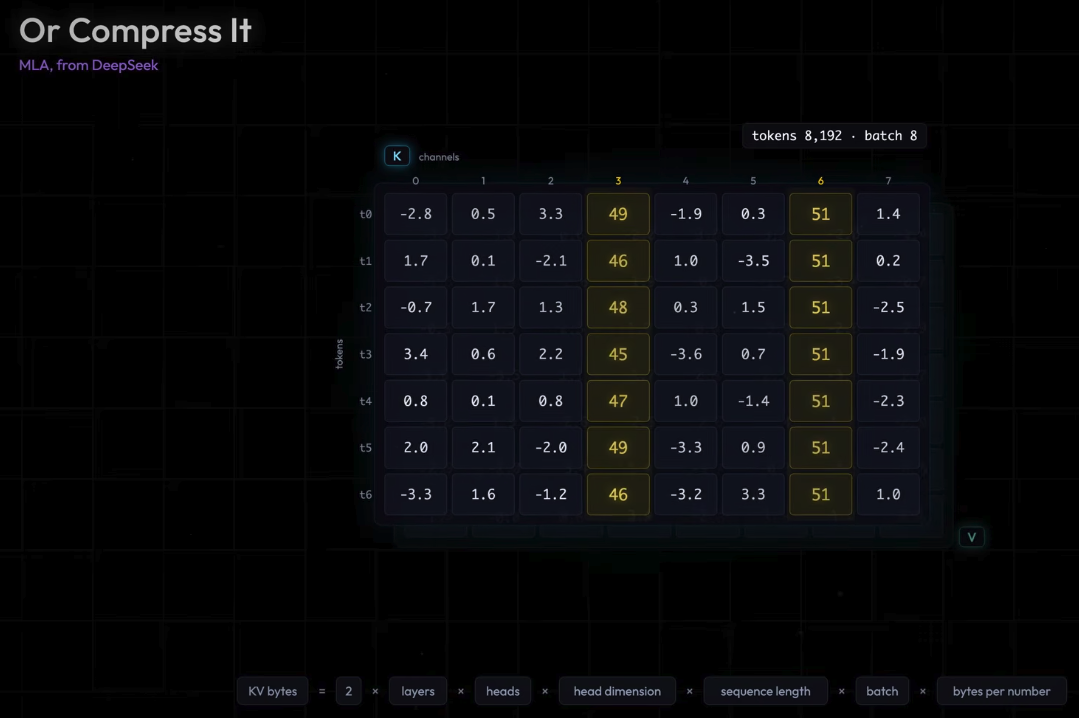
KV 캐시 양자화만 적용하면 메모리 사용량과 HBM 데이터 이동량은 줄지만, 어텐션 연산이 고정밀도로 실행될 때는 K·V를 다시 변환하는 비용이 생깁니다. FP8 어텐션 커널까지 지원하는 백엔드는 Q·K·V와 어텐션 연산을 FP8 영역에서 처리해 추가 효과를 얻을 수 있습니다. 예를 들어 vLLM은 FlashAttention 3 백엔드에서 FP8 KV 캐시를 사용하면 어텐션 연산과 Query도 FP8로 처리한다고 설명합니다.
실무에서는 가중치·활성화 양자화로 모델 크기와 선형 레이어의 비용을 먼저 줄이고, KV 캐시 용량이 병목인 긴 컨텍스트·고동시성 워크로드에서 FP8 KV 캐시와 어텐션 양자화를 추가로 검토할 수 있습니다. KV 캐시의 스케일링 단위와 캘리브레이션 데이터에 따라 품질과 속도가 달라지므로 실제 컨텍스트 길이로 평가해야 합니다.
GGUF와 로컬 추론
GGUF는 특정 양자화 알고리즘의 이름이 아니며, GGML 기반 실행기가 모델의 텐서와 메타데이터를 한 파일에 저장하고 빠르게 불러오기 위한 바이너리 파일 형식입니다. GGUF 파일에는 Q4·Q5·Q8처럼 서로 다른 양자화 타입의 텐서를 담을 수 있습니다.
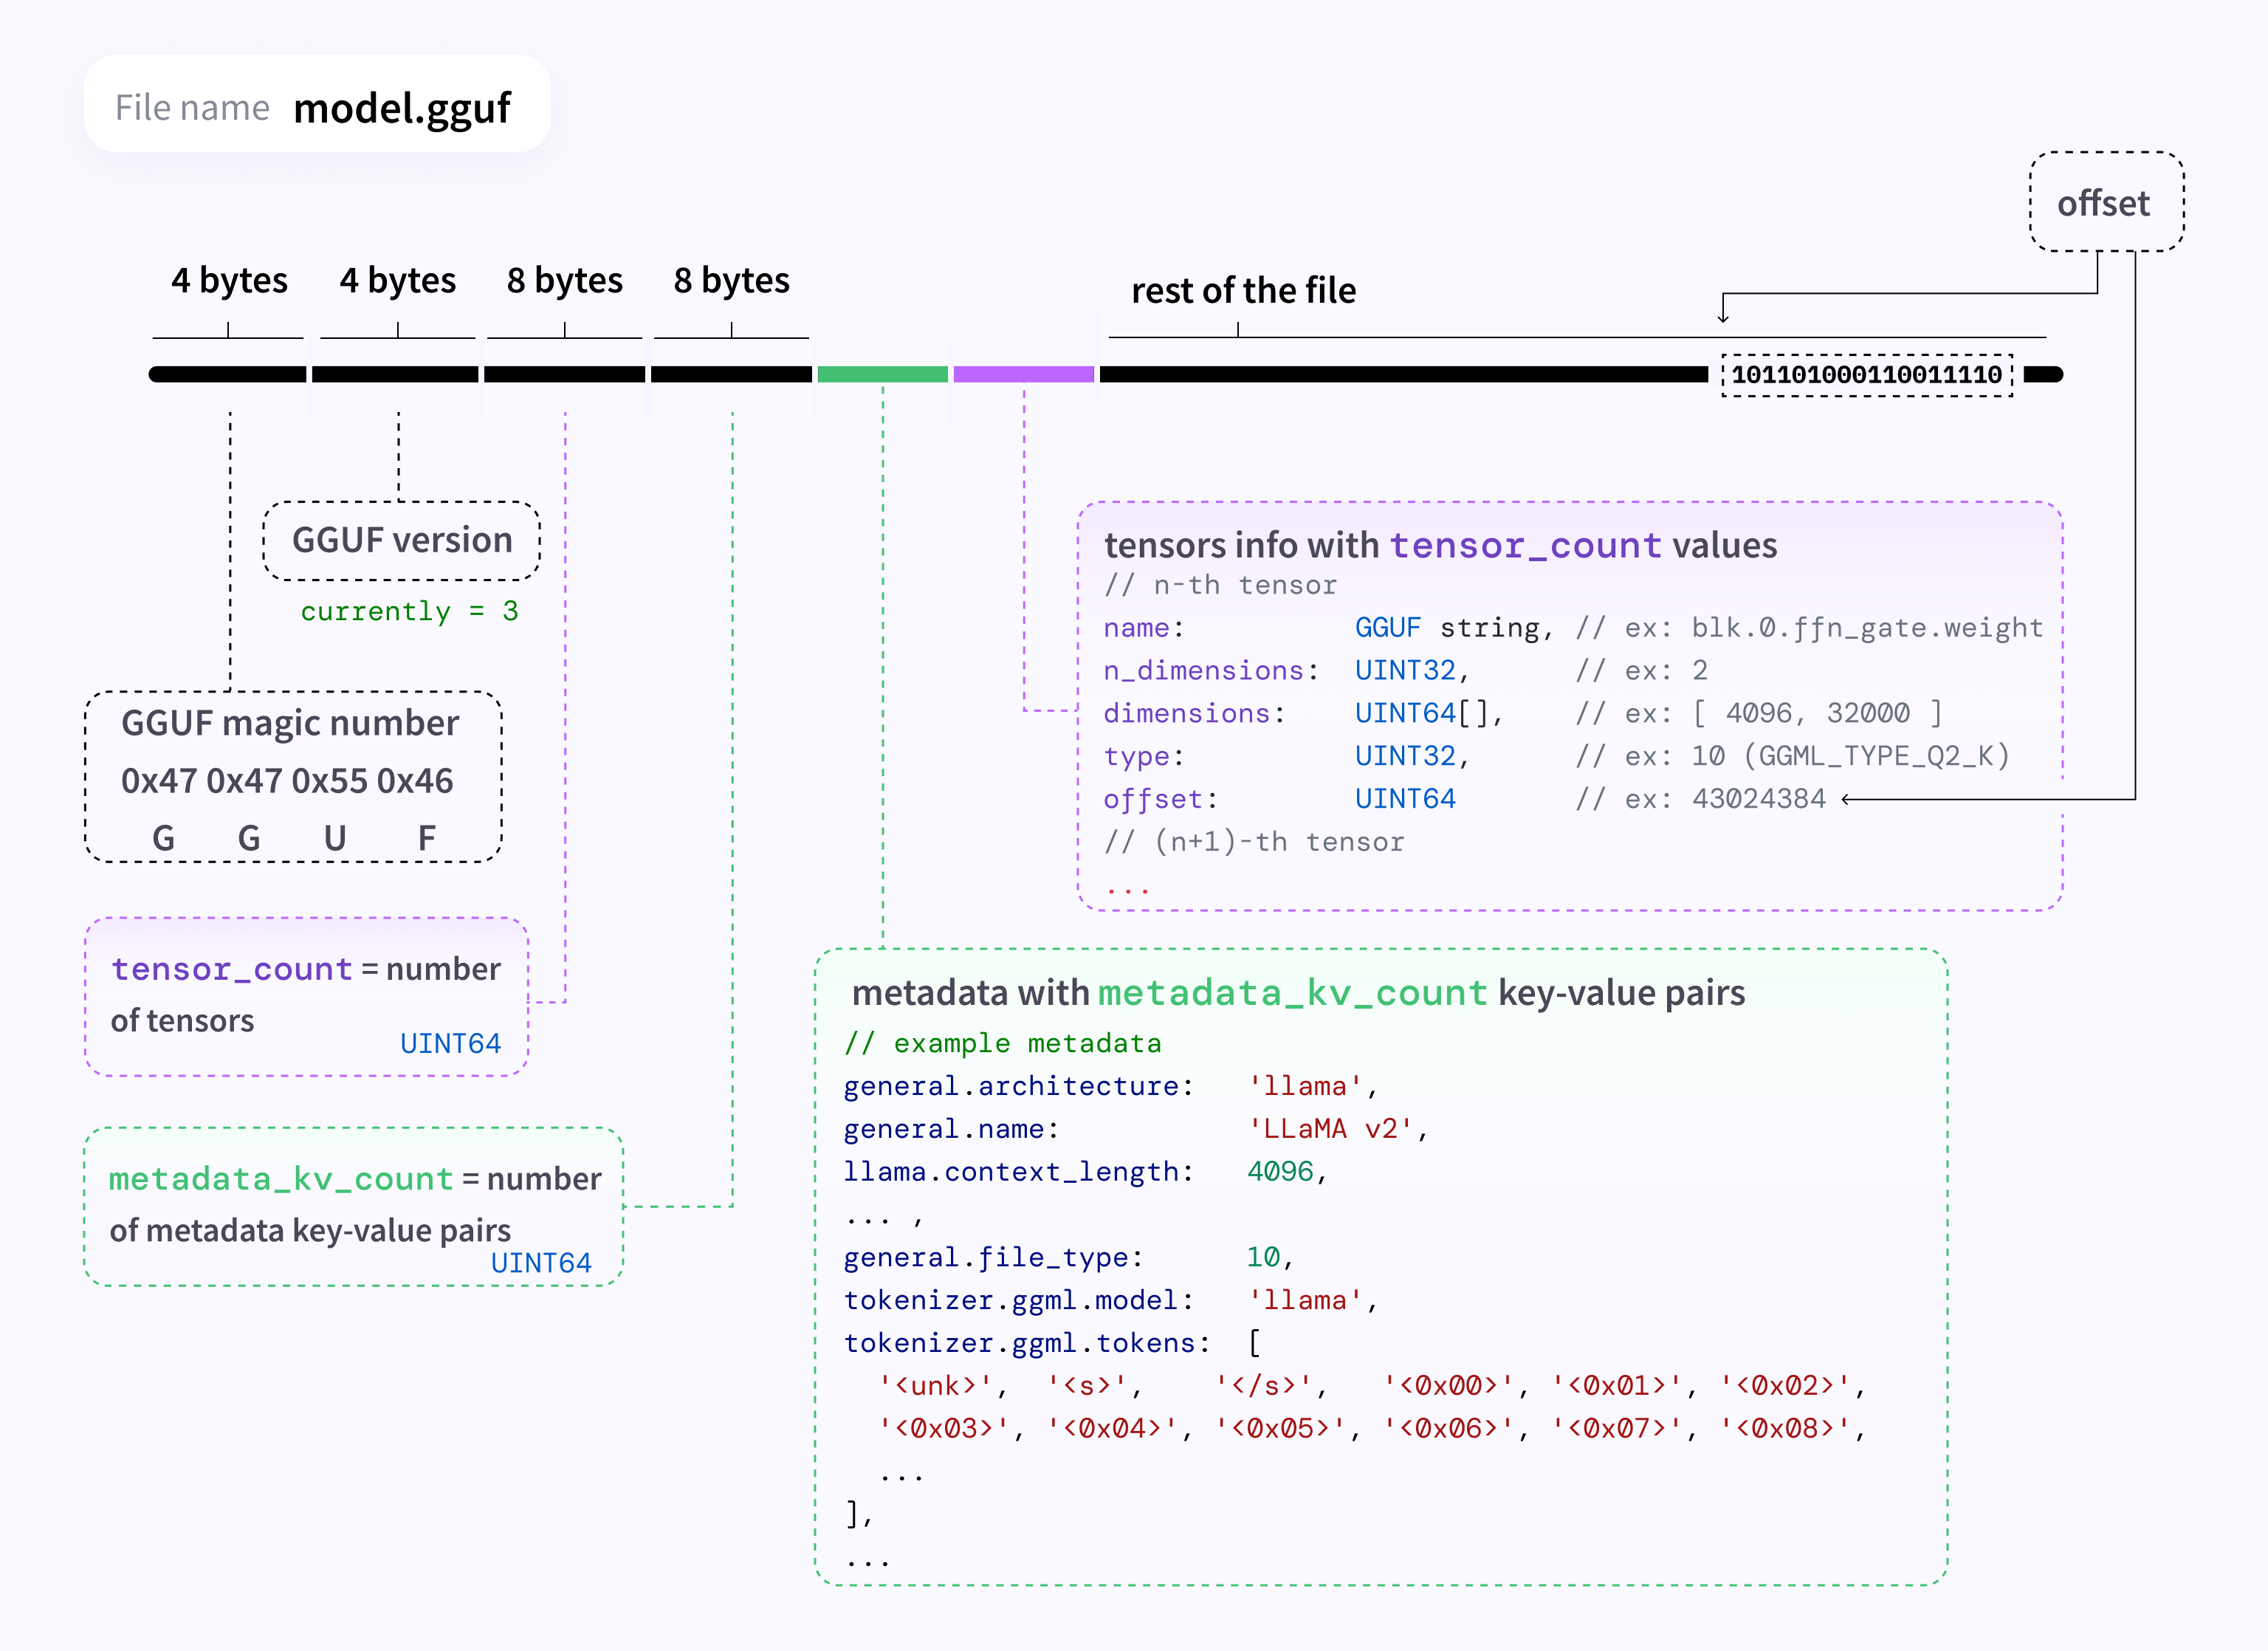
GGUF는 llama.cpp 생태계에서 CPU와 Apple Silicon의 Metal, CUDA·Vulkan 등 다양한 백엔드로 로컬 추론할 때 널리 사용됩니다. 모델 일부를 GPU에 올리고 나머지를 CPU에서 실행하는 혼합 오프로딩도 가능해, 전체 모델을 GPU 메모리에 담기 어려운 환경에서 유용합니다. 다만 데이터센터 GPU에서 최대 처리량을 목표로 할 때는 해당 GPU와 서빙 엔진에 최적화된 FP8·AWQ·GPTQ 체크포인트가 더 적합할 수 있으므로 별도로 벤치마크합니다.
정확도 트레이드오프와 평가
양자화는 표현 가능한 값의 수를 줄이므로 모델 품질과 서빙 효율 사이에 트레이드오프가 생깁니다. 그림 36의 Llama 3.1 평가에서는 잘 조정된 W8A8-FP8, W8A8-INT8과 W4A16이 BF16에 가까운 평균 점수를 보였습니다. 이 결과는 특정 모델 계열, 양자화 레시피와 벤치마크에서 측정한 값이며 모든 모델과 작업에 그대로 적용되지는 않습니다.
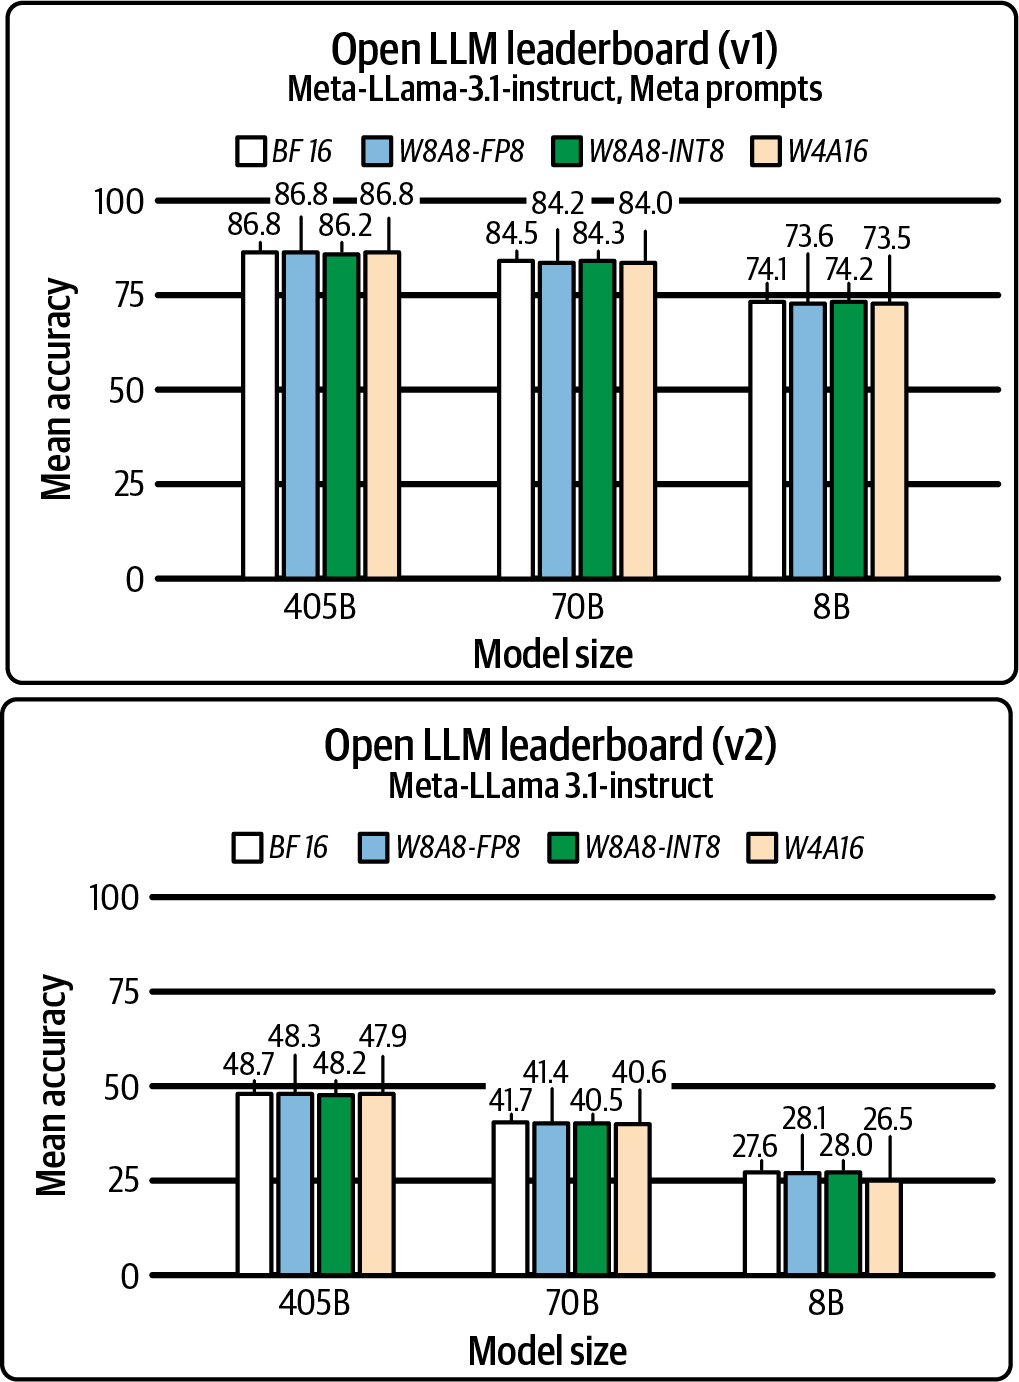
모델 크기만으로 양자화 민감도를 단정하기는 어렵습니다. 레이어별 이상치, 어텐션 구조, 스케일링 단위, 캘리브레이션 데이터와 평가 작업이 함께 영향을 줍니다. 특히 KV 캐시 양자화는 짧은 벤치마크에서 문제가 드러나지 않더라도 긴 컨텍스트의 검색·추론 품질에 영향을 줄 수 있습니다.
양자화 전후 모델은 동일한 프롬프트, 디코딩 설정과 평가 데이터로 비교합니다. LM Evaluation Harness를 사용한다면 다음처럼 모델 경로를 pretrained 인수로 전달할 수 있습니다.
lm_eval --model vllm \
  --model_args pretrained=Qwen/Qwen2-7B-Instruct \
  --tasks gsm8k_cot \
  --device cuda:0 \
  --batch_size auto
평균 점수만 확인하기보다는 서비스에서 중요한 정확성, 긴 컨텍스트 회수율, 도구 호출 형식과 생성 안정성을 함께 평가해야 합니다. TTFT·ITL·처리량과 GPU 메모리 사용량도 같은 부하 조건에서 측정합니다.
PTQ와 양자화 인식 훈련
훈련 후 양자화(Post-Training Quantization, PTQ)는 이미 학습된 모델에 양자화를 적용합니다. 양자화 인식 훈련(Quantization-Aware Training, QAT)은 학습이나 파인튜닝 중 양자화와 역양자화 오차를 모사해 저비트 표현에 적응시킵니다.
| 구분 | PTQ | QAT |
|---|---|---|
| 적용 시점 | 훈련 완료 후 | 훈련 또는 파인튜닝 중 |
| 준비 작업 | 변환, 필요시 캘리브레이션 | 학습 파이프라인과 데이터 필요 |
| 장점 | 빠른 도입과 높은 배포 유연성 | 공격적인 저비트에서 품질 회복 가능 |
| 고려 사항 | 모델과 레시피에 따라 저비트 오차 증가 | 학습 비용과 특정 양자화 방식 의존성 증가 |
PTQ는 8비트와 잘 조정된 4비트 Weight-only 양자화에서도 좋은 품질을 낼 수 있어 프로덕션에서 널리 사용됩니다. QAT는 PTQ가 목표 품질을 만족하지 못하거나 FP4 이하의 강한 압축을 모델이 학습 과정에서 직접 견디도록 만들 때 검토합니다.
OpenAI의 gpt-oss는 양자화를 모델 배포 형식에 포함한 사례입니다. 공식 모델 카드에 따르면 두 모델은 후속 학습 과정에서 전체 파라미터의 90% 이상을 차지하는 MoE 가중치를 파라미터당 4.25비트의 MXFP4로 양자화했습니다.
| 모델 | 전체 파라미터 | 활성 파라미터 | 체크포인트 크기 | 메모리 목표 |
|---|---|---|---|---|
| gpt-oss-120b | 116.8B | 5.1B | 60.8GiB | 단일 80GB GPU |
| gpt-oss-20b | 20.9B | 3.6B | 12.8GiB | 16GB 메모리 시스템 |
이미 양자화된 체크포인트를 제공하므로 사용자가 별도의 양자화 레시피를 선택할 필요가 없습니다. 다만 체크포인트가 메모리에 들어가는 것과 MXFP4 연산을 네이티브로 가속하는 것은 구분해야 합니다.
하드웨어와 실행 백엔드에 따라 MXFP4를 직접 계산하거나 다른 포맷으로 변환할 수 있으므로, 실제 배포 환경의 지원 여부와 성능을 확인해야 합니다.
OpenAI가 발표한 모델 특성과 성능 비교는 gpt-oss 소개에서 확인할 수 있습니다.
가중치와 활성화 양자화로 모델 적재 크기와 기본 서빙 성능을 먼저 개선합니다.
긴 컨텍스트와 동시 요청 때문에 KV 캐시가 병목이면 KV 캐시·어텐션 양자화를 검토하고, 로컬 CPU·Apple Silicon 배포가 목표면 GGUF와 llama.cpp 계열을 비교합니다.
목표 품질을 PTQ로 달성하기 어려울 때는 QAT가 적용된 모델이나 별도의 QAT 파이프라인을 고려합니다.
증류(distillation)
증류는 큰 교사(teacher) 모델의 행동과 지식을 더 작은 학생(student) 모델에 학습시키는 방법입니다. 양자화가 같은 모델의 숫자 표현을 줄이는 방식이라면, 증류는 파라미터 수와 구조가 다른 새로운 학생 모델을 만듭니다. 학생 모델이 충분히 작아지면 필요한 GPU 수와 모델 가중치 읽기 자체가 크게 줄어 지연시간과 처리량을 개선할 수 있습니다.
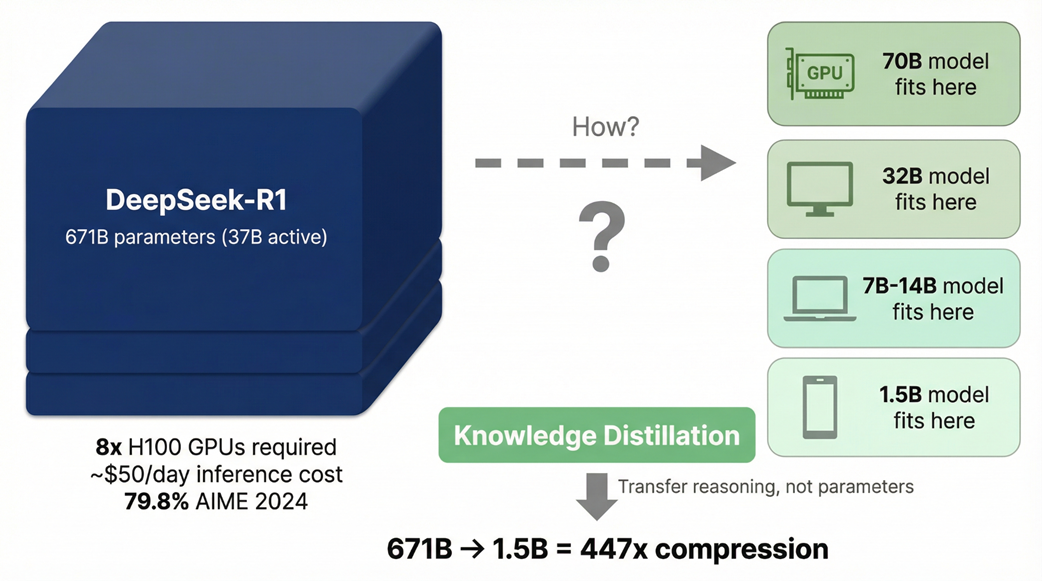
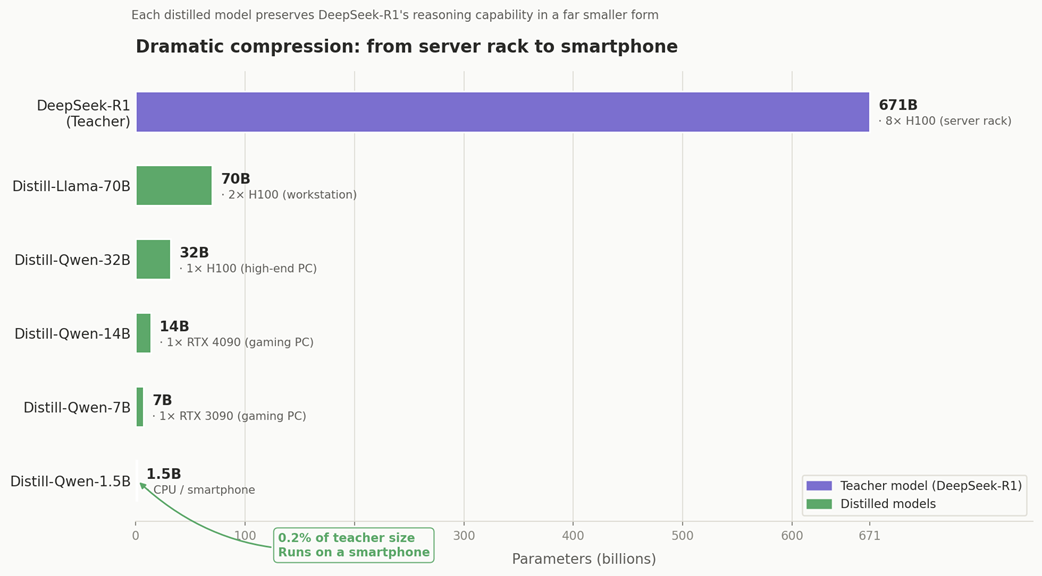
그림 37과 38의 장치·GPU 구성은 모델 크기 차이를 보여주는 예시입니다. 실제 적재 가능 여부와 속도는 정밀도, KV 캐시, 컨텍스트 길이와 실행 백엔드에 따라 달라집니다.
증류 파이프라인
증류에는 교사 모델로부터 얻을 수 있는 정보에 따라 여러 방식이 있습니다.
- 출력 증류(output distillation) 는 교사가 생성한 응답과 추론 과정을 학습 데이터로 저장하고, 이를 이용해 학생 모델을 파인튜닝합니다. 교사 API의 텍스트 출력만으로도 수행할 수 있습니다.
- 로짓 증류(logit distillation) 는 정답 토큰과 함께 교사의 확률 분포인 soft target을 학생이 모방하도록 학습합니다. 로짓이나 중간 표현에 접근해야 하므로 교사 모델에 더 깊은 접근 권한이 필요합니다.
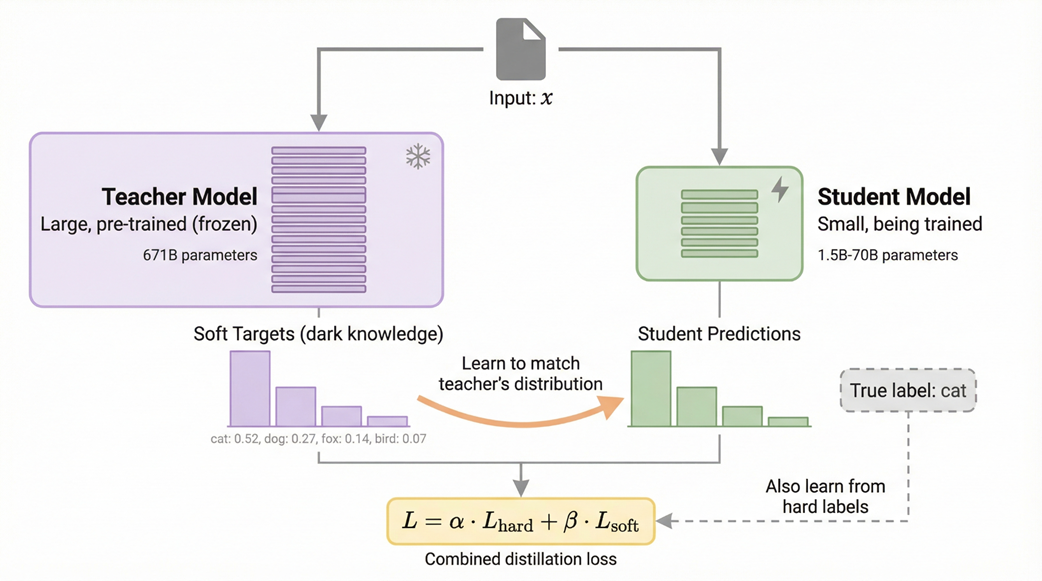
로짓 증류에서는 보통 학생의 정답 손실과 교사 분포를 모방하는 손실을 함께 사용합니다.
Soft target은 정답 외 토큰에 교사가 부여한 상대적인 확률까지 전달합니다. 학생은 hard label만 학습할 때보다 클래스와 토큰 사이의 유사성을 더 많이 배울 수 있습니다. 출력 증류는 이 정보가 적은 대신 폐쇄형 교사 API로도 데이터셋을 만들 수 있다는 장점이 있습니다.
DeepSeek-R1 증류 모델
DeepSeek-R1은 671B 전체 파라미터 중 토큰마다 약 37B가 활성화되는 MoE 모델입니다. DeepSeek는 R1이 생성한 80만 개 샘플로 Qwen2.5와 Llama 계열의 dense 학생 모델을 파인튜닝하고, 1.5B·7B·8B·14B·32B·70B 체크포인트를 공개했습니다. 이는 교사의 텍스트 출력과 추론 데이터를 이용한 출력 증류 사례입니다.
| 벤치마크 | DeepSeek-R1 671B | DeepSeek-R1-Distill-Llama-70B |
|---|---|---|
| MATH-500 pass@1 | 97.3 | 94.5 |
| GPQA Diamond pass@1 | 71.5 | 65.2 |
| LiveCodeBench pass@1 | 65.9 | 57.5 |
70B 학생 모델은 교사보다 파라미터가 약 10분의 1로 줄었으며, 표의 수학·과학·코딩 벤치마크에서도 상당한 성능을 유지했습니다. 수치는 DeepSeek-R1 공식 저장소의 평가 조건에 따른 결과이므로 실제 서비스 작업에서도 별도로 검증해야 합니다.
양자화와 증류의 선택 순서
| 구분 | 양자화 | 증류 |
|---|---|---|
| 변경 대상 | 기존 모델의 숫자 표현 | 새로 학습하는 작은 학생 모델 |
| 도입 비용 | PTQ는 비교적 낮음 | 데이터 생성과 학습 비용이 큼 |
| 품질 위험 | 잘 조정된 8·4비트에서 비교적 작을 수 있음 | 학생 크기와 데이터에 따라 더 커질 수 있음 |
| 서빙 효과 | 메모리와 데이터 이동량 감소 | 파라미터와 전체 연산량 감소 |
이미 검증된 증류 모델이 있다면 먼저 품질 기준을 확인하고 채택할 수 있습니다. 이후 학생 모델에 양자화를 추가하면 모델 크기와 데이터 이동량을 더 줄일 수 있습니다. 적합한 학생 모델이 준비되지 않았다면 PTQ를 먼저 시도하는 편이 도입 비용이 낮습니다. 직접 증류해야 할 때는 교사 출력 생성 비용, 학습 데이터 품질과 학생 모델 학습 비용까지 함께 계산합니다.
증류는 모델 구조 자체를 작게 만들어 큰 서빙 성능 향상을 얻을 수 있지만, 품질은 학생 모델의 크기와 증류 데이터에 좌우됩니다. 이미 만들어진 학생 모델을 평가하고, 품질 기준을 통과하면 양자화까지 조합하는 순서가 실용적입니다.
가지치기(pruning)
가지치기는 중요도가 낮은 가중치, 채널, 뉴런이나 어텐션 헤드를 제거해 모델을 희소하게 만드는 압축 기법입니다. LLM에는 중복된 파라미터가 많을 수 있지만, 값을 0으로 만드는 것만으로는 메모리 사용량이나 실행 시간이 자동으로 줄지 않습니다. 희소한 구조를 저장하고 계산할 수 있는 포맷, 커널과 하드웨어가 함께 필요합니다.
가지치기는 제거 단위에 따라 나눌 수 있습니다.
- **구조적 가지치기(structured pruning)**는 채널, 헤드, 블록처럼 규칙적인 단위를 제거합니다. 하드웨어가 처리하기 쉬운 형태를 만들 수 있지만 선택의 자유가 작아 품질 회복이 어려울 수 있습니다.
- **비구조적 가지치기(unstructured pruning)**는 개별 가중치를 자유롭게 제거합니다. 같은 희소율에서 중요한 값을 더 세밀하게 보존할 수 있지만, 불규칙한 메모리 접근 때문에 범용 GPU에서 실제 가속으로 이어지기 어렵습니다.
2:4 구조적 희소성
NVIDIA Ampere와 이후 아키텍처의 Sparse Tensor Core는 연속된 네 가중치 중 두 개만 남기는 2:4 패턴을 지원합니다. 이는 50% 희소성에 해당합니다.
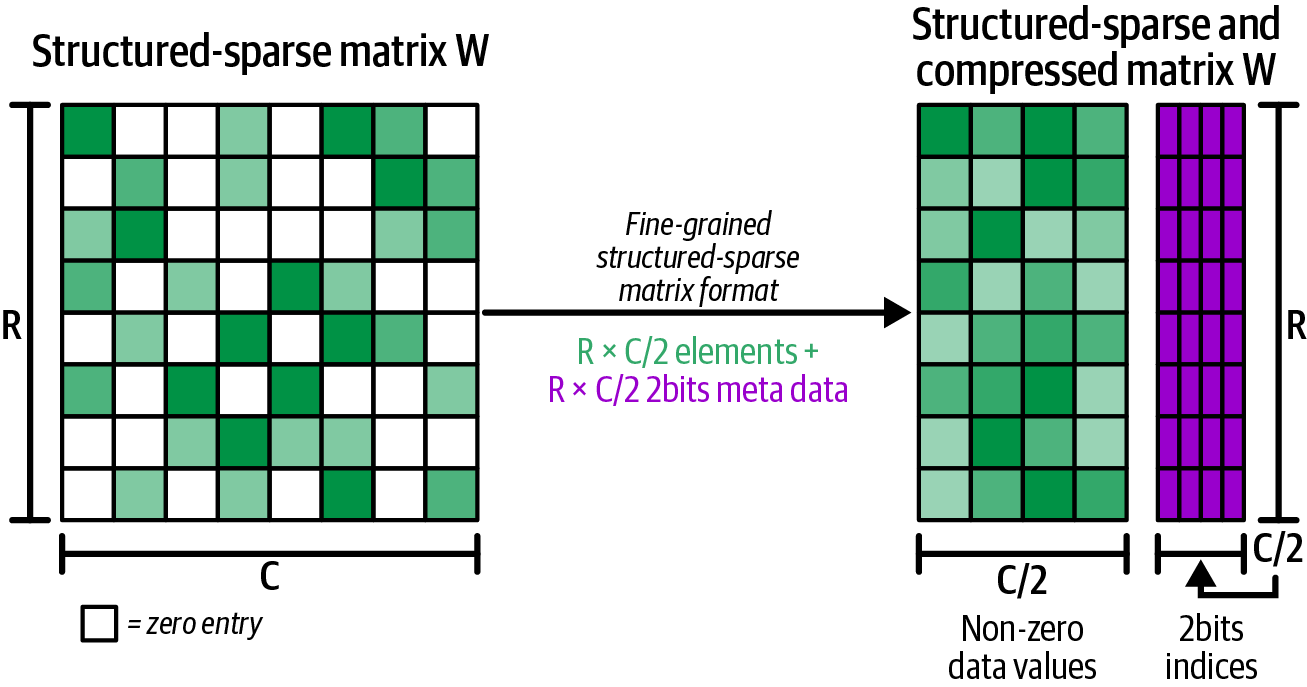
압축된 행렬에는 non-zero 값과 원래 위치를 나타내는 인덱스 메타데이터가 저장됩니다. 연산 전에 dense 행렬 전체를 복원하지 않으며, Sparse Tensor Core가 메타데이터로 필요한 활성화를 선택하고 0인 가중치의 곱셈을 건너뜁니다.
지원되는 행렬 곱셈에서 이론적인 연산 처리량은 dense Tensor Core 대비 최대 2배가 될 수 있습니다. 실제 모델의 종단 성능은 희소 커널이 적용되는 레이어 비율, 행렬 크기, 메모리 이동과 다른 연산의 비중에 따라 더 낮습니다. TensorRT도 문제 크기에 따라 dense 경로가 더 빠르면 이를 선택할 수 있습니다.
가지치기 직후에는 모델 품질이 떨어질 수 있으므로 남은 가중치를 파인튜닝하거나, 학습 중 희소 패턴을 적용해 품질을 회복하는 과정이 흔히 필요합니다. 이 추가 학습과 전용 실행 경로 때문에 범용 LLM 서빙에서 가지치기의 도입 범위는 양자화보다 좁습니다.
압축률만 확인해서는 실제 가속을 판단할 수 없습니다. 목표 GPU와 서빙 엔진이 해당 희소 패턴을 지원하는지 확인하고, 품질 회복 학습 후 dense 모델과 종단 지연시간·처리량을 비교해야 합니다.
Prefix caching
캐싱은 자주 사용하는 데이터를 빠른 저장소에 보관해 지연 시간을 줄이는 기법입니다. ML 서빙에서는 동일한 요청의 모델 출력을 저장해 두었다가 재사용하는 방식이 흔합니다[2]. 하지만 LLM은 자유형 텍스트를 입력으로 받으므로 같은 의도의 질문도 표현이 달라질 수 있고, 요청 전체를 기준으로 하면 캐시 적중률이 낮아지기 쉽습니다.

RadixCaching - 프롬프트 앞 부분을 캐시처리[3]
RadixAttention은 SGLang에서 사용하는 프리픽스 캐싱 구현입니다. 프롬프트 접두사를 라딕스 트리(radix tree, trie와 유사한 자료구조)로 관리해 여러 요청이 공유하는 구간을 빠르게 찾습니다.
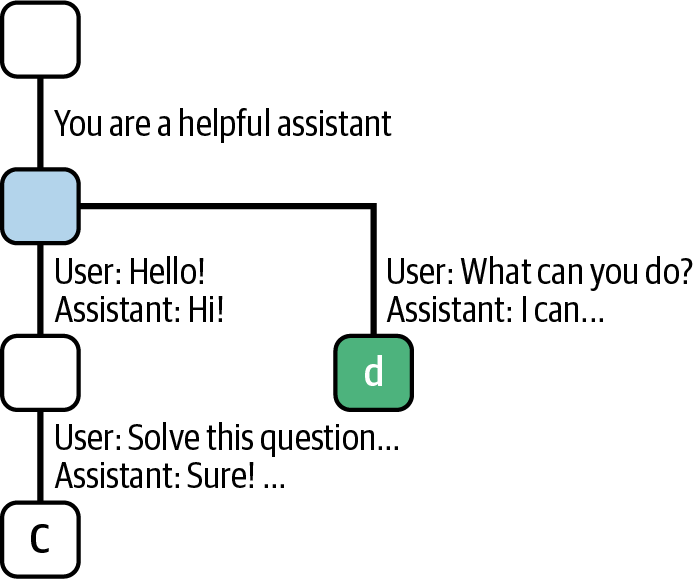
You are a helpful assistant처럼 공통으로 반복되는 토큰은 하나의 노드를 공유하고, 이후 사용자 입력부터 가지가 나뉩니다.- 트리의 메타데이터는 CPU에서 관리하고 각 노드는 GPU 메모리에 저장된 KV 캐시 블록과 연결됩니다. 캐시가 부족해지면 오래 사용하지 않은 리프 노드부터 LRU 방식으로 제거합니다.
- 요청이 들어오면 기존 트리에서 일치하는 가장 긴 접두사를 찾고, 일치한 구간은 다시 프리필하지 않습니다.
Prefix Caching 실전 사례
프리픽스 캐싱은 여러 요청이 동일한 토큰 접두사를 공유할 때 효과가 큽니다. 문장의 의미가 비슷한지만으로는 캐시 적중이 보장되지 않으므로, 공통으로 유지할 내용을 프롬프트 앞쪽에 배치하는 것이 중요합니다.

멀티턴 채팅
이전 대화 기록이 다음 요청의 앞부분에 그대로 이어지면, 이미 처리한 대화 구간의 KV 캐시를 재사용할 수 있습니다. 대화가 길어질수록 매번 다시 수행해야 하는 프리필이 줄어들어 TTFT 개선 효과가 커집니다.
긴 컨텍스트와 RAG
- 시스템 프롬프트, 공통 지시문, 정적 컨텍스트를 프롬프트 앞에 고정하면 여러 요청에서 같은 접두사를 공유할 수 있습니다.
- RAG 문서의 검색 결과 순서가 요청마다 바뀌면 접두사가 달라져 캐시 적중률이 낮아집니다. 문서 정렬 규칙과 직렬화 형식을 일정하게 유지해야 합니다.
- 사용자별 개인화 정보나 사용자·세션 ID를 앞부분에 넣으면 테넌트별 격리는 쉬워지지만, 여러 사용자가 접두사를 공유할 수 있는 범위는 줄어듭니다.
<system>
You are a helpful assistant.
<context>
Document: {stable context}
<user>
{dynamic question}
Prefix Caching 확장하기
단일 인스턴스의 캐시 용량
프리픽스 캐싱은 GPU 메모리에 KV 캐시를 오래 유지하므로, 캐시할 접두사가 길거나 종류가 많으면 모델 가중치와 함께 저장할 공간이 부족해질 수 있습니다. 캐시 용량과 적중률, KV 캐시 축출 빈도를 함께 확인해야 합니다.
여러 인스턴스와 캐시 인지 라우팅
트래픽이 늘면 여러 모델 인스턴스로 수평 확장합니다. 단순 라운드 로빈이나 최소 연결 방식은 같은 접두사를 서로 다른 인스턴스로 분산시켜 캐시 적중률을 낮출 수 있습니다. 캐시 인지 라우터는 요청 접두사와 각 인스턴스의 캐시 상태를 확인해 이미 해당 접두사를 보유한 인스턴스로 요청을 보냅니다.
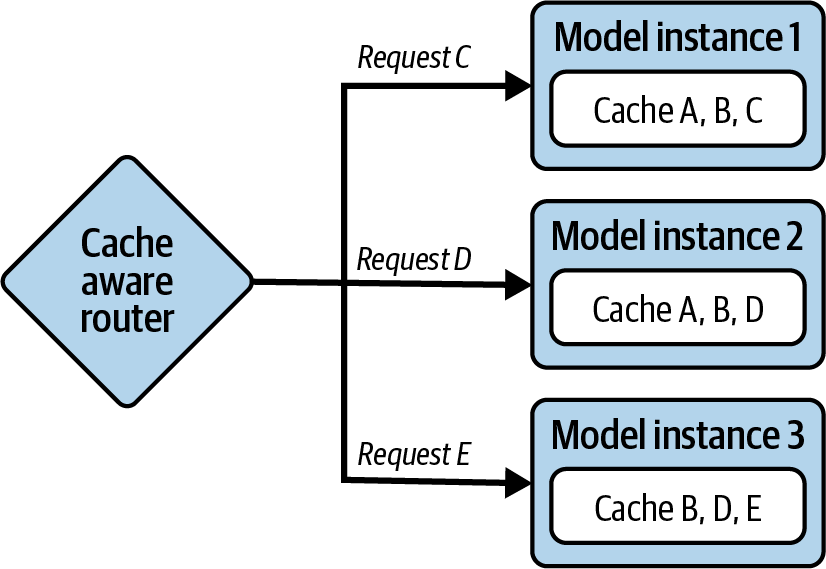
- 같은 접두사를 가진 후속 요청을 같은 인스턴스로 보내면 프리필 재계산을 줄일 수 있습니다.
- 모든 인스턴스가 모든 접두사를 저장할 필요가 없어 GPU 메모리와 캐시 축출 비용을 줄일 수 있습니다.
- GPU 메모리가 부족하면 KV 캐시를 CPU 메모리나 SSD로 오프로드할 수 있지만, 전송 지연과 운영 복잡도가 늘어납니다.
멀티테넌시 보안
여러 고객이 같은 인스턴스를 공유하면 캐시 적중 여부나 응답 지연을 통해 다른 고객의 접두사 존재를 추측할 가능성이 있습니다. 시스템 프롬프트와 고객별 컨텍스트 사이에 사용자 또는 세션별 고유 ID를 넣으면 고객 간 접두사 공유를 해당 시스템 프롬프트 구간으로 제한할 수 있습니다.
구현체별 차이
- SGLang: RadixAttention을 기본 프리픽스 캐싱 구현으로 사용하며, 라딕스 트리로 접두사를 관리합니다.
- vLLM: 라딕스 트리 대신 KV 캐시 블록을 해시로 매칭하는 자체 자동 프리픽스 캐싱을 제공합니다. 설정에서는
--enable-prefix-caching을 사용합니다.
현대적인 LLM 서빙 엔진에서는 프리픽스 캐싱을 기본 기능으로 제공하는 경우가 많습니다. 실제 워크로드에서는 캐시 적중률, TTFT, GPU 메모리 압력을 함께 측정해 캐시 용량과 라우팅 정책을 조정해야 합니다.
vLLM을 이용한 LLM 추론
해당 링크를 통해 접속하실 수 있습니다 - https://learn.kodekloud.com/learn/courses/youtube-labs-vllm
실습에 대한 소개 영상도 먼저 살펴보시면 좋습니다 - https://www.youtube.com/watch?v=qdPkA5mxLhg
끝으로
이번 장에서는 실제 배포 환경에서 LLM 서비스의 성능과 비용을 개선하는 방법을 살펴보았습니다. 요청을 어떻게 묶고, 어텐션과 메모리 접근을 어떻게 최적화하며, 모델 자체의 크기를 어떻게 줄이는지가 주요 주제였습니다.
온라인 서빙에서는 배칭으로 산술 강도를 높여 GPU 활용률과 처리량을 개선할 수 있습니다. 동적 배칭에서 출발해 연속 배칭으로 요청을 유연하게 교체하고, 긴 프롬프트는 청크 프리필로 나누어 TTFT와 ITL 사이의 균형을 조정합니다.
어텐션 측면에서는 MHA, MQA, GQA, MLA처럼 KV 캐시를 줄이는 구조를 비교했고, 커널 퓨전과 FlashAttention으로 메모리 왕복과 HBM 접근을 줄이는 방법을 살펴보았습니다. PagedAttention은 KV 캐시를 블록 단위로 관리해 메모리 파편화를 줄이고, 높은 메모리 활용률을 지원합니다.
모델 압축에서는 양자화, 증류, 가지치기의 차이와 적용 조건을 정리했습니다. 실무에서는 적용이 쉬운 사후 학습 양자화를 먼저 검토하고, 이미 검증된 증류 모델이나 하드웨어가 지원하는 희소성 패턴이 있으면 추가로 활용할 수 있습니다.
프리픽스 캐싱은 반복되는 프롬프트 접두사의 KV 캐시를 재사용해 프리필 계산과 TTFT를 줄이는 방법입니다. 멀티턴 채팅, 긴 컨텍스트, 반복되는 시스템 프롬프트와 RAG 문서에서 효과가 크며, 캐시 인지 라우팅을 사용하면 여러 모델 인스턴스에서도 재사용률을 유지할 수 있습니다.
이제 단일 GPU에서 소형 LLM을 효율적으로 서빙하는 데 필요한 기본 원리를 갖추었습니다. 다음 장에서는 여러 GPU와 노드에 대규모 LLM을 분산하는 방법을 살펴보고, 개별 모델 복제본을 넘어 시스템 전체의 성능과 운영을 최적화하는 방안을 살펴보겠습니다.
참고링크: https://medium.com/@dk02315/llm-why-attention-is-expensive-and-how-gqa-mla-kv-cache-economize-the-cost-81459f8d6623 ↩︎
예를 들어 Triton Inference Server는 요청 전체를 해시해 캐시 키로 사용할 수 있습니다. ↩︎
SGLang의 구현체 용어입니다. SGLang 공식문서 , vLLM-Production-Stack 문서 ↩︎